
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Агента для работы с кодом научили сокращать накопленную историю по ходу задачи, а не только при переполнении окна контекста. Хотя работу Xuan Zhang и коллег не рецензировали и цифры получили сами авторы, на SWE-bench Verified доля решённых задач выросла на 9,2 процентного пункта относительно той же базовой модели. Для команд, которые строят агентов-разработчиков, сжатие становится частью поведения модели, а не аварийной очисткой памяти.
Сжатие привязали к этапам работы, а не к числу токенов
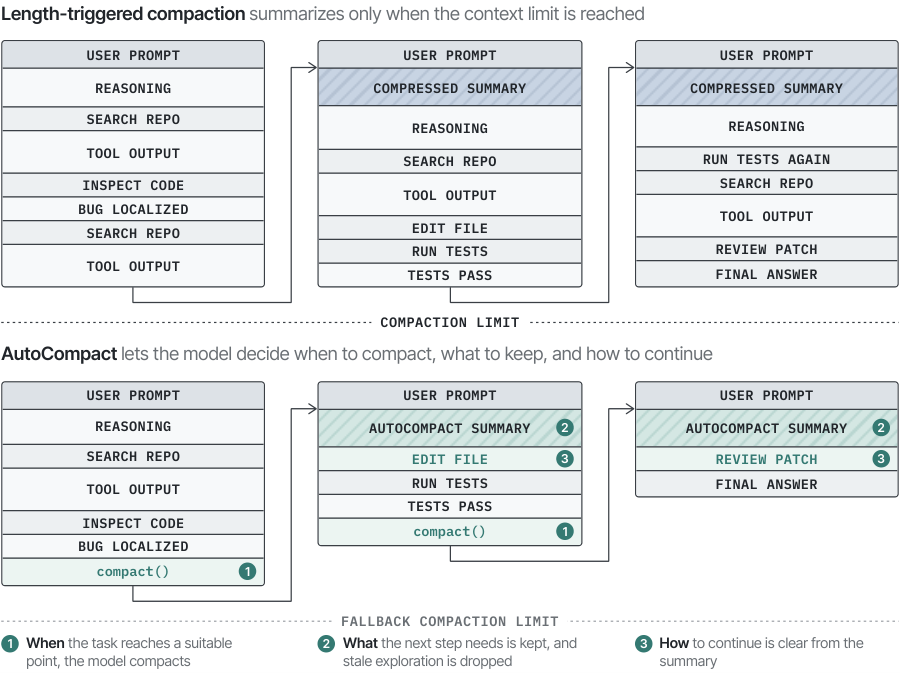
При исправлении ошибки агент ищет по репозиторию, читает файлы, проверяет гипотезы, меняет код и запускает тесты. История быстро заполняется выводами инструментов и неудачными попытками, которые уже не нужны после локализации дефекта. Если ждать заполнения окна, сжатие может сработать посреди незаконченного исследования и удалить ещё полезные сведения.
AutoCompact получает отдельное действие compact(). Агент может вызвать его, когда завершил этап задачи: например, нашёл причину ошибки и готов перейти к исправлению. Предыдущая история заменяется кратким рабочим состоянием, но исходное задание остаётся в контексте.
Рабочее состояние должно сохранить выводы, нужные участки кода, состояние файлов и следующие действия. После сжатия агент продолжает работу с этой записи, а не начинает поиск заново. Поэтому метод учит сразу трём связанным решениям: когда убрать историю, что оставить и какое действие выполнить после этого.
Одной инструкции в запросе оказалось недостаточно: базовая модель редко вызывала сжатие заранее. Для обучения модель-оценщик проверяла каждое предложенное действие и исправляла неверный момент сжатия, неполное рабочее состояние или повторный поиск после него. Исправление выполнялось до обращения к среде, поэтому вся оставшаяся траектория строилась уже на корректном решении.
Для дообучения с учителем собрали 1 052 исправленные траектории на 379 задачах SWE-rebench. Затем модель обучили с подкреплением: единственной наградой служил итоговый результат — прошёл готовый патч тесты или нет. Отдельной награды за короткое или красивое резюме не было, поэтому сжатие приносило пользу только тогда, когда помогало закончить задачу.
Полная история уступила управляемому рабочему состоянию
AutoCompact показал лучший результат среди проверенных способов управления историей: на SWE-bench Verified он решил 39,6% задач, а на SWE-PolyBench Verified — 24,5%. На втором наборе прирост относительно базовой модели составил 5,0 процентного пункта.
Сравнение включало полную историю без обученного сжатия, срабатывание по фиксированному порогу, CompactionRL, SelfCompact и SWE-Compressor. Методы различались тем, что одни ждали нехватки места, другие задавали модели правила во время запуска, а третьи вставляли сжатие в уже готовые траектории. AutoCompact дополнительно учился продолжать работу после изменённого контекста.
В режиме с окном 256K токенов ни одна траектория не дошла до принудительного сжатия. Тем не менее обученные способы, которые сокращали историю заранее, обошли базовую модель. Значит, эффект связан не только с предотвращением переполнения: устаревшие поиски и выводы инструментов мешают агенту, даже когда технически помещаются в окно.
Авторы также отключили выполнение compact() у уже обученной модели. Параметры модели оставались прежними, но вызовы сжатия пропускались, и агент продолжал работать с полной историей. Результат снизился, особенно при малом бюджете на запуск: часть выигрыша дала именно замена истории рабочим состоянием, а не общее дообучение навыкам программирования.
Планы стоит менять тем, кто контролирует модель и среду агента
Работа предлагает не готовый внешний модуль памяти, а совместное устройство модели и среды. Среда предоставляет действие сжатия, модель решает, когда его вызвать, а обучение связывает это решение с успешным патчем. Модель-оценщик нужна только при подготовке траекторий; во время обычного запуска AutoCompact работает без неё.
Для собственной агентной системы из этого следует практическое изменение архитектуры. Резюме истории стоит хранить как исполняемое рабочее состояние: в нём нужны не только найденные факты, но и состояние репозитория, незавершённые проверки и ближайшее действие. В тестах следует отдельно проверять, не возвращается ли агент после сжатия к уже завершённому поиску и не противоречит ли следующий шаг сохранённым выводам.
Пороговое сжатие при заполнении окна можно оставить как страховку. AutoCompact работал и в ограниченном режиме с порогом 16K, где все варианты использовали одинаковый запасной механизм, но обученная модель могла очистить историю раньше. Это позволяет отделить логику задачи от технического лимита контекста.
Границы проверки достаточно узкие: использовали Qwen3-Coder-30B-A3B-Instruct, один терминальный каркас агента и два набора задач на уровне репозитория. Обучение с подкреплением шло на последовательностях до 32K токенов, хотя длинный режим оценки был в восемь раз больше. Командам с другой моделью или средой придётся заново собирать траектории и проверять, переносится ли выигрыш; одних инструкций для воспроизведения метода работа не предлагает.
Источники
Иллюстрация: рисунок из статьи «AutoCompact: Learning When to Compact Context in Long-Horizon Coding Agents», Xuan Zhang, Longtao Zheng, Cunxiao Du и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


