Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
AutoData научилась подбирать документы для предобучения через пробные запуски моделей, а не по заранее заданному фильтру или смеси тематик. В препринте University of Amsterdam и Weco AI найденные рецепты показали лучший результат по качеству моделирования текста вплоть до GPT-2 с 897 млн параметров, хотя работа не рецензирована и все числа получили сами авторы. Отбор данных теперь можно включить в тот же цикл автоматических экспериментов, где агенты уже меняют архитектуру и код обучения.
Как агент превращает отбор данных в исполняемую программу
Обычный поиск смеси данных назначает веса заранее определённым источникам или тематикам. AutoData ищет сам алгоритм: как оценить каждый документ, какие признаки связать между собой, как разделить корпус на группы и насколько случайным сделать итоговый выбор.
Агент получает признаки документов и пишет исполняемую функцию отбора. Она собирает подмножество корпуса, после чего система обучает небольшой GPT-2, измеряет результат на отложенных данных и возвращает оценку агенту. Следующая версия функции учитывает историю уже проверенных вариантов.
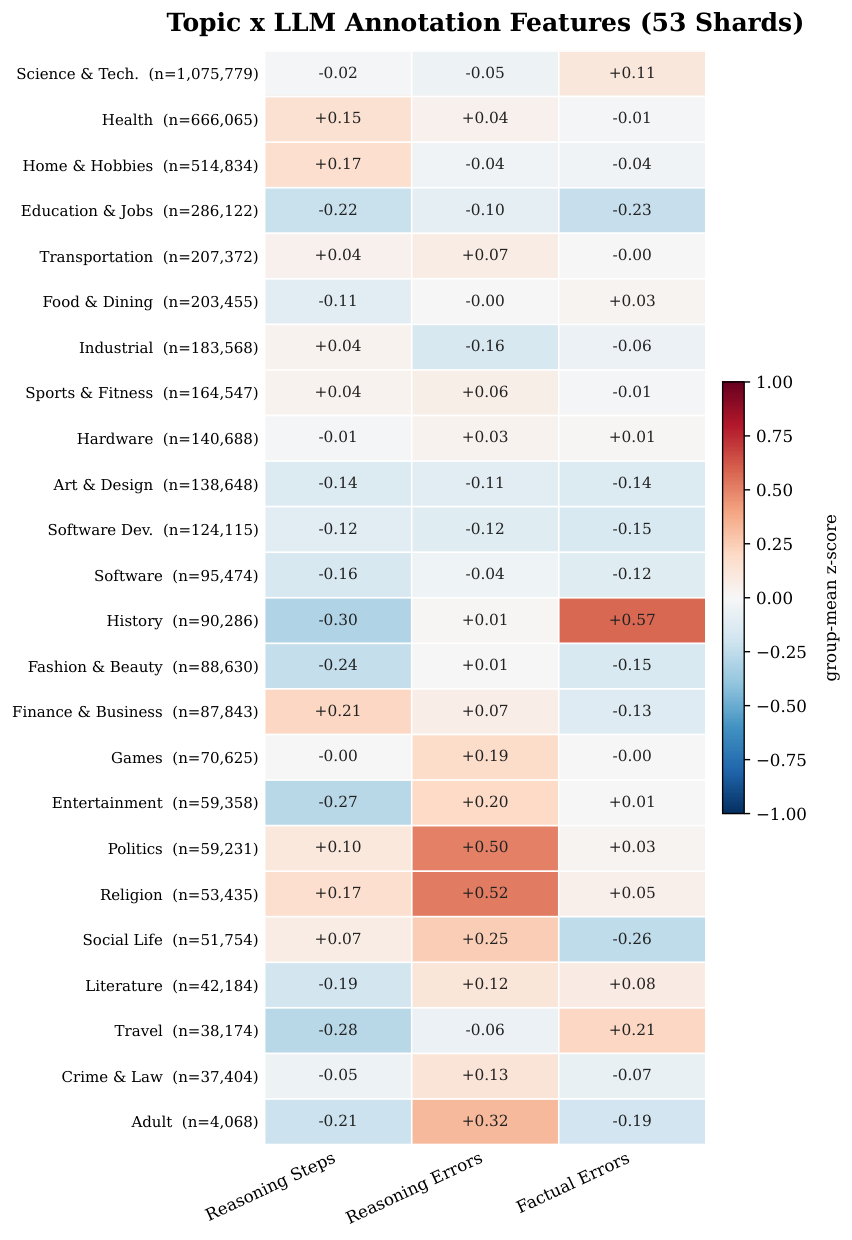
В набор признаков входят длина, повторяемость фраз, тема и формат документа, а также перплексия — мера того, насколько неожиданным текст оказался для небольшой эталонной модели. Для части корпуса добавили оценки Gemini-3-Flash: фактические ошибки, шаги рассуждения и ошибки в них.
Лучший рецепт для качества моделирования текста не свёлся к жёсткому порогу. Он оставил треть бюджета случайной выборке, а остальные документы оценивал по сочетанию разнообразия, перплексии, длины и плотности текста. Затем алгоритм сравнивал небольшие группы по три документа и добавлял случайность, чтобы высокий балл не вытеснил тематическое разнообразие.
Связь признаков здесь важнее каждого сигнала по отдельности. Например, низкая перплексия повышает оценку только у текста с достаточным лексическим разнообразием: предсказуемый шаблонный документ не проходит как качественный лишь потому, что его легко продолжать.
Что перенеслось с малого GPT-2 на более крупные модели
AutoData проверяли на одном английском корпусе ClimbMix объёмом 400 млрд токенов. Алгоритмы выбирали около 2,6% документов и конкурировали со случайной выборкой, DCLM-Baseline, фильтром по перплексии и RegMix. Для поиска использовали GPT-2 со 125 млн параметров, а перенос проверили на моделях вплоть до 1,3 млрд.
Рецепты AutoData дали лучший val-bpb на масштабах до 897 млн параметров, причём разница с базовыми методами была статистически значима. Val-bpb показывает, сколько информации в среднем требуется модели для предсказания байта текста: чем значение ниже, тем лучше она моделирует проверочный корпус.
На крупнейшей модели картина стала неоднозначной. Случайная выборка получила немного лучшее среднее значение val-bpb, а рецепт, который искали по CORE, показал лучшую среднюю точность на этом наборе прикладных задач. Один критерий поиска не гарантировал лидерства по другому, поэтому метрику обратной связи нужно выбирать под конечное назначение модели.
Границы результата проходят по одному уже очищенному веб-корпусу и семейству GPT-2. Работа показывает перенос рецепта внутри этой среды, но не подтверждает его для специализированных данных, других языков или современных LLM большего масштаба.
Когда AutoData меняет план предобучения
Работа меняет план команд, которые уже собираются обучать модель и могут многократно запускать дешёвую замену основной конфигурации. Один кандидат требовал около 10 минут на H100; чтобы снизить разброс, четыре запуска с разными начальными значениями выполняли параллельно на 4 H100. Значит, поиск нужно закладывать как отдельную вычислительную статью до основного обучения, а не как бесплатный фильтр перед ним.
Начинать необязательно с дорогой разметки документов через LLM. Семантические аннотации дали лучший найденный результат, но простые лексические признаки сами по себе оказались конкурентоспособны с полным набором. Практичный первый опыт — длина, повторяемость, тема, формат и оценка небольшой эталонной модели.
AutoData также не требует отказаться от существующей очистки корпуса. В эксперименте агент работал поверх ClimbMix, который уже прошёл кластеризацию, оценку качества и перевзвешивание. Поэтому ближайшее применение метода — искать компактную обучающую выборку внутри подготовленного пула и сравнивать её с действующим рецептом при одинаковом вычислительном бюджете.
Менять основной конвейер стоит только после такого контрольного запуска. Главный результат работы не в конкретной формуле отбора, а в том, что формулу можно искать как код и проверять по фактическому обучению, сохраняя случайную часть корпуса для разнообразия.
Источники
Иллюстрация: рисунок из статьи «AutoData: Agentic Search for Pre-training Data Selection», Yan Meng, Dhruv Srikanth, Bingchen Zhao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.