Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Двигательный нейродекодер научили улучшаться на записях движений без синхронного нейросигнала. В препринте University of Pennsylvania, который не проходил рецензирование и содержит замеры самих авторов, BeeMO достиг сопоставимого качества переноса между задачами, используя втрое меньше парных данных. Это позволяет начинать обучение на доступных траекториях поведения, а инвазивные записи подключать позже.
Поведение учится отдельно, нейросигнал уточняет траекторию
Обычный двигательный нейродекодер получает синхронную пару: активность нейронов и движение, которое происходило в тот же момент. Такая схема связывает масштаб модели с объёмом записей, где обе части собраны одновременно.
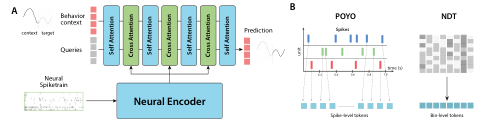
BeeMO разделяет их. Декодер поведения изучает временную структуру движений: по предыдущим точкам траектории предсказывает следующие и запоминает закономерности скорости, направления и силы. Для этого ему достаточно последовательности поведенческих измерений без соответствующей записи активности мозга.
Отдельный нейронный кодировщик превращает события от группы нейронов в компактный набор внутренних представлений. Декодер поведения обращается к ним через перекрёстное внимание (cross-attention): нейросигнал уточняет, какое из возможных движений выполняется, но сама модель динамики уже знает, как обычно развиваются траектории.
Архитектура поддерживает разные составы обучающих пакетов. Один пакет может содержать только движение, другой — синхронные нейронные и поведенческие записи. Функция ошибки и основные блоки модели при этом не меняются.
Во время проверки декодер не получает предыдущие точки движения и должен восстановить поведение только по нейросигналу. Чтобы модель не привыкла опираться на более простой источник, при обучении часть поведенческого контекста скрывают. Иначе между обучением и применением возникло бы расхождение: модель тренировалась бы с подсказкой, которой нет в рабочем режиме.
Главный выигрыш проявился при переносе между задачами
BeeMO проверяли на внутримозговых записях нечеловекообразных приматов: движениях от центра к цели, переходах между случайными целями и изометрическом усилии запястья. Модель переносили на животных, которых не использовали при предварительном обучении, и сравнивали с декодерами на основе POYO и NDT*. Это отделяет пользу поведенческого обучения от замены самого нейронного кодировщика.
К парным данным добавили около 6,5 часа отдельных записей поведения. При переносе POYO на задачу со случайными целями BeeMO увеличил коэффициент R² на 0,0112, а на задачу с усилием запястья — на 0,0124. R² показывает, какую долю изменений движения объясняют предсказания модели; в обоих случаях разница была статистически значимой.
Абсолютная прибавка невелика, но она появилась без дополнительных синхронных нейронных записей. Внутри той же задачи эффект был слабее, поэтому основной сценарий метода — не улучшать уже хорошо покрытый режим, а переносить декодер на другое движение или условие.
Авторы также обучали декодер поведения без предварительного обучения на нейросигналах, а затем подключали ограниченные парные данные. Такой вариант оказался сопоставим с моделями, которые заранее видели более крупные нейронные наборы. Это не устраняет этап настройки на синхронных записях, но показывает, что часть знаний о движении можно получить до него.
Сбор движений можно начинать раньше нейронных записей
Для команды, которая строит двигательный интерфейс, работа меняет прежде всего порядок сбора данных. Траектории движения, положение курсора или силу можно накапливать до готовности инвазивной части эксперимента, а затем использовать их для предварительного обучения общего декодера поведения.
Парные записи всё равно нужны: они связывают нейронную активность с уже изученным пространством движений. Поэтому BeeMO не предлагает заменить нейрофизиологический набор данных обычной телеметрией. Метод предлагает не тратить парные сеансы на изучение закономерностей, которые видны непосредственно в поведении.
Практический пилот стоит строить вокруг переноса. Сначала декодер поведения обучают на имеющихся траекториях, затем подключают один из нейронных кодировщиков и сравнивают с тем же кодировщиком без такой подготовки. Иначе улучшение нельзя будет отделить от различий в архитектуре или настройке.
Границы применимости проходят по типу целевой переменной. Эксперименты охватывают структурированные двигательные задачи с выраженной временной динамикой. Для когнитивного состояния без наблюдаемой последовательности действий такой способ напрямую не подходит, а для свободного поведения могут потребоваться более сложные представления.
Обучение BeeMO также требует больше вычислений, чем последующее сглаживание результатов фильтром Калмана. Выбор имеет смысл там, где важны разные задачи и животные: простой фильтр легче запустить, но его динамическая модель сильнее привязана к конкретному движению и частоте измерений.
Источники
Иллюстрация: рисунок из статьи «Scaling Neural Motor Decoding via Decoupled Behavioral Pretraining», Divyansha Lachi, Vinam Arora, Shivashriganesh P. Mahato и др., CC BY-SA 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.