
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Бинарную генеративную модель научили менять число шагов при запуске без дистилляции и повторного обучения. BFM сохранила качество при резком сокращении вызовов нейросети, тогда как у BLD оно заметно ухудшилось; работа не рецензирована, а числа получили сами авторы. Для команд с бинарными скрытыми представлениями это открывает способ ускорить генерацию без отдельной версии модели под каждый бюджет вычислений.
Почему пропуск шагов ломает бинарную диффузию
Бинарная генеративная модель работает с переменными, которые принимают только два значения. Это могут быть чёрно-белые пиксели, двоичные скрытые представления изображений или состояния физической системы.
Обычная бинарная диффузия постепенно превращает данные в случайный шум, а затем обучается проходить тот же путь в обратную сторону. Каждый обратный переход рассчитан для соседних моментов времени: модель получает текущее состояние и оценивает предыдущее.
Проблема возникает, когда после обучения команда сокращает число вызовов нейросети. Один шаг запуска теперь должен заменить несколько переходов из исходной цепочки. Локальное правило, которое обучали для соседних состояний, применяют к более длинному интервалу, хотя оно не описывает такой переход точно.
Ошибка накапливается по мере укрупнения шагов. Поэтому простое сокращение вычислительного бюджета меняет не только точность численного расчёта, но и сам процесс, который реализует модель.
BFM строит процесс иначе. Вместо последовательности заранее закреплённых переходов метод задаёт непрерывный путь вероятностей Бернулли между данными и чистым бинарным шумом. Для любого участка этого пути можно аналитически вычислить условное распределение предыдущего состояния.
При сокращённом запуске модель не имитирует серию пропущенных переходов одним локальным правилом. Она заново рассчитывает обратный переход для выбранного крупного интервала. Авторы называют это самосогласованностью: мелкая и крупная временные сетки описывают один процесс, а не две приближённо связанные схемы.
Обучение при этом остаётся близким к существующей бинарной диффузии. Нейросеть по зашумлённому состоянию предсказывает исходные данные, а ошибку считают через бинарную перекрёстную энтропию. Основное изменение находится в вероятностном пути и формуле обратного перехода, а не в новой архитектуре сети.
Качество сохранилось на крупном шаге
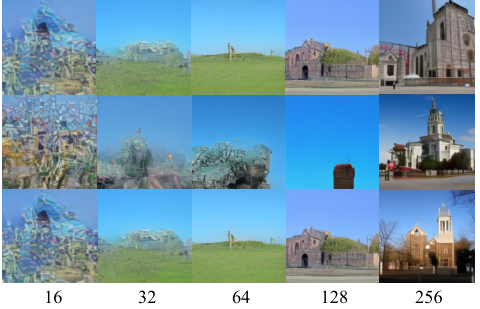
Главный тест провели на LSUN Churches с изображениями 256×256. BFM и BLD обучали с бюджетом в 256 шагов, после чего запускали те же контрольные точки всего за 16 шагов, не меняя обучение.
Качество измеряли через FID — расстояние между распределениями признаков настоящих и сгенерированных изображений; меньшее значение означает более близкие распределения. BFM получила FID 9,22, а BLD — 204,10. Разрыв показывает, что преимущество пришло не только от общей способности модели строить изображения: оно проявилось именно при укрупнении переходов.
Сравнение контролировали через общую кодовую базу BLD, одинаковую архитектуру и одинаковые настройки обучения. При полном бюджете шагов BFM также дала FID ниже воспроизведённой BLD на LSUN Bedrooms, LSUN Churches и FFHQ, то есть устойчивость к ускорению не потребовала отказаться от качества в штатном режиме.
Границы проверки остаются узкими. Основные опыты охватывают генерацию изображений через бинарное скрытое представление, непосредственно бинарный Binarized MNIST и модель Изинга. Самый показательный опыт с сокращённым запуском относится к одной задаче LSUN Churches и одной базовой модели BLD.
Когда BFM меняет план разработки
Работа касается команд, которые уже выбрали бинарное пространство состояний или рассматривают его ради компактного хранения и вычислений. Если задержку создаёт длинная последовательность вызовов одной модели, BFM позволяет заложить переменный бюджет запуска: одна контрольная точка поддерживает более подробную или более короткую генерацию.
Это не готовый ускоритель для произвольной диффузионной модели. Свойство появляется благодаря тому, как BFM задаёт путь вероятностей и обучает предсказание исходного состояния. План миграции должен включать обучение модели как BFM; отсутствие переобучения относится к последующему изменению числа шагов у её собственной контрольной точки, а не к переносу существующей BLD.
Для продукта разумный следующий этап — небольшой сравнительный прототип на собственном бинарном представлении. Проверять стоит качество при рабочем бюджете вызовов и поведение на данных продукта, поскольку главный эксперимент показывает устойчивость метода к крупному шагу, но не переносит её автоматически на другие типы бинарных данных.
Командам, которые строят генерацию в непрерывном пространстве и уже используют специализированные ускоренные решатели, работа напрямую план не меняет. Её результат уже: для бинарной генерации сокращённый запуск лучше закладывать в вероятностную конструкцию модели, а не добавлять после обучения как пропуск звеньев дискретной цепочки.
Источники
Иллюстрация: рисунок из статьи «Bernoulli Flow Models: Self-Consistent Generative Modeling for Binary Data», Hao Mo, Liying Yang, Shumin Yao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


