
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
При RL-постобучении языковых моделей обычное округление в bf16 может стирать почти все изменения весов до того, как их увидит модель, которая генерирует обучающие ответы. Fair Cast чаще дал лучший итог, чем стандартный экспорт, хотя работа не рецензирована и все числа получили сами авторы. Для команд, которые управляют собственным контуром обучения, это повод проверить не только оптимизатор и функцию потерь, но и способ передачи весов в движок инференса.
Оптимизатор и генератор обучают разные версии модели
Типичный контур хранит основные веса оптимизатора в fp32, а ответы генерирует отдельный движок с копией в bf16. fp32 хранит больше точности, а bf16 экономит память и ускоряет вычисления. Перед очередной генерацией система округляет основные веса до ближайших значений, доступных в bf16.
Проблема возникает, когда изменение веса меньше половины расстояния между соседними значениями bf16. Основной вес сдвигается, но после округления его копия остаётся прежней. На Qwen3-1.7B за один шаг менялись только 0,4–0,5% весов обслуживаемой модели, поэтому она отставала от состояния оптимизатора на 50–150 шагов.
Такое отставание трудно увидеть стандартными проверками. Они сравнивают вероятности, рассчитанные обучающим кодом и движком генерации, но обе стороны уже используют округлённые веса. Проверка показывает согласованность, хотя fp32-веса оптимизатора успели уйти вперёд.
Это не обычная погрешность одного вычисления. Округление раз за разом удерживает веса с одной стороны границы, поэтому небольшие обновления накапливаются скрыто, а затем меняют обслуживаемую модель скачком. На длинных ответах расхождение затрагивает всю последовательность: оптимизатор улучшает одну политику, а обучающие примеры создаёт её устаревшая копия.
Fair Cast убирает систематическое отставание
Fair Cast меняет две части контура. При экспорте он использует стохастическое округление либо переносит остаток ошибки на следующий шаг. Оба варианта не дают малым изменениям систематически исчезать: отдельный экспорт остаётся приближённым, но серия экспортов следует за движением основных весов.
Функцию потерь при этом считают на той же bf16-копии, которая сгенерировала ответы. Градиент затем применяют к основным fp32-весам. Это сохраняет точность состояния оптимизатора, но связывает обучающий сигнал с реально обслуживаемой политикой.
Обе части нужны одновременно. Необъективный экспорт с вычислением потерь на основной модели в экспериментах приводил к нестабильному обучению и зацикленным ответам. Один лишь переход к обслуживаемой копии тоже не устранял задержку, если экспорт по-прежнему округлял к ближайшему значению.
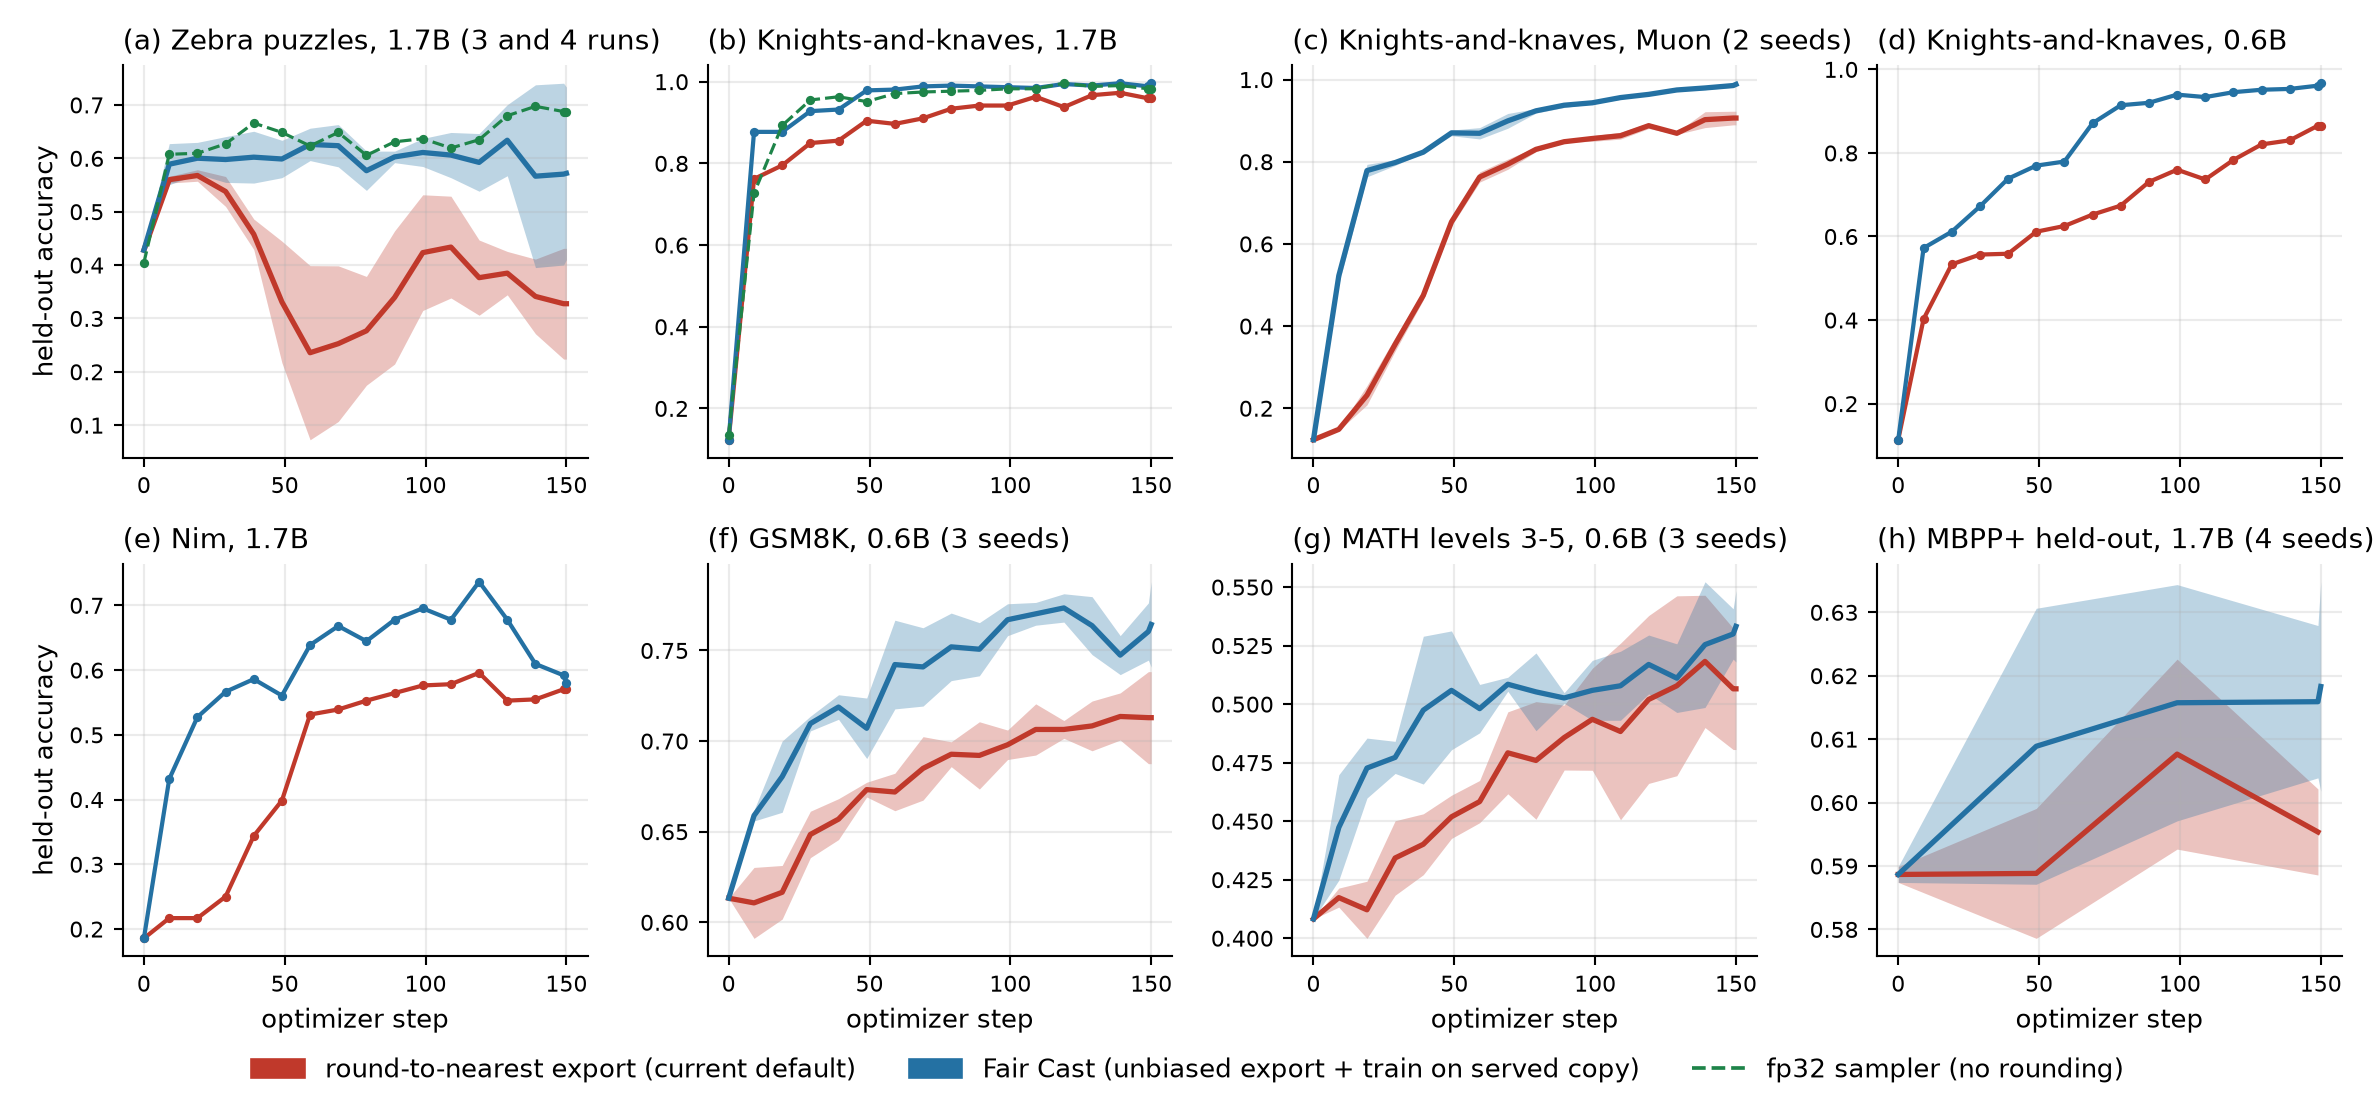
В сопоставленных запусках Fair Cast опередил стандартный экспорт в 18 случаях из 25, а средний выигрыш составил 6,1 процентного пункта. Особенно заметен эффект на задачах с длинными рассуждениями: стандартный вариант мог сначала учиться, а затем перейти к чрезмерно длинным ответам и потерять точность. Fair Cast также сблизил качество сохранённого fp32-состояния и обслуживаемой копии — при обычном округлении контрольная точка могла вести себя хуже модели, которую фактически использовали во время обучения.
Что менять в контуре обучения
Первый практический шаг — найти место, где веса переходят из тренера в движок генерации. Проверять нужно именно правило экспорта, а не только совпадение вероятностей между двумя bf16-вычислениями. В рассмотренных авторами открытых стеках использовалось округление к ближайшему значению, поэтому проблема относится к распространённой архитектуре RL-постобучения, а не к одному экспериментальному контуру.
Замена локальна: вариант со стохастическим округлением меняет вызов экспорта и не добавляет настраиваемых параметров. Полный экспорт Qwen3-1.7B занимал 22 мс, то есть его стоимость мала на фоне шага обучения. Вариант с переносом ошибки требует дополнительный fp32-остаток для каждого веса, поэтому он расходует больше памяти.
После изменения стоит оценивать обслуживаемую копию, а не считать сохранённые fp32-веса эквивалентом развёрнутой модели. Это особенно важно, если следующий этап экспортирует контрольную точку в другой числовой формат: расхождение, накопленное во время обучения, от такой конвертации само не исчезает.
Работу проверяли на Qwen3 и нескольких дополнительных семействах, на задачах по логике, математике, коду и синтетическим играм; крупнейшая модель содержала 4 млрд параметров. Все эксперименты проходили в одной реализации, а часть конфигураций запускали с одним начальным состоянием. Поэтому результат обосновывает аудит и пробное внедрение, но пока не гарантирует тот же выигрыш на более крупных моделях и других контурах.
Обычное округление иногда работало как неуправляемое сглаживание и помогало отдельным задачам. Если после Fair Cast качество падает, авторы предлагают вернуть задержку явно через экспоненциальное скользящее среднее весов. Тогда сила сглаживания становится отдельной настройкой, а не случайным следствием формата bf16.
Источники
Иллюстрация: рисунок из статьи «bf16 Rounding Silently Discards Most RL Policy Updates: A Hidden Training-Inference Mismatch and an Unbiased One-Line Fix», Andrew Gao, William Gao, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


