
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Для ответов по длинной истории диалогов научились собирать взаимодополняющие записи, а не ограничиваться несколькими самыми похожими. В препринте Yufeng Li и соавторов, который не прошёл рецензирование и содержит их собственные замеры, BFR повысил точность по модели-оценщику с 72,4% до 82,2%. Для систем с внешней памятью это меняет цель поиска: контекст должен не просто соответствовать теме, а содержать все факты, необходимые для ответа.
Релевантная запись ещё не делает набор достаточным
Агент не может постоянно держать всю историю общения в контекстном окне. Поэтому старые диалоги сохраняют во внешней памяти, а перед ответом выбирают несколько записей с близкими словами или векторами признаков.
Такой поиск оценивает каждую запись отдельно. Первые позиции могут несколько раз подтверждать одну часть ответа, но пропустить менее похожую запись с недостающей датой, человеком или событием.
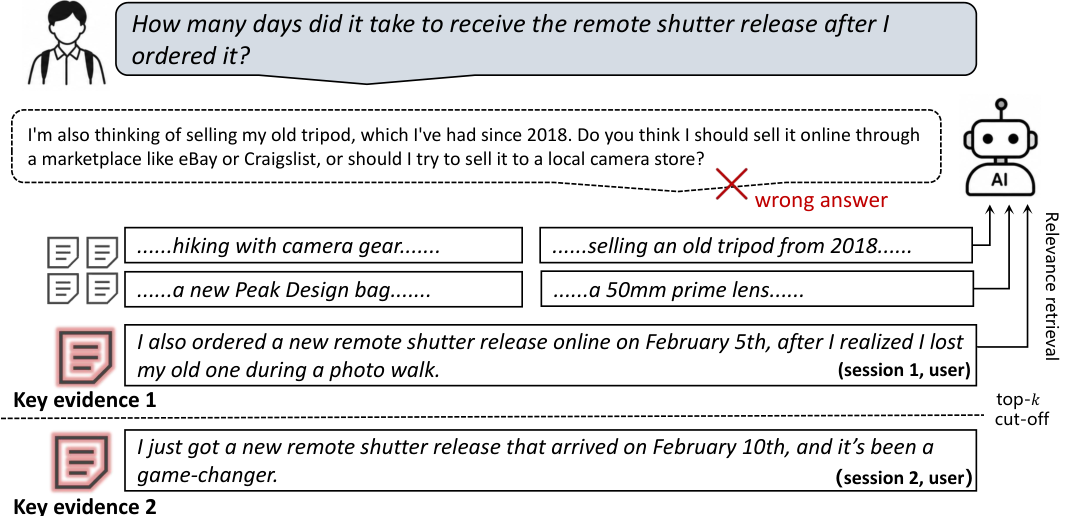
В примере из работы пользователь спрашивает, сколько доставляли дистанционный спуск затвора. Поиск находит запись о заказе и другие разговоры о фотографии, но не находит сообщение о получении товара. Все выбранные фрагменты относятся к теме, однако вычислить срок доставки по ним нельзя.
Авторы разделяют релевантность отдельной записи и достаточность всего набора. Для ответа о доставке нужны обе даты: наличие только заказа или только получения не решает задачу, даже если поиск попал в размеченный фрагмент.
Из-за этого работа использует несколько разных проверок. Модель-оценщик определяет, можно ли вывести эталонный ответ из всего контекста. Дополнительные метрики показывают, попал ли поиск хотя бы в одну размеченную запись или в реплику с ответом. Простое попадание помогает найти ошибку поиска, но не доказывает, что собранных свидетельств достаточно.
Как BFR дополняет первый список результатов
BFR работает поверх плоского хранилища и не требует превращать память в новый граф. Метод разделяет задачу на два этапа: сначала составляет компактный набор из доступных кандидатов, затем ищет недостающие записи за пределами первой выдачи.
На первом этапе система запрашивает больше кандидатов, чем обычный поиск вернул бы агенту. LLM раскладывает вопрос на требования к ответу: отдельные факты, связующие сведения, элементы списка и временные условия.
Затем FCA-MS, отбор памяти через анализ формальных понятий, сопоставляет требования с найденными записями и сокращает список. Другая LLM выбирает минимальный набор, который совместно закрывает требования. Выбранные заметки связываются с исходными репликами диалога, чтобы ответ строился по первичным записям, а не по их пересказам.
Первый этап не поможет, если нужной записи вообще нет среди кандидатов. Поэтому второй этап продолжает поиск по тому же хранилищу и исключает уже найденные фрагменты. Новые записи накапливаются, а не заменяют предыдущий контекст.
BFR-Text повторяет исходный текстовый запрос и проходит глубже первой страницы выдачи. BFR-MV добавляет другие пути: ищет по человеку, названному в вопросе, и по сессии, связанной с последней сохранённой записью. Это позволяет достать фрагмент, который слабо похож на полный текст вопроса, но связан с нужным участником или разговором.
Основная конфигурация ограничивает завершение тремя раундами и шестью поисковыми вызовами. Система останавливается по бюджету, а не пытается сама объявить набор достаточным: надёжная проверка во время работы потребовала бы эталонного ответа или разметки, которых в реальном запросе нет.
Командам стоит менять слой поиска, а не хранилище
На LongMemEval-S полный вариант BFR-MV нашёл размеченную реплику с ответом в 91,4% случаев. Один только FCA-MS поднял этот показатель с 82,2% до 85,0%, а дальнейший прирост дал поиск за границей исходного списка. Значит, тщательнее переставить первые результаты недостаточно: системе нужен управляемый способ продолжать доступ к памяти.
Работу проверяли на полном LongMemEval-S из 500 вопросов и на основном сопоставимом срезе LoCoMo из 200 вопросов. Внутри каждого испытания фиксировали хранилище, модель ответа и модель-оценщик, а BFR сравнивали с адаптациями других методов на том же наборе записей. Вывод относится прежде всего к вопросам по длинным диалогам, где факты распределены между сессиями и зависят от времени.
Для существующего продукта это не требует сразу менять формат всей памяти. Поверх векторного или текстового поиска можно добавить разбор вопроса на требования, отбор неповторяющихся свидетельств и несколько ограниченных попыток получить новые записи через разные представления того же хранилища.
Менять стоит и проверку качества. Точность финального ответа не показывает, ошибся ли поиск или модель не смогла использовать уже найденные факты. Отдельная оценка достаточности набора позволяет различить эти случаи и проверить, закрывает ли контекст вопрос целиком.
Автоматически решать, когда поиск можно прекратить, работа пока не предлагает: проверки без эталона оказались недостаточно надёжными. Для производственной системы практический вариант — фиксировать бюджет вызовов и новых записей, а затем подбирать его на собственных сценариях по качеству ответа, задержке и стоимости.
Источники
Иллюстрация: рисунок из статьи «Relevance Is Not Sufficiency: What Actually Closes the Evidence Gap in Long-Term Memory QA», Yufeng Li, Shuxin Li, Zhenhua Xu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


