
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Обычные LLM теряют больше половины ответов, когда BI-вопрос требует не только анализа, но и подготовки сырых таблиц. В препринте Microsoft и UIUC, который не прошёл рецензирование и приводит замеры самих авторов, специализированный BI-Agent добавил до 40 процентных пунктов точности. Для сквозной автоматизации бизнес-аналитики команде нужен не универсальный запрос к модели, а отдельные инструменты для каждого этапа работы с данными.
Где ломается ответ по сырым таблицам
Обычный тест преобразования текста в SQL начинается с подготовленной схемы: таблицы уже очищены, связи известны, значения лежат в подходящих столбцах. В реальном BI-проекте сначала приходится найти нужные таблицы, изменить их структуру и восстановить связи. Только после этого можно считать показатели.
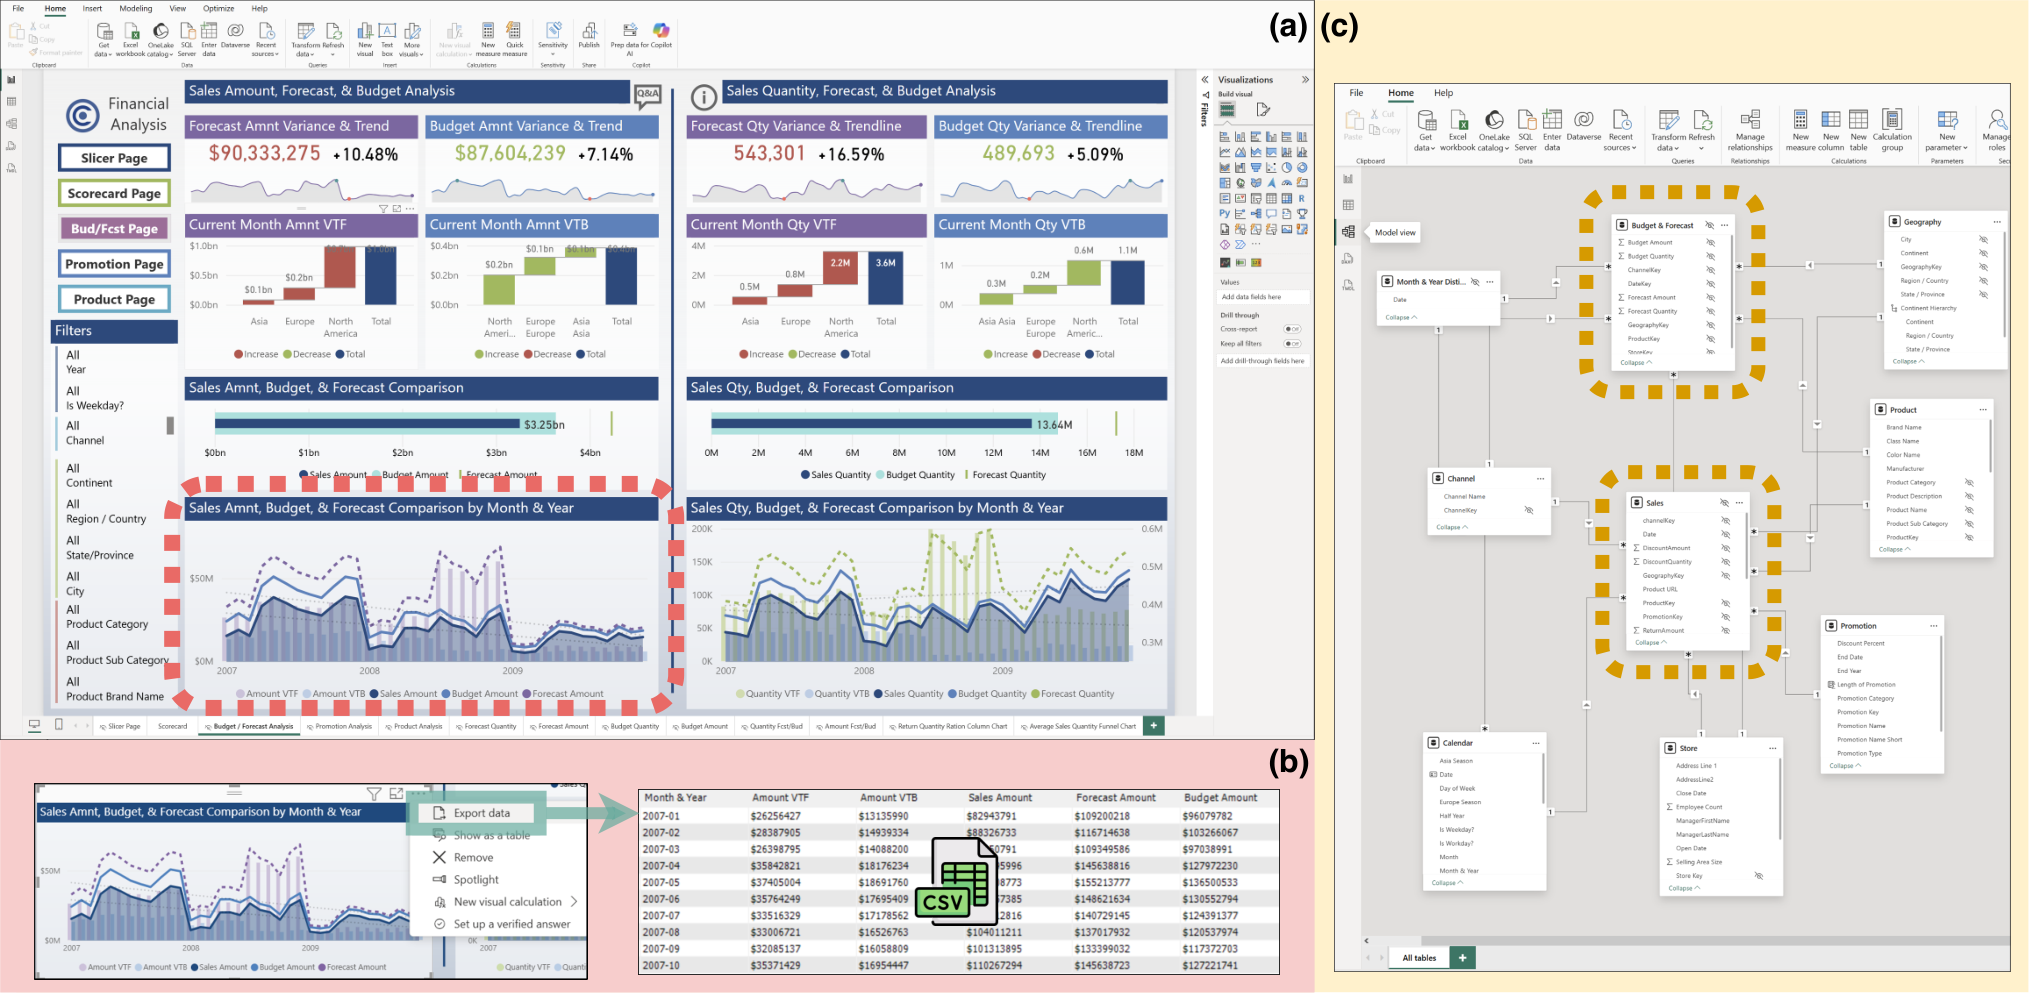
BI-Bench воспроизводит этот путь на общедоступных проектах Power BI. Для каждого задания разработчики выбирали диаграмму с ясным заголовком, превращали его в бизнес-вопрос и экспортировали лежащую под диаграммой таблицу как правильный ответ. Точность здесь означает долю вопросов, для которых система вернула верный итоговый набор данных.
Характерный сбой возникает ещё до запроса. В таблице продаж месяцы могут стоять в заголовках столбцов, а в таблице бюджета — значениями одного столбца. Человек разворачивает первую таблицу в реляционный вид, после чего объединяет данные по месяцу. LLM часто не распознаёт необходимость такого преобразования или выполняет его неправильно.
Проверка охватила 24 модели и системы, которые решали задачи через SQL и Python. Инструменты BI-Agent сократили ошибки преобразования на 54,2%, а ошибки выбора таблиц — на 40,9%. При этом самым частым оставшимся сбоем стал неполный ответ: модель пропускает нужные строки, значения или поля.
Как BI-Agent разделяет работу и учится на траекториях
BI-Agent получает бизнес-вопрос и набор исходных таблиц, но не пытается сразу написать итоговый код. Он последовательно ищет подходящие источники, приводит таблицы к пригодной для анализа форме, определяет связи и только затем выполняет расчёт.
Каждый сложный этап вынесен в специализированный инструмент. Поиск ранжирует таблицы относительно вопроса. Инструмент преобразования меняет структуру данных — например, разворачивает перекрёстную таблицу. Инструмент объединения предлагает связи между полями. LLM управляет этим процессом: выбирает следующий вызов, изучает результат и при необходимости исправляет план.
Такое разделение важно не только для точности. Вместо длинной цепочки пробного кода модель вызывает операцию с заданным назначением и форматом результата. Исполнение становится проще проверять по шагам: видно, какую таблицу агент выбрал, как преобразовал её и по каким полям объединил данные.
Вторая часть метода — дообучение на траекториях, то есть на последовательностях действий, вызовов инструментов и промежуточных результатов. Система синтезирует их из реальных BI-проектов. Сначала модель учится повторять успешные последовательности с учителем, затем обучение с подкреплением корректирует стратегию по результатам полных запусков.
Дообучение принесло ещё до 30 процентных пунктов точности. На BI-Bench модель Qwen3-8B после дообучения и с инструментами сравнялась по качеству с более крупными передовыми моделями или превзошла их при стоимости запуска до 50 раз ниже. Отдельная проверка на локальной части Spider 2.0 показала тот же порядок эффектов: инструменты улучшали базовые варианты, обучение с учителем — исходную модель, а обучение с подкреплением — вариант после первого этапа.
Меняет ли работа планы BI-команд
Работа меняет архитектурный приоритет, если продукт должен отвечать по необработанным файлам и таблицам. Начинать стоит не с выбора самой крупной LLM и не с дообучения, а с явного разбиения процесса на поиск, преобразование, объединение и расчёт. Для каждого шага нужен ограниченный интерфейс, результат которого можно сохранить и проверить.
Дообучение имеет смысл после того, как эти интерфейсы стабилизировались. Иначе траектории закрепят случайный набор команд и обходных путей. Материал для обучения можно строить из собственных BI-проектов: вопрос берётся из отчёта, правильная таблица — из его результата, а промежуточные действия восстанавливаются или синтезируются.
Проверять такой агент следует на полных задачах организации, а не только на готовых SQL-схемах. В набор стоит включить электронные таблицы необычной формы, несколько возможных связей, лишние источники и вопросы, для которых нужны преобразования. Именно на этих этапах универсальные модели чаще всего теряли правильный ответ.
Инструменты также сократили объём ответа модели на 16–25% в зависимости от языка исполнения. Значит, дополнительный слой оркестрации не обязательно увеличивает задержку: короткий специализированный вызов может заменить несколько попыток написать и исправить код.
Основные результаты получены на BI-Bench из общедоступных проектов Power BI, а перенос проверен на локальных заданиях Spider 2.0. Поэтому работа обосновывает архитектуру агента для подготовки и анализа табличных данных, но решение о внедрении всё равно требует проверки на собственных схемах, правилах расчёта и типичных вопросах пользователей.
Источники
Иллюстрация: рисунок из статьи «BI-Agent and BI-Bench: Towards Automating End-to-End Business Intelligence», Chuxuan Hu, Yeye He, Penny Zhou и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


