
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
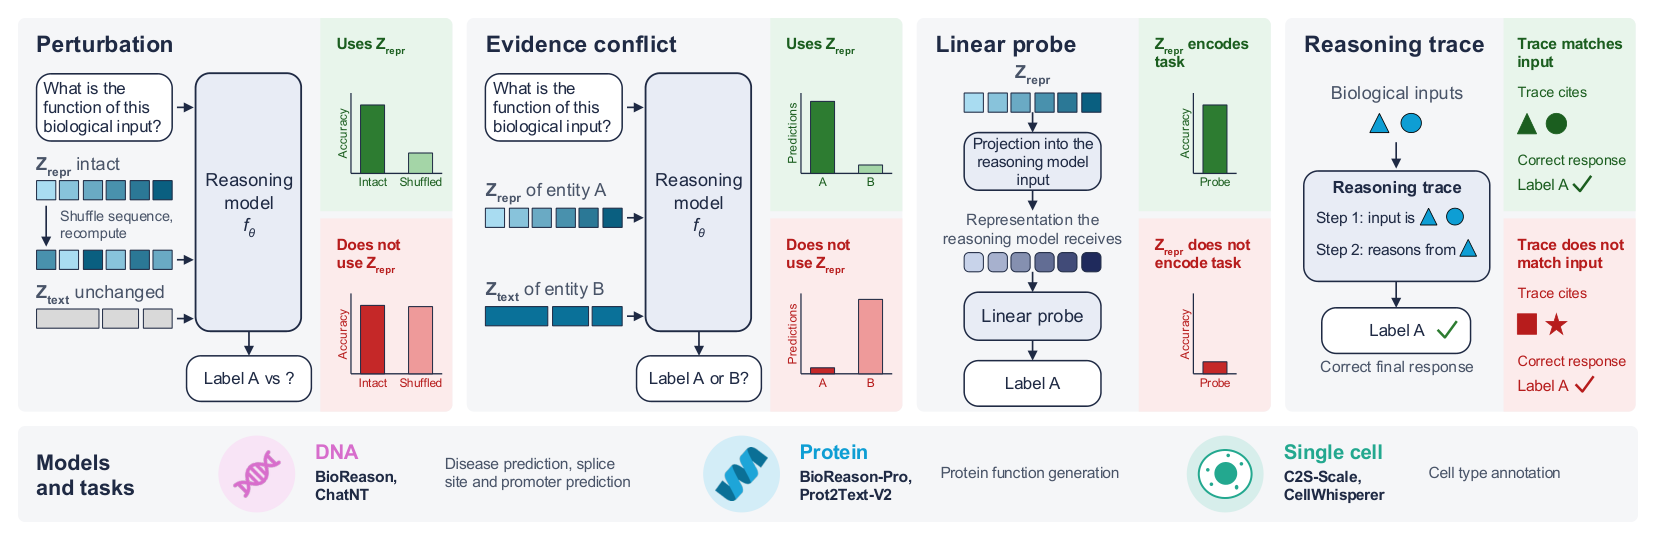
Высокая точность биологических LLM не гарантирует, что они учитывают данные о ДНК, белках или клетках. В работе Harvard University и MIT, которая не проходила рецензирование и содержит замеры самих авторов, BioReason и BioReason-Pro при конфликте входов следовали текстовым аннотациям в 97,9% и 99,7% случаев. Поэтому обычный тест на правильность ответов не показывает, действительно ли подключённая биологическая модель влияет на результат.
Для проверки один вход меняли, а запрос и остальные данные оставляли прежними. Также модели давали противоречивые свидетельства: числовое представление одного генома, белка или клетки сочетали с текстом о другом объекте. Затем исследователи проверяли, можно ли извлечь правильный ответ из представления простым линейным классификатором, и сопоставляли объяснения LLM с поданными данными.
Перемешивание ДНК не изменило долю правильных ответов BioReason: она осталась на уровне 0,847. При этом классификаторы извлекали целевые признаки из представлений Evo2 и ESM3. Значит, биологические модели кодировали полезную информацию, но подключённые к ним LLM почти не использовали её и предпочитали готовые текстовые сведения о генах, путях и функциях белков.
Так происходило не во всех системах. Представления биологических моделей влияли на ответы ChatNT, Prot2Text-V2 и CellWhisperer, а Cell2Sentence-Scale учитывала гены с различающейся активностью. У BioReason рост точности на 42 контрольных точках обучения не сопровождался более активным использованием Evo2. Сгенерированные объяснения тоже не служили надёжной проверкой: модель могла неверно описать замену нуклеотида или упомянуть функцию, которая не попадала в итоговый прогноз.
Проверка охватила шесть моделей и конкретные задачи для ДНК, белков и одиночных клеток: прогноз болезней и функций, распознавание участков последовательности и определение типа клетки. Перемешивание создаёт неестественные последовательности, однако конфликты между неизменёнными входами дали тот же вывод. При выборе архитектуры к итоговой точности стоит добавлять тесты, где меняется только биологический вход: иначе интеграция может существовать технически, но почти не влиять на решение.
Источники
Иллюстрация: рисунок из статьи «When Do Biological Reasoning Models Use Their Biological Inputs?», Ada Fang, Nikitha Thoduguli, Lukas Fesser и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


