
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Медицинских LLM-агентов научили точнее находить и использовать сведения из накопленной памяти. В препринте BioMem, который не рецензирован и содержит замеры самих авторов, Mingchen Li и коллеги получили с HMRU средний относительный прирост 8,6% на задачах биомедицинских вопросов и долговременного диалога. Для продуктовой команды это аргумент не в пользу ещё одной сложной базы памяти, а в пользу отдельной настройки поиска и правил работы с найденными фактами.
Почему правильная запись ещё не даёт правильный ответ
Работа разделяет память агента на несколько процессов: сведения нужно сохранить без искажений, найти по новому запросу и правильно применить. Большинство сравнений памяти сводит эту цепочку к итоговой точности, поэтому не показывает, на каком этапе возникла ошибка.
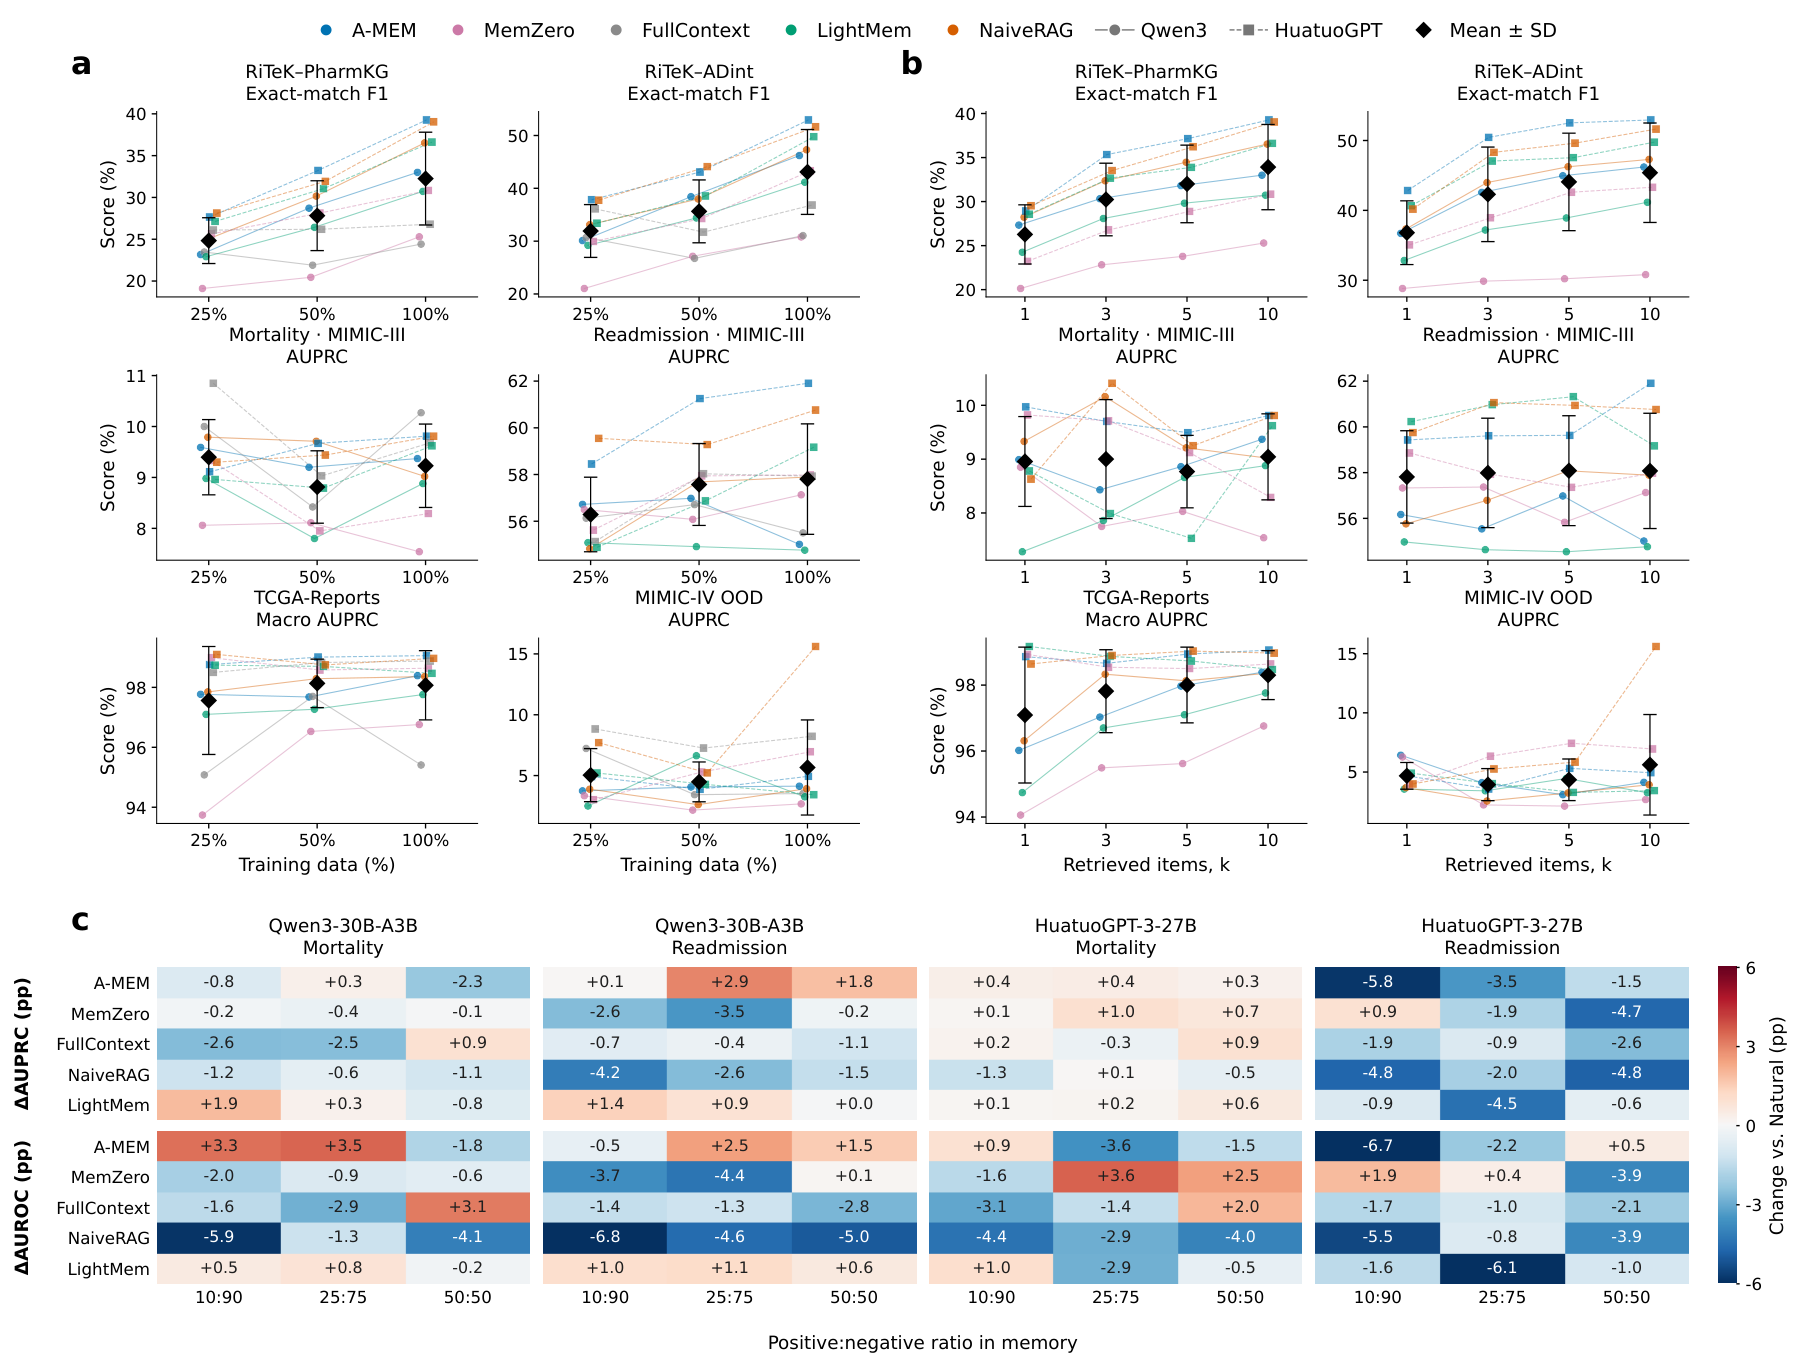
BioMem сравнивает пять подходов к памяти на четырёх LLM. Проверка охватывает шесть биомедицинских задач: ответы по графам медицинских знаний, прогноз смертности и повторной госпитализации, классификацию онкологических заключений и прогноз передозировки опиоидами. Отдельно авторы используют RealMem для диалогов, где сведения появляются, обновляются и переходят между сессиями.
В сравнение вошли A-MEM, MemZero, LightMem, NaiveRAG и передача полного контекста. Единого победителя не получилось. A-MEM и NaiveRAG чаще лидировали в вопросах по медицинским знаниям, но на клинических прогнозах результат зависел от задачи, модели, состава памяти и числа извлечённых записей.
Главный разрыв возник между поиском и использованием. Когда память содержала источник с правильным ответом, точность отдельных конфигураций доходила до 88%; без такого источника — не превышала 16%. Но даже найденная правильная запись не гарантировала верный вывод: модель могла проигнорировать доказательство, неверно связать сущности или перенести ответ из похожего, но другого случая.
Для клинических прогнозов семантическая близость записей тоже оказалась слабым ориентиром. Похожие истории пациентов не обязательно ведут к одинаковому исходу. Кроме того, при последовательном обновлении памяти в записях появлялись сведения, которых не было в исходных материалах, а затем сохранялись в следующих версиях.
HMRU объединяет разные способы поиска
HMRU не меняет параметры LLM. Сначала система объединяет семантический поиск с лексическим поиском BM25: первый находит близкие по смыслу записи, второй помогает не потерять точные названия, препараты и другие совпадающие формулировки. Затем отдельная модель повторно сортирует кандидатов по соответствию запросу.
После поиска HMRU добавляет инструкции, зависящие от задачи. Для вопросов по знаниям они требуют сверять сущности, отношения и опору ответа на найденные сведения. Для клинического прогноза — выделять факторы риска и учитывать распространённость прогнозируемого исхода, а не копировать метку похожего пациента.
Авторы проверили несколько вариантов системы. HMRU-R меняет выбор доказательств, HMRU-I добавляет правила их использования, HMRU-C сокращает представление памяти, убирая вспомогательные метаданные. Для длинных диалогов HMRU-T располагает сведения по времени и отслеживает актуальное состояние разговора.
В долговременных диалогах HMRU сократил ошибки ответов на 24,9% и закрыл 48% разрыва с режимом, где модели передают всю историю. Улучшения появились и в отдельных задачах клинического прогноза, однако работа не показывает одного варианта HMRU, который одинаково выигрывает на всех медицинских сценариях.
Что меняется в планах команд
Работа не даёт оснований заменять существующую память агента целиком. Она предлагает более прикладной порядок изменений: оставить хранилище, добавить два взаимодополняющих способа поиска, повторную сортировку и инструкции по использованию доказательств. Такой слой можно проверить без дообучения базовой модели.
При проектировании стоит измерять три результата отдельно. Первый — нашла ли система запись с нужным фактом. Второй — сохранила ли память исходный смысл после обновлений. Третий — использовала ли модель найденный факт в ответе. Одна итоговая метрика скрывает разницу между плохим поиском, испорченной записью и ошибкой рассуждения.
Для медицинского продукта особенно важна проверка происхождения каждого элемента памяти. Если агент сжимает историю пациента или объединяет несколько диалогов, новая версия записи должна оставаться связанной с исходным фрагментом. Иначе неподтверждённая деталь переживёт последующие обновления и будет выглядеть как устойчивый факт.
Границы эксперимента достаточно широки для выбора архитектуры прототипа, но не для вывода о готовности к клиническому применению. Проверяли конкретные модели, наборы биомедицинских задач и контролируемые варианты RealMem; результаты показывают свойства контура памяти, а не безопасность медицинских решений.
Практический вывод BioMem — начинать не с усложнения формата памяти. Сначала полезнее объединить смысловой и точный поиск, проверить повторную сортировку, задать правила применения доказательств и вести трассировку до источника. Если после этого качество не растёт, причина, вероятно, лежит уже в сохранении данных или способности самой модели рассуждать по ним.
Источники
Иллюстрация: рисунок из статьи «BioMem: Agentic Memory for Biomedical LLM Agents», Mingchen Li, Yongkang Xiao, Rumeng Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


