
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Черновую версию LLM для ускорения генерации научились хранить в тех же весах, что и основную, без отдельной модели. В препринте University of Georgia, Northeastern University, XPeng Motors и The University of Alabama, который не прошёл рецензирование и приводит замеры самих авторов, BitNest принимает в среднем 95,2% предложенных черновиком токенов. Подход позволяет ускорить локальную генерацию, не отдавая черновой модели часть памяти устройства.
Низкоточный черновик стал частью основных весов
Спекулятивное декодирование сокращает число дорогих запусков основной LLM. Небольшая модель заранее предлагает несколько следующих токенов, а основная проверяет их параллельно: подходящие токены остаются, а ошибочный токен и следующий за ним фрагмент отбрасываются.
Обычно для этого приходится хранить отдельную черновую модель. Другой вариант — запускать часть слоёв основной LLM или использовать её низкоточную копию, но тогда команда выбирает между расходом памяти, скоростью черновика и качеством его предложений.
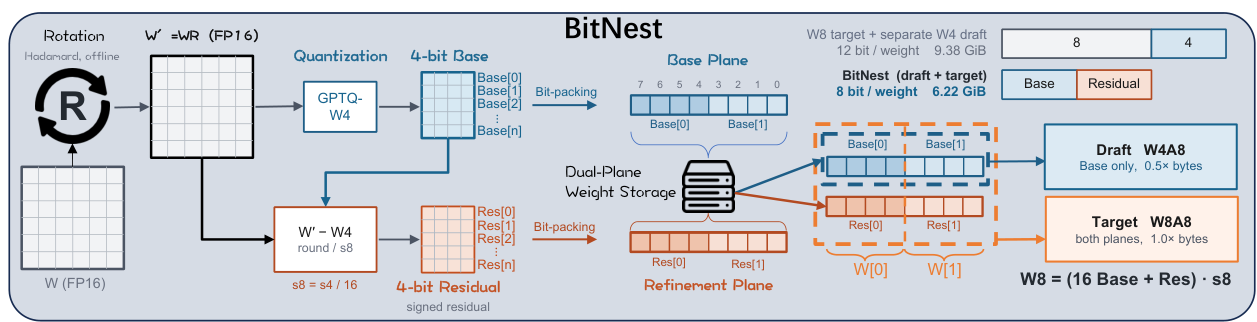
BitNest начинает с низкоточного представления весов W4, где на каждый вес приходится четыре бита. Его сначала настраивают как полноценный черновик, а затем фиксируют. Ошибку квантования кодируют ещё одним слоем битов; вместе оба слоя образуют более точную основную модель W8.
Порядок здесь важен. Если независимо квантовать исходную модель в W4 и W8, их веса не будут вложены друг в друга. В BitNest более точное представление достраивают поверх готовой базы, поэтому черновик остаётся точной физической частью основной модели.
Базовые и уточняющие биты лежат в отдельных потоках памяти. Во время подготовки токенов GPU читает только базовый поток, а при проверке — оба. Если сложить их в обычные байты вперемешку, оборудование всё равно будет загружать ненужные уточняющие биты, и преимущество дешёвого черновика сократится.
Тот же принцип применили к кэшу ключей и значений (KV-кэш), где модель хранит сведения о предыдущих токенах. На коротком контексте черновик и основная модель читают более точный кэш. Когда контекст растёт и обмен с памятью начинает занимать больше времени, черновик переключается на низкую точность, а финальная проверка сохраняет высокую.
Ускорение не потребовало второй копии весов
На протестированных моделях BitNest ускорил генерацию в 1,48–1,61 раза относительно последовательного вывода в FP16. Выигрыш сохранился на задачах языкового моделирования, математики, генерации кода, диалогов и работы с длинными документами.
Вложенные веса LLaMA-2 занимали 6,22 ГиБ — столько же, сколько отдельная модель W8. Комбинации независимого черновика W4 и основной модели W8 требовалось 9,38 ГиБ. Экономия возникает не за счёт снижения точности финальной модели, а за счёт отказа от второй копии весов.
Низкая точность подходит именно для предложений, но не для окончательного ответа. В опытах переход финальной модели на W4 заметно ухудшал результаты математических задач, тогда как уточняющий слой возвращал качество близко к W8. Высокое совпадение черновика с основной моделью само по себе не означает, что черновик можно использовать как итоговую LLM.
Метод проверяли на LLaMA-2, LLaMA-3, Qwen2 и Qwen2.5 класса примерно восьми миллиардов параметров, преимущественно на одной серверной GPU. Прямое сравнение со всеми выбранными авторами способами самоспекулятивного декодирования получилось только для LLaMA, поскольку их официальные реализации не поддерживали исследованные Qwen.
BitNest меняет планы для устройств с жёстким лимитом памяти
Подход полезен, когда продукт должен запускать LLM на одной потребительской GPU или периферийном устройстве и одновременно поддерживать длинный контекст. В опыте на Jetson Orin NX с 16 ГБ памяти максимальный контекст LLaMA-2-7B-32K вырос с 2K токенов при FP16 до 10K токенов с BitNest. Освободившаяся память досталась кэшу, а не дополнительному черновику.
Для новой системы BitNest предлагает иной порядок проектирования: сначала выбрать качественную низкоточную основу, затем достроить поверх неё целевую точность. Это отличается от схемы, где готовую основную модель и черновик оптимизируют независимо, а после пытаются согласовать их ответы.
Для существующего контура внедрение не сводится к замене файла весов. Нужны раздельное хранение битовых слоёв, операции чтения только базового слоя и переключение точности KV-кэша в зависимости от длины контекста. Поэтому выигрыш следует проверять внутри используемого движка: обычная поддержка W4 и W8 ещё не означает поддержку вложенного представления.
BitNest не отменяет отдельные черновые модели там, где память не ограничивает систему. Авторы прямо оставляют за рамками вспомогательные архитектуры, которые предлагают блок токенов параллельно и могут дать большее ускорение ценой дополнительных весов. Работа меняет прежде всего планы локального и периферийного развёртывания, где черновик конкурирует с контекстом за одну и ту же память.
Источники
Иллюстрация: рисунок из статьи «BitNest: Bit-Nested Speculative Decoding for Memory-Efficient LLM Inference Acceleration», Chence Yang, Ningxi Cheng, Arash Akbari и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


