
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Промежуточные награды научились встраивать в обучение LLM так, чтобы полезные и ошибочные участки ответа получали разные сигналы без отдельной сети оценки ценности. В препринте Amazon AGI и Virginia Tech, который не проходил рецензирование и содержит замеры самих авторов, BoT-GRPO достиг целевой доли компилируемого React-кода до 1,9 раза быстрее GRPO. Для команд это способ сократить число генераций при дообучении, если у них уже есть стабильная награда для отдельных токенов или шагов.
Почему GRPO теряет информацию о ходе решения
GRPO сравнивает несколько ответов модели на один запрос и нормализует их итоговые награды внутри группы. Затем метод назначает всем токенам одного ответа одинаковую оценку вклада: фрагмент с правильным рассуждением и строка с ошибкой получают один сигнал.
Такой подход обходится без сети оценки ценности, которая предсказывает будущую награду, но расходует данные неэкономно. Модель узнаёт, какой ответ оказался лучше соседних, однако не узнаёт, какая часть ответа помогла получить результат. В длинной цепочке рассуждений полезный сигнал размазывается по всем токенам.
BoT-GRPO собирает локальные награды всех ответов в общий набор. Каждый токен получает вес, обратно пропорциональный длине исходного ответа, поэтому короткие и длинные последовательности одинаково влияют на среднее значение и разброс награды. После этого метод вычисляет отдельную оценку вклада для каждого токена и использует обычную схему обновления GRPO.
В награде остаются две части. Глобальная сообщает, решена ли задача целиком, а локальная отмечает полезные и ошибочные участки. Авторы ограничивают локальный сигнал и делают глобальный доминирующим: промежуточная ошибка не должна перевесить правильный итог или превратить неудачный ответ в успешный. Это практическая защита, но не доказательство того, что обучение сохранит оптимальную стратегию.
Где более точная награда ускорила обучение
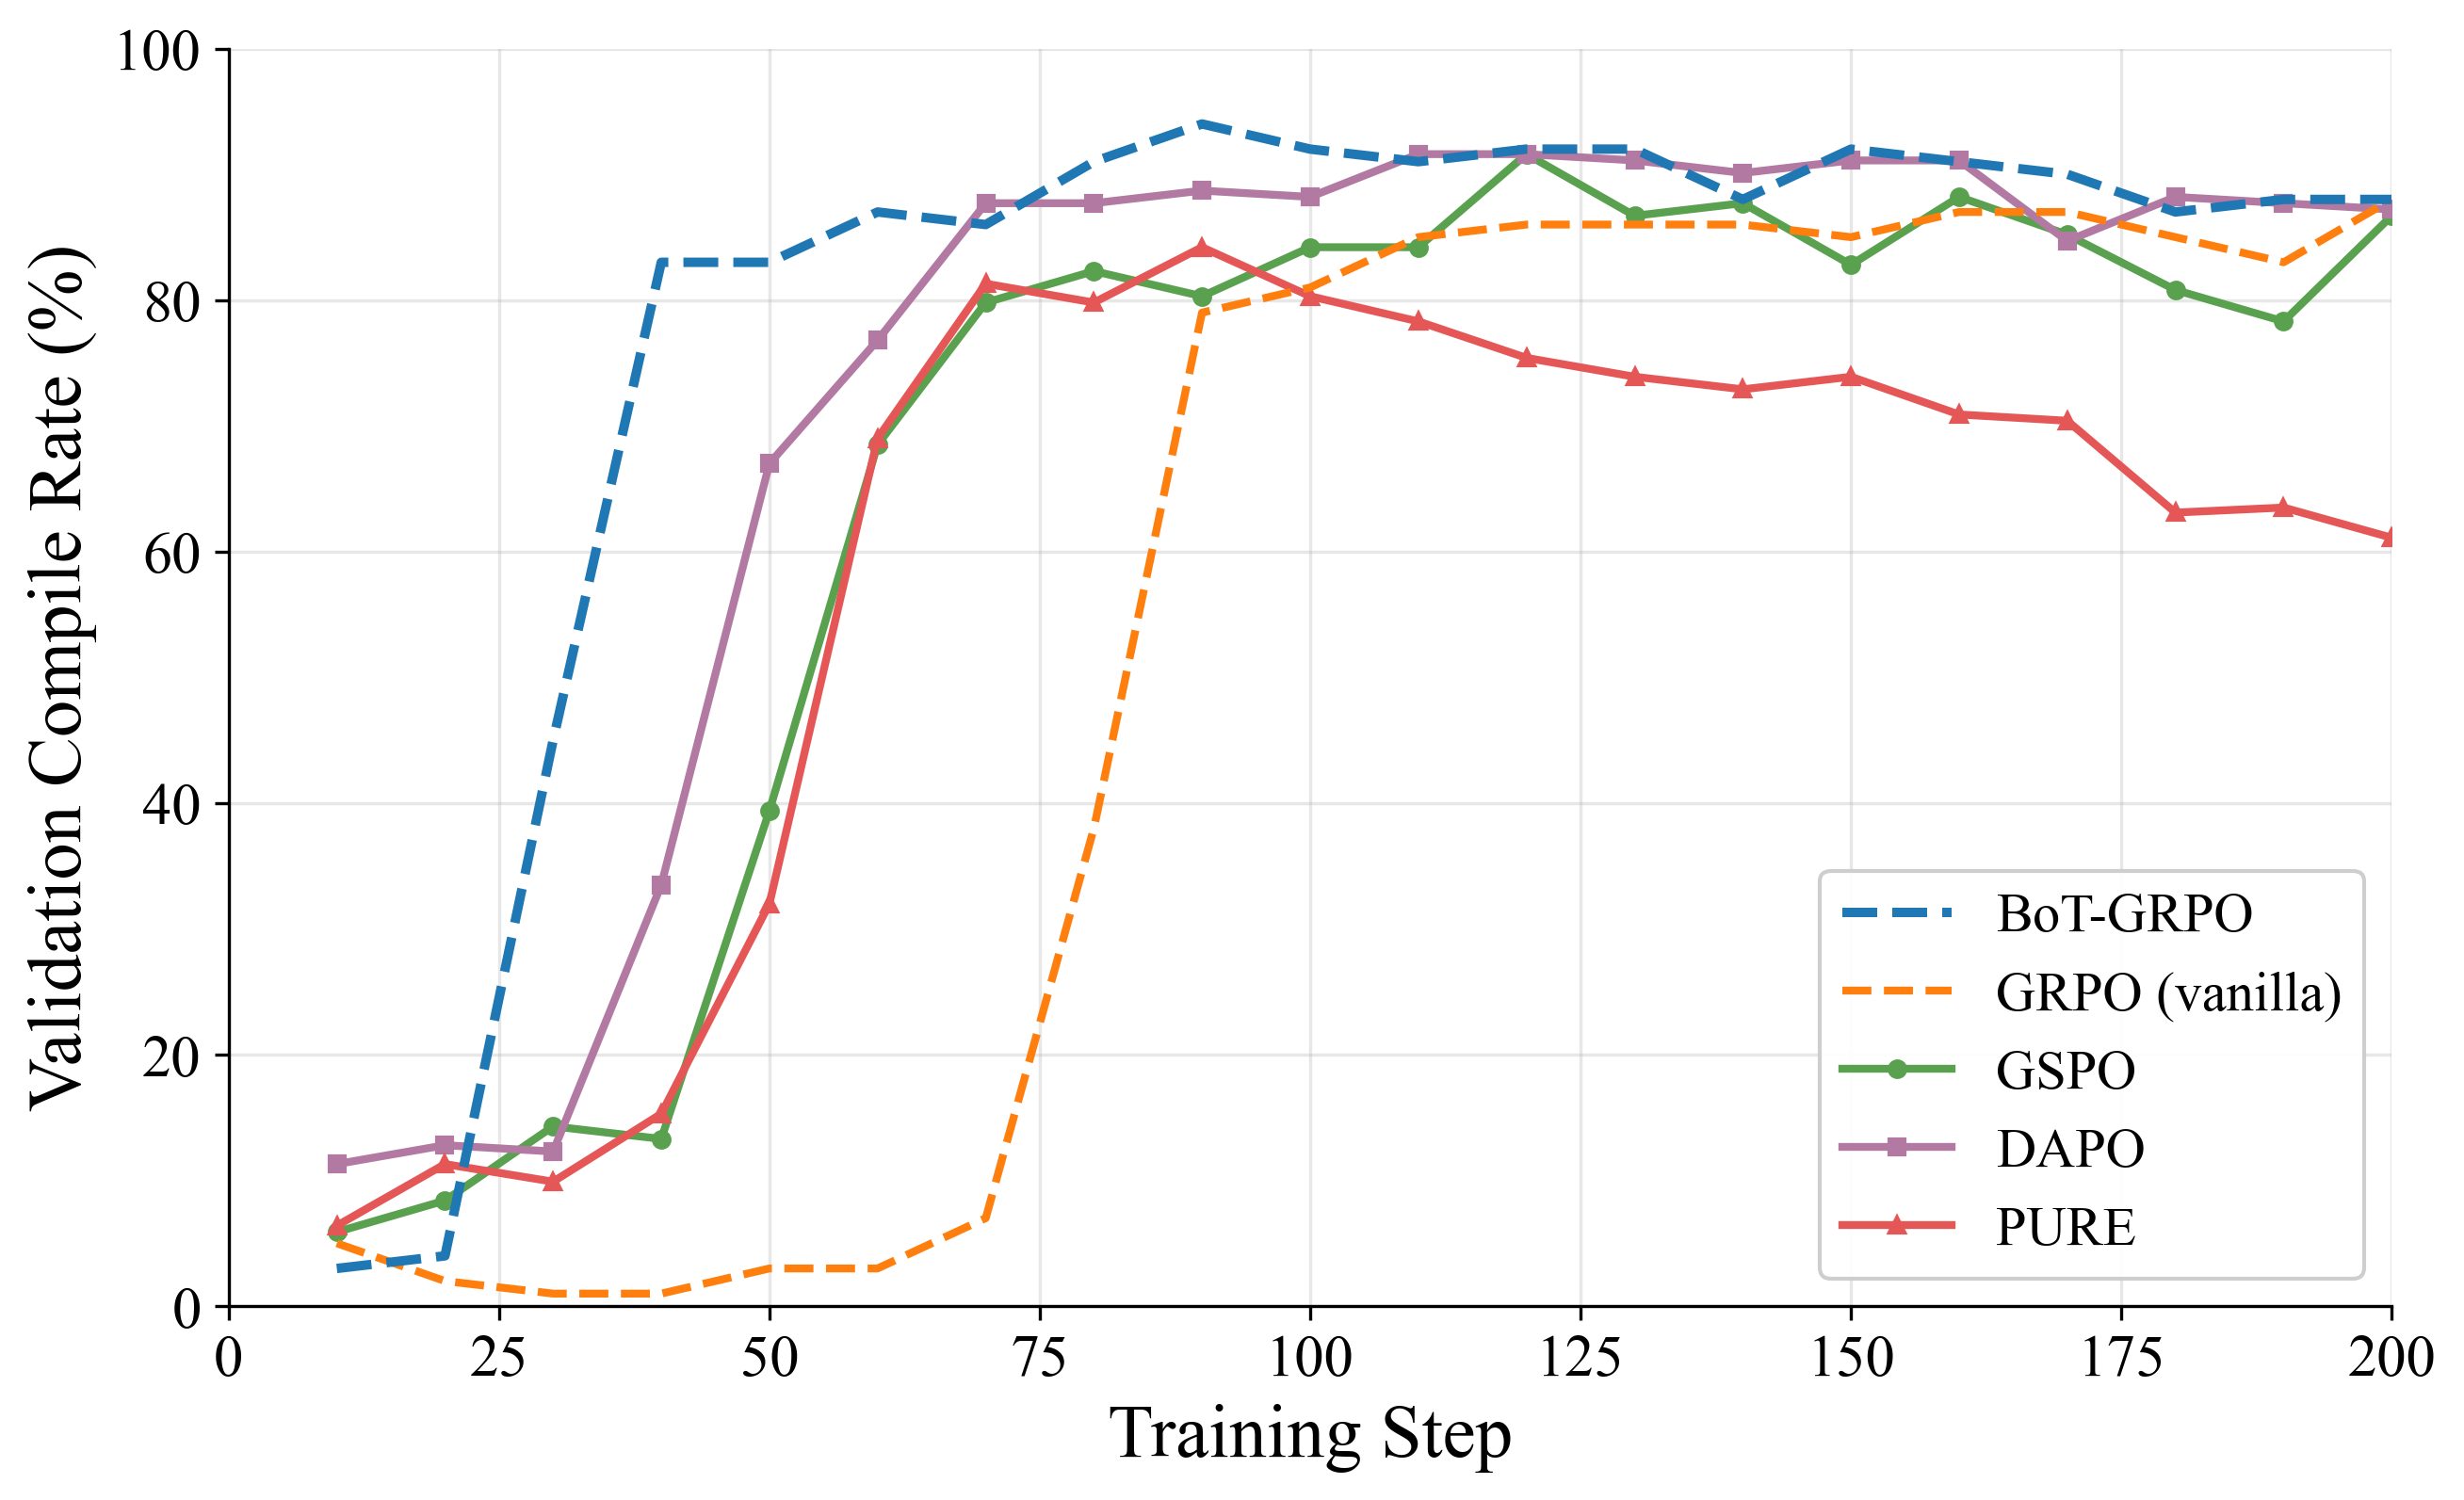
На генерации React-компонентов BoT-GRPO превысил долю компилируемых ответов в 80% к 40-му шагу. Обычный GRPO оставался около нуля до 75-го шага и приблизился к тому же уровню лишь около 90-го. GSPO и DAPO обучались быстрее базового варианта, но также уступили BoT-GRPO в начале обучения.
Ускорение не ограничилось компиляцией. Модель-оценщик, которая сравнивала изображения готовых интерфейсов, чаще выбирала результат BoT-GRPO, чем ответы GRPO, GSPO, DAPO и PURE. Значит, локальная награда влияла не только на синтаксическую корректность, но и на расположение элементов и визуальное качество.
На задачах AIME метод увеличил максимальный отрыв от GRPO на 8,1 процентного пункта по метрике, которая проверяет, появился ли верный ответ среди нескольких попыток. Для сопоставимого результата потребовалось примерно вдвое меньше шагов обучения.
Награду пришлось подбирать под предметную область. Для React авторы совместили компилятор, ESLint и оценки Claude. Одних статических проверок оказалось недостаточно: модель научилась выдавать формально допустимый каркас JSX, который компилировался, но показывал пустую страницу. Оценка исходного кода через LLM удерживала содержательность, а проверка изображения давала дополнительный, но необязательный сигнал.
Когда BoT-GRPO меняет план обучения
Метод подходит как замена GRPO без перестройки основного учебного контура, если система уже умеет выставлять награду отдельным токенам или шагам. Он не требует обучать сеть оценки ценности, а дополнительные вычисления растут линейно с числом обработанных токенов.
Экономия шагов не означает автоматического снижения всей стоимости. На AIME каждый шаг решения оценивал Claude, а в задаче с React использовались оценки кода и изображения. Работа не переводит ускорение в стоимость API-вызовов, поэтому перед заменой алгоритма нужно сопоставить сэкономленные генерации с ценой локальной награды.
Проверка охватывает React и AIME, а также Qwen2.5-3B, SmolLM3-3B и Phi-4-mini-reasoning. Эксперименты сосредоточены на моделях с 3–4 млрд параметров, которые помещаются на одном GPU. Для большинства конфигураций выполнен один запуск, поэтому заявленное ускорение стоит считать верхней оценкой, пока результат не повторят на нескольких запусках и более крупных моделях.
Сравнение также не разделяет два изменения: точную награду по токенам и выравнивание ответов по длине. Для практического решения это не мешает использовать BoT-GRPO целиком, но не позволяет заранее понять, какая часть даст основной выигрыш в другом учебном контуре.
Источники
Иллюстрация: рисунок из статьи «BoT-GRPO: Efficient Process-Reward RL for Reasoning via Bag-of-Token Aggregation», Yingxiang Yang, Weihang Xiao, Zhunxuan Wang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


