
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Пограничную ошибку модели можно использовать не только как отрицательный пример: для неё можно подобрать соседний запрос, где тот же ответ окажется правильным. В работе, которая не прошла рецензирование и где числа получили сами авторы, BPS поднял точность выбора ответа для такого соседнего запроса с 6,8 до 62,3%. Для команд, которые дообучают LLM на предпочтениях, это способ улучшить данные, не меняя функцию потерь.
Как один промах превращается в две пары предпочтений
Обычная схема исправления сохраняет исходный запрос и два ответа: исправленный побеждает, ошибочный проигрывает. Затем модель обучают методом прямой оптимизации предпочтений (DPO), чтобы она чаще выбирала исправленный вариант.
Эта разметка подходит, когда ответ содержит фактическую ошибку, бессмыслицу или небезопасный совет. Но иногда модель решает задачу по существу и нарушает только соседнее условие: пишет три пункта вместо двух, выбирает другой язык или пропускает обязательный разделитель.
Такой ответ неверен для исходного запроса, но не плох сам по себе. Если многократно показывать его DPO только как проигравший вариант, общие параметры модели могут снизить его оценку и в тех контекстах, где он уместен.
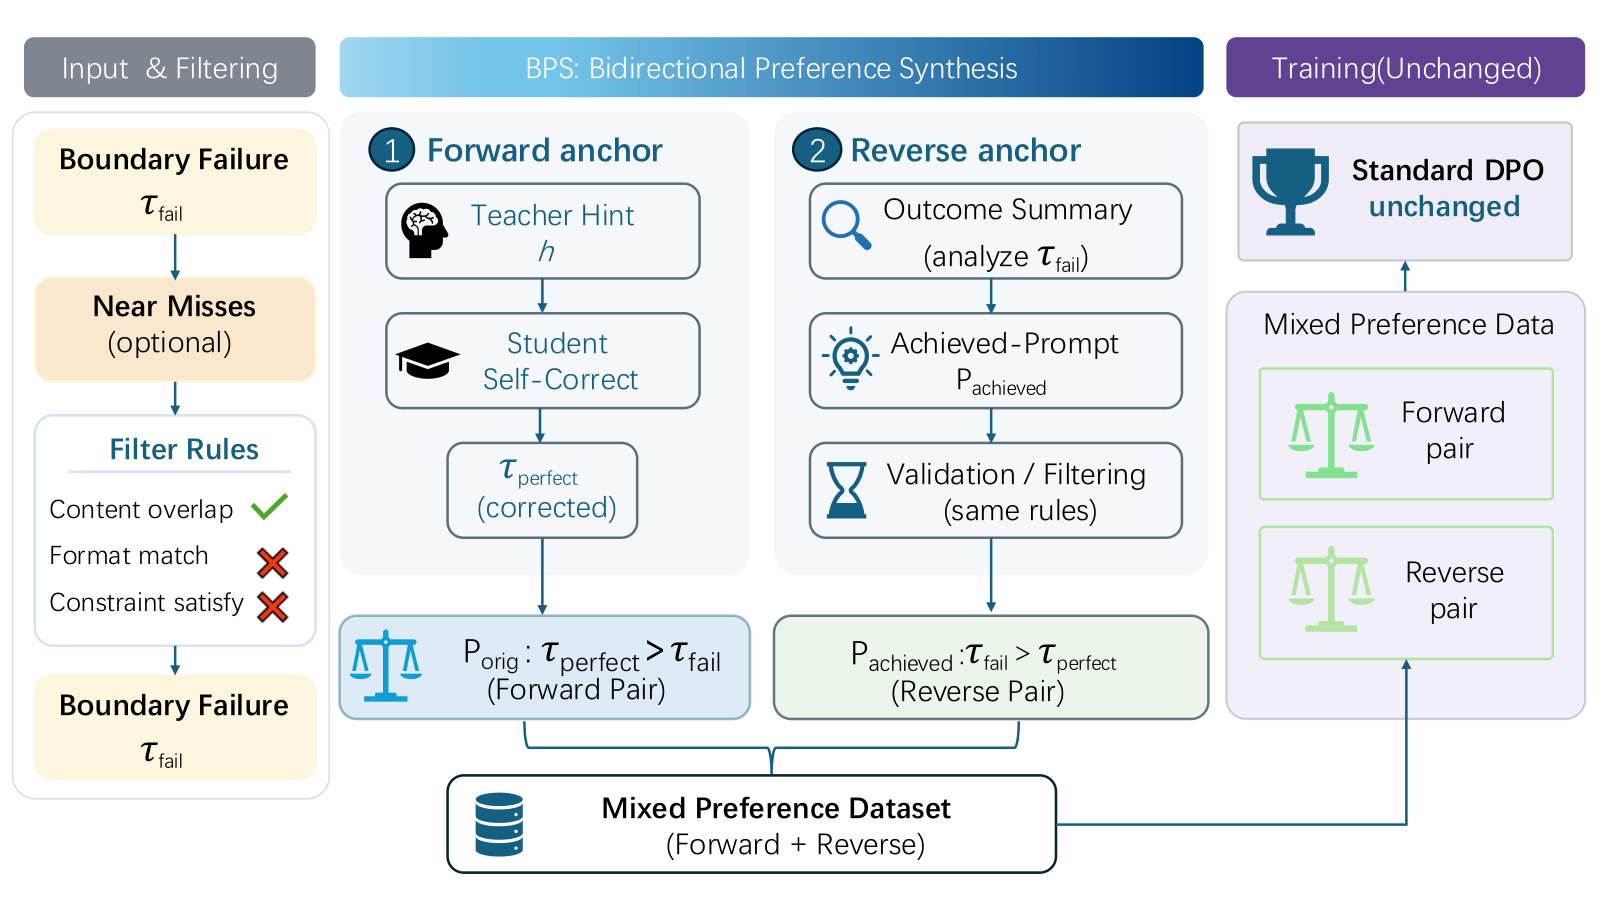
BPS сохраняет обычную пару, а затем строит вторую с теми же ответами. Для неё модель-наставник формулирует достигнутый запрос: самостоятельное задание, которому ошибочный ответ уже соответствует. Направление предпочтения меняется — прежний промах становится победителем, а исправление исходной задачи проигрывает.
Противоречия в разметке нет. Один ответ проигрывает при требовании двух пунктов и выигрывает при требовании трёх; модель учится связывать предпочтение с запросом, а не считать определённую форму ответа безусловно плохой.
Достигнутый запрос нельзя получить простым удалением неудобного ограничения. Он должен явно описывать фактический язык, формат, длину и содержание ответа. Отдельная проверка отбрасывает пары с утечкой текста, неясным предпочтением, фактическими ошибками, небезопасным содержанием или незавершённой задачей.
Где проверяли смену предпочтения
Основной опыт провели на Qwen3-4B-Instruct-2507, а исходные задания взяли из IFBench. Gemini-3.1-pro-preview подсказывал исправления, составлял достигнутые запросы и проверял их; в обучение и итоговую оценку эта модель не входила.
К 1 443 обычным парам добавили 282 проверенные обратные пары. Обучение оставили стандартным: BPS не требует отдельной модели награды, новой функции потерь или генерации свежих ответов во время оптимизации.
Диагностическая проверка измеряла, какой из двух ответов модель ставит выше при исходном и достигнутом запросах. BPS сохранил правильный порядок на исходной стороне и исправил его на достигнутой. Проверка с Kimi-K2.6 вместо модели, которая строила основные данные, показала такое же направление изменения; слепая оценка людьми поддержала обратную разметку.
На Multi-IF преимущество BPS над обычным Forward-DPO выросло с 0,72 процентного пункта в первом ходе диалога до 4,34 в третьем. Это указывает не просто на лучшее соблюдение отдельного формата, а на более устойчивое следование условиям в многоязычном диалоге.
Forward-DPO также начал отвечать заметно длиннее: в IFBench средний ответ достиг 5 920 токенов против 2 565 у BPS. В выбранных авторами проверках кода, работы с инструментами и общих способностей BPS чаще сохранял уровень исходной модели, тогда как обучение только на прямых парах иногда его снижало.
Масштаб выводов задаёт постановка опыта: основную схему строили вокруг пограничных ошибок в инструкциях с проверяемыми требованиями. Отдельный вариант для вызова функций поддержал ту же идею, но использовал другие данные и контрольные точки, поэтому его результаты не смешивали с основным сравнением.
Когда BPS меняет план дообучения
BPS имеет смысл добавить в план, если продукт уже собирает неудачные ответы и исправления для DPO. Реализация оптимизатора остаётся прежней; меняется подготовка набора: нужно распознать частичный успех, сформулировать достигнутый запрос и проверить обратное предпочтение.
Подход особенно подходит для задач с явными ограничениями: форматом документов, языком ответа, обязательными полями, структурой вызова инструмента или правилами многошагового диалога. Фактически команда извлекает второй обучающий пример из ошибки, которую раньше использовала только для наказания модели.
Экономия на изменении обучения не делает подготовку бесплатной. Основной прогон потребовал около 2 500 обращений к модели-наставнику и 5 млн токенов, а качество зависит от строгой фильтрации: неясная обратная пара способна научить модель предпочитать настоящий дефект.
Поэтому BPS не заменяет обычные отрицательные примеры. Бессвязный, ложный или небезопасный ответ по-прежнему должен проигрывать; обратная пара нужна только там, где ответ последовательно выполняет другое правдоподобное задание. Для таких случаев работа предлагает практичное изменение конвейера данных, а не новый способ обучать модель.
Источники
Иллюстрация: рисунок из статьи «Bidirectional Preference Synthesis: Learning Prompt-Conditioned Preferences from Boundary Failures», Junbo Wang (Kuaishou Technology, Nanjing University), Lidong Lu (Nanjing University) и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


