
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Рабочие ML-репозитории научились автоматически превращать в задачи для агентов с заранее заданной сложностью. Хотя работу не рецензировали и числа получили сами авторы, доля полностью решённых задач у лучшей модели снизилась с 95% на простом уровне до 9% на самом трудном. Такой подход позволяет дольше использовать один набор тестов и строить обучение от локальных исправлений к разбору связанных ошибок во всём репозитории.
Размах исправления влияет сильнее размера репозитория
BuggyMLE проверяет агентов для инженерии машинного обучения: они должны исследовать код, запускать обучение, находить причину ухудшения метрики и менять несколько связанных файлов. Это ближе к работе с унаследованным проектом, чем тесты, где модель переписывает один скрипт и получает итоговый балл.
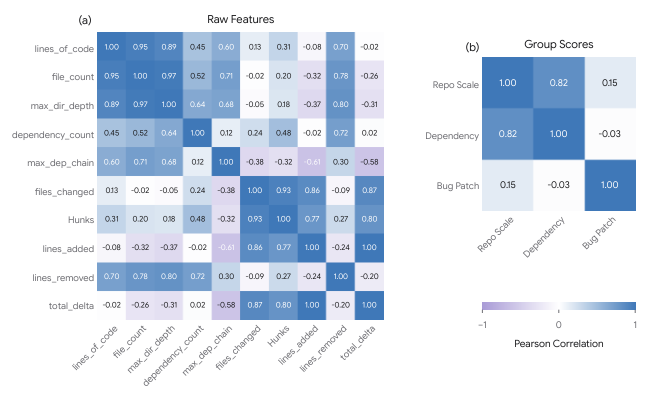
Чтобы оценивать трудность такой задачи до запуска моделей, авторы предложили индекс сложности кода CCI. Он учитывает размер и глубину репозитория, связи между файлами, а также предполагаемый патч: сколько файлов, участков и строк нужно изменить.
Признаки приводят к общей шкале и связывают со средней долей решений через логистическую регрессию. На восьми публичных наборах задач индекс объяснил 95,1% различий в результатах моделей, хотя не использовал сведения о самих моделях.
Сильнее всего на сложность влиял размах патча. Большой репозиторий остаётся посильным, если исправление локально. Задача резко усложняется, когда агенту нужно связать симптомы в разных модулях и согласованно изменить несколько участков кода.
CCI удобен прежде всего при синтезе учебных задач, где правильный патч известен из процесса генерации. Для новой производственной ошибки его нельзя напрямую вычислить до расследования: команда ещё не знает, насколько далеко распространится исправление.
Инъекция ошибок создаёт ступени от локального сбоя до системной поломки
BuggyMLE начинает с рабочего ML-репозитория. Агент-инъектор исследует его через командную оболочку и вносит изменения в подготовку данных, модель, обучение, оценку или формирование результата. Затем система запускает проект и оставляет варианты, где ошибка воспроизводится и измеримо ухудшает результат.
Это не только синтаксические поломки. Среди примеров есть замена ReLU на Sigmoid во внутренних блоках модели и добавление общей константы, которая незаметно меняет порог в другом модуле. Такой код продолжает выполняться, поэтому агенту недостаточно найти исключение или восстановить сборку.
Проверка охватывает 22 многофайловых репозитория и 14 моделей. Агентам давали командную оболочку и разрешали читать, запускать и изменять весь проект, а уровни сложности формировали последовательной инъекцией ошибок.
Авторы разделяют восстановление метрики и полное исправление. Модель может компенсировать оставшийся дефект новой архитектурой или другими параметрами и вернуть итоговый балл, но репозиторий останется повреждённым. Поэтому строгая оценка требует, чтобы модель-оценщик подтвердила устранение каждой внесённой ошибки, а проект продолжил работать.
Это различие делает набор полезнее обычного сравнения метрик. Он проверяет не только способность подобрать удачный эксперимент, но и умение диагностировать исходную причину, вносить ограниченный патч и не маскировать дефекты улучшениями в другом месте.
Командам стоит менять испытательный стенд раньше, чем модель
Работа не доказывает, что синтетические ошибки полностью заменят реальные инциденты. Она показывает практичный способ поддерживать сложность внутреннего набора тестов: брать собственные рабочие репозитории, вносить контролируемые изменения в разные части конвейера и сохранять точный список дефектов для проверки ремонта.
Такой стенд поможет отделить возможности модели от возможностей агентской оболочки. Если агент получает весь репозиторий и обычные инструменты командной строки, результат меньше зависит от специализированного механизма, который заранее подсказывает, какой файл переписать или какой эксперимент провести.
Градация также даёт основу для учебной программы. После обучения Qwen3.5-9B на задачах разной сложности доля решённых задач SWE-bench Lite выросла с 24% до 33%. Перенос за пределы ML указывает, что модель училась не только узнавать конкретные инъекции, но и системнее исследовать репозиторий, проверять гипотезы и завершать исправление.
Для продуктовой команды главный вывод относится к критерию приёмки. Если тест считает успехом только восстановленную бизнес- или ML-метрику, агент может оставить скрытые дефекты. Нужны отдельные проверки причинного исправления: ожидаемый патч, регрессионные тесты и аудит связанных модулей.
Источники
Иллюстрация: рисунок из статьи «BuggyMLE: Scaling Machine Learning Engineering Difficulty with Bug Injection», John Wu, Rushi Qiang, Yuchen Zhuang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


