
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
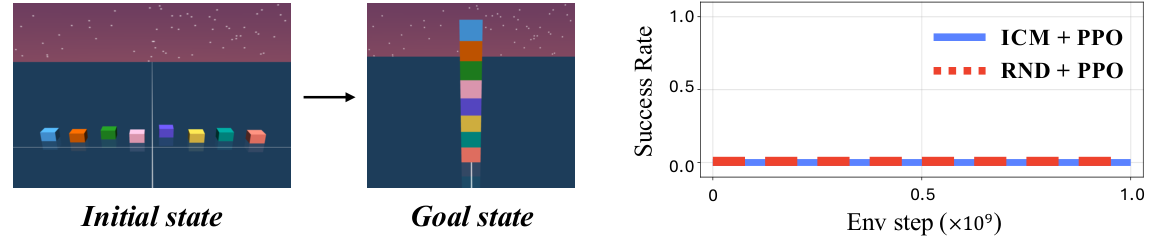
Агент научился разбивать далёкую цель на меняющееся число промежуточных точек и за счёт этого осваивать длинные задачи без внешних наград, демонстраций и готовых моделей. В препринте Seoul National University и Princeton University, который не прошёл рецензирование и где числа получили сами авторы, C-Slerp сложил башню из пяти кубов манипулятором, тогда как все проверенные альтернативы не добились ни одного успеха. Работа предлагает упростить верхний уровень иерархической системы: вместо отдельной нейросети или поиска по графу использовать геометрию уже выученных представлений.
Гиперсфера превращает представления в маршрут
C-Slerp опирается на контрастивное обучение с подкреплением. Система учится отличать состояния, которые действительно следуют друг за другом, от случайно подобранных пар, и кодирует состояния как точки на единичной сфере в многомерном скрытом пространстве.
Обычное скалярное произведение двух таких векторов симметрично: оценка пути от первого состояния ко второму совпадает с оценкой обратного пути. Динамика среды так не устроена, поэтому C-Slerp добавляет обучаемое вращение. Оно сохраняет сферическую геометрию, но позволяет учитывать направление перехода.
Начальное состояние и цель задают концы дуги на гиперсфере. Сферическая линейная интерполяция расставляет между ними промежуточные представления вдоль кратчайшей дуги. Низкоуровневая политика получает не полное состояние подцели, а её вектор и пытается приблизиться к нему.
Отдельно обучать верхнюю политику не требуется: промежуточные точки вычисляются напрямую. Не нужен и граф из ранее посещённых состояний, поэтому качество плана не зависит от того, удалось ли заранее собрать подходящий набор узлов для поиска.
Число точек C-Slerp тоже извлекает из геометрии. Система несколько раз применяет выученное вращение к текущему состоянию и проверяет, после какого числа переходов направление лучше совпадает с целью. Из этих оценок она выбирает длину плана, а затем передаёт политике самую далёкую подцель, которую та уже способна достичь.
Фиксированный план мешает и в начале, и у финиша
Метод проверили на навигации в лабиринтах JaxGCRL и на роботизированных задачах BuilderBench, включая построение башен до восьми кубов. Обучение шло полностью онлайн: агент наполнял буфер собственными переходами и одновременно обновлял представления и политику. Отдельного набора данных или программы постепенного усложнения целей не было.
В длинных задачах прежние методы исследования среды не нашли успешного состояния даже за миллиард шагов взаимодействия. C-Slerp достигал целей за счёт промежуточных ориентиров, в том числе когда на протяжении обучения агенту задавали одну фиксированную удалённую цель.
Простого добавления иерархии оказалось недостаточно. Если заранее зафиксировать число промежуточных точек, результат ухудшается: длинной задаче в начале не хватает этапов, а возле цели тот же план становится избыточным. На визуализациях скрытого пространства C-Slerp сокращает маршрут по мере завершения башни или приближения к выходу из лабиринта.
Так же ведёт себя выбор текущей подцели. Ближайшая точка безопаснее, но замедляет продвижение; далёкая ускоряет его, пока остаётся достижимой. Лучший фиксированный вариант различался между башнями и лабиринтами, тогда как оценка низкоуровневой политики позволяла выбирать подходящую точку заново.
Границы проверки узкие: эксперименты проходили в симуляции и получали состояния среды в готовом числовом виде. Метод требует большого числа взаимодействий, а обучение по изображениям, работа с заранее собранными данными и перенос на физического робота в эксперименты не входили.
Менять архитектуру рано, но адаптивный план стоит проверить
Для команд, которые уже строят целевые агенты на контрастивных представлениях, работа даёт конкретный вариант верхнего уровня. Если политика принимает вектор цели, поверх неё можно вычислять промежуточные ориентиры без ещё одной нейросети и без поддержки поискового графа. Это сокращает число обучаемых компонентов, но не устраняет стоимость сбора переходов.
Главная инженерная гипотеза работы касается не гиперсферы самой по себе, а меняющейся глубины разбиения. При прототипировании полезно сравнить адаптивный вариант с тем же агентом при фиксированной длине плана. Такое сравнение отделит выигрыш от новой геометрии от выигрыша, который даёт сама иерархия.
Пересматривать планы реального робототехнического продукта на основании этой работы пока не следует. Выводы напрямую относятся к симуляторам с доступом к состоянию среды и дешёвым онлайн-взаимодействием. Для систем с камерами, дорогими действиями или обучением на накопленных журналах сначала потребуется подтвердить, что представления сохраняют нужную сферическую структуру и позволяют выбирать достижимые подцели.
Источники
Иллюстрация: рисунок из статьи «Hyperspherical Contrastive Representations Unlock Planning and Exploration», Jonghae Park, Sungil Son, Jonghun Shin и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


