
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
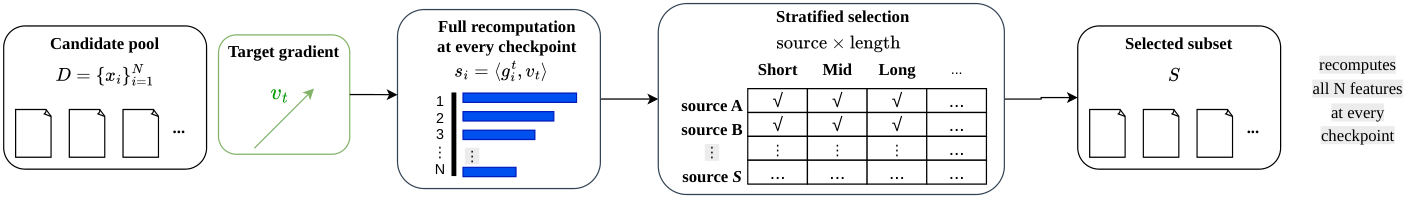
Градиентные признаки примеров для отбора данных можно не пересчитывать на каждом новом срезе модели: достаточно обновлять кандидатов в верхней части старого рейтинга. Работа University of Connecticut, которая не проходила рецензирование и содержит замеры самих авторов, сократила этап расчёта градиентов в 3,5–3,6 раза при точном восстановлении набора, выбранного полным пересчётом. Для повторного отбора данных это превращает полный проход по пулу в кэш с выборочным обновлением, но требует контролировать разнообразие итогового набора.
Старые признаки сохраняют рейтинг, но ошибаются у порога отбора
Методы наподобие LESS представляют каждый обучающий пример вектором его градиента. Затем они вычисляют градиент на проверочных данных целевой задачи и поднимают в рейтинге примеры, чьи векторы направлены сходным образом.
Дороже всего получить отдельный градиентный признак для каждого кандидата. Градиент целевой задачи считают на небольшом проверочном наборе, поэтому его можно обновлять при каждом срезе модели без сопоставимых затрат.
Авторы взяли признаки, сохранённые после разогрева модели, и объединили их со свежим градиентом целевой задачи. Через сорок шагов оптимизатора корреляция старого и полностью пересчитанного рейтингов оставалась в диапазоне 0,952–0,991. Однако при отборе верхних 10% старый рейтинг пропускал от 10 до 22% примеров, которые выбрал бы полный пересчёт.
Высокая корреляция всего списка поэтому не гарантирует одинаковый обучающий набор. Для селектора важнее область около порога: небольшая перестановка там меняет состав данных, хотя почти не влияет на общую метрику.
CDIS обновляет верхушку рейтинга и проверяет кэш на месте
Метод Cached Diverse Influence Selection, или CDIS, сначала оценивает весь пул по сохранённым признакам и свежему градиенту проверочного набора. Затем он полностью пересчитывает признаки только у кандидатов с наивысшими старыми оценками и записывает их обратно в кэш.
На обновлённых примерах известны обе оценки: старая и точная. По ним CDIS подбирает линейную поправку, приводит оставшиеся старые оценки к новой шкале и собирает единый рейтинг из пересчитанных и скорректированных значений.
Нижнюю границу бюджета задаёт доля отбора: обновлять меньше кандидатов, чем должно попасть в итоговый набор, недостаточно. Дополнительный запас зависит от того, насколько сдвинулись оценки около порога. При обновлении 30% пула CDIS во всех проверенных условиях восстановил тот же верхний набор, что и полный пересчёт.
Та же выборка даёт проверку безопасности кэша без отдельного прохода. Если порядок старых и новых оценок на обновлённых примерах расходится, интервал между срезами оказался нестабильным: бюджет обновления следует увеличить или выполнить полный пересчёт.
После оценки CDIS применяет квоты по источникам и длине запросов. Без них высокий балл влияния не гарантирует полезный набор: селектор может заполнить его одним источником и узким диапазоном длин. Линейная поправка исправляет устаревшие оценки, но не исправляет перекос правила отбора.
Повторный отбор дешевеет, но одноразовый конвейер почти не выигрывает
Метод проверяли на Qwen3-4B-Base и Llama-3.2-1B, задачах GSM8K и MMLU, а также на пулах из GSM8K с Dolly или FLAN-v2. Основной пул содержал 10 000 кандидатов; итоговые адаптеры обучали через LoRA, а качество измеряли точным совпадением ответа на GSM8K и ASDiv.
Полный проход всё равно нужен, чтобы построить начальный кэш, поэтому выигрыш появляется со второго цикла отбора. В устойчивом повторяющемся конвейере CDIS сократил полную стоимость одного цикла в 3,37 раза; само последующее обучение модели не ускорилось.
Экономия оказалась не бесплатной. На GSM8K набор CDIS дал на 12,2 процентного пункта больше случайного отбора, но уступил стратифицированному отбору с полным пересчётом на 4,3 пункта. Этот разрыв сопоставим с разбросом между повторными запусками обучения, однако во всех повторных сравнениях CDIS оставался ниже полного варианта.
Работа меняет планы команд, которые пересобирают обучающий набор по мере изменения модели. В таком конвейере имеет смысл хранить градиентные признаки вместе с версией среза, обновлять верхнюю часть рейтинга и автоматически переходить к полному проходу при падении согласованности.
Для одноразового отбора преимущество слабее: сначала всё равно придётся вычислить признаки всего пула. Метод также не заменяет правила разнообразия. Если источники и длины примеров не контролируются, точный рейтинг способен дать результат хуже случайного набора — независимо от того, взят он из кэша или пересчитан полностью.
Источники
Иллюстрация: рисунок из статьи «Refreshing Less, Selecting Better: Reusing Stale Gradient Features for Efficient Influence-Based Data Selection», Jianchang Su, Yifan Zhang, Wei Zhang, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


