
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Caddie научили давать LLM-агенту полезный совет в середине многошаговой задачи. В нерецензированном препринте, где все числа получили сами авторы, критик Qwen3-4B поднял долю успеха на MuSiQue более чем на 25 процентных пунктов. Для продуктовой команды это вариант отдельного управляющего модуля: базовую модель можно не дообучать, а советчик переносить между агентами.
Как итог задачи превращают в сигнал для обучения
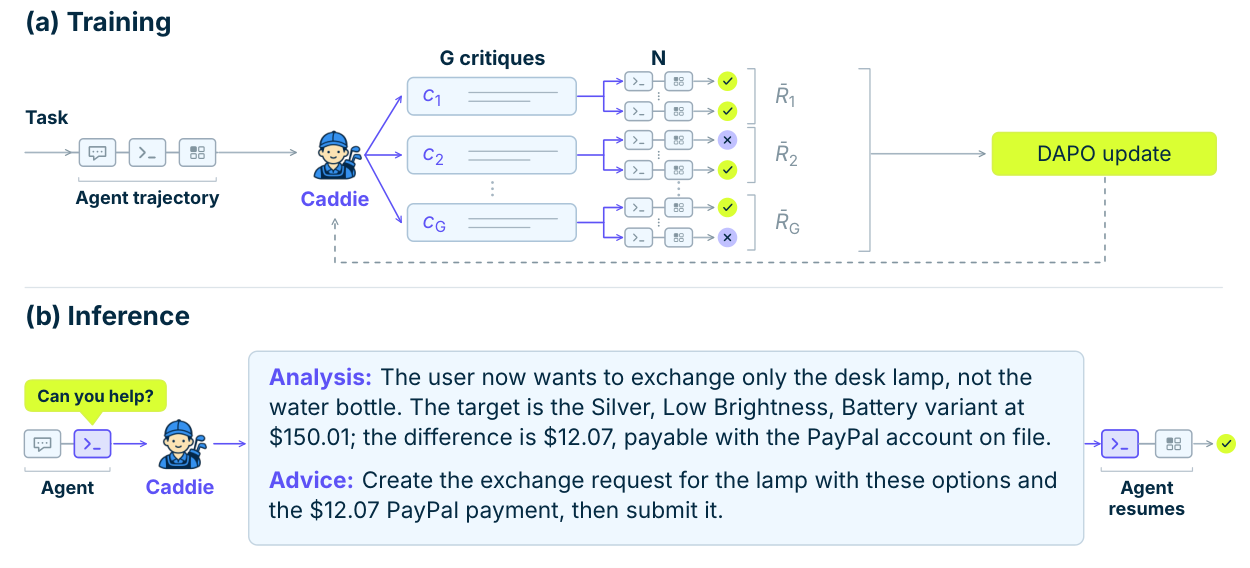
Критик получает цепочку действий агента и ответов среды до случайно выбранного промежуточного шага. Он анализирует текущее положение, указывает возможную ошибку и предлагает следующие действия обычным текстом.
Из одного состояния критик генерирует 16 вариантов совета. Замороженный агент продолжает задачу после каждого варианта, а финальный результат становится оценкой совета. В основных запусках для каждого текста выполняли одно продолжение, поэтому обучение сравнивало советы внутри группы, а не пыталось точно измерить пользу каждого из них отдельно.
Параметры обновляют только у критика с помощью DAPO — варианта обучения с подкреплением, который повышает вероятность советов с лучшим итогом относительно других текстов из той же группы. Размечать каждый шаг как правильный или ошибочный не нужно. Не нужны и эталонные критические замечания, написанные человеком или более крупной моделью.
Во время работы агент сам вызывает критика через отдельный инструмент и получает совет как ответ среды. В основных тестах разрешали до трёх обращений за задачу. Это избавляет от жёсткого расписания: помощь не приходит на каждом шаге, а запрашивается тогда, когда базовая модель считает её нужной.
Такой способ обучения требует ветвить выполнение из одного и того же состояния. Среда должна позволять восстановить его, запустить несколько продолжений и автоматически проверить конечный результат. Для внешних инструментов с необратимыми действиями или дорогими вызовами это заметное архитектурное условие, а не только вопрос обучения модели.
Один критик помогает разным базовым моделям
На MuSiQue с приложенными материалами успех Qwen3-4B вырос с 21,56% до 46,88%. На ALFWorld прибавка составила 25,93 процентного пункта. В обоих случаях обученный советчик оказался полезнее критиков того же класса, которым просто дали инструкцию анализировать действия агента.
Критика обучали на продолжениях Qwen3-4B, а затем без адаптации подключили к Qwen3-30B-A3B, Qwen3.8-27B и Kimi K3. На MuSiQue с приложенными материалами он улучшил все базовые модели; для Kimi K3 прибавка достигла 12,44 процентного пункта. При поиске в Wikipedia перенос оказался слабее: в одном сочетании прирост не достиг одного пункта.
Совет переносился и между типами задач. Критик, обученный на многошаговых вопросах MuSiQue, помогал в DeepDive с веб-поиском и в τ3, где агент ведёт диалог с клиентом и вызывает инструменты по правилам розничной торговли или авиакомпании. Вариант, обученный с поиском в Wikipedia, улучшил средний результат во всех проверенных сочетаниях задачи и базовой модели.
Перенос не означает, что критик выдаёт один универсальный шаблон. В разборе ответов он советовал небольшой модели продолжать поиск, когда та останавливалась без достаточных доказательств. Более крупной модели тот же критик чаще предлагал прекратить поиск и ответить по уже собранным данным.
Когда работа меняет план агентной системы
Результат поддерживает архитектуру с отдельным советчиком, если продукт уже состоит из многошагового агента, инструментов и проверяемого конечного исхода. Критика можно обучить с одной базовой моделью, оставить исполнитель неизменным и затем проверить тот же модуль с другими моделями. Это сокращает зависимость от пошаговой разметки и позволяет менять исполнитель без немедленного повторного обучения советчика.
Проверка охватывает двести вопросов MuSiQue, официальный набор из 134 игр ALFWorld и меньшие выборки DeepDive и τ3. Для MuSiQue и ALFWorld обучали отдельные критики, а перенос между предметными областями проверяли только у вариантов MuSiQue. Все обученные критики основаны на Qwen3-4B, поэтому работа не показывает, как размер самого советчика влияет на качество и перенос.
Caddie рассчитан на задачи, где после совета агент ещё должен взаимодействовать со средой. В короткой задаче без инструментов критик может научиться не направлять исполнителя, а сразу писать готовое решение, которое тот скопирует. Тогда модуль превращается во второго решателя и теряет предполагаемую независимость от модели и области.
Для внедрения нужен пилот на собственных траекториях: среда должна воспроизводить состояние, итог — проверяться автоматически, а цена дополнительных продолжений — укладываться в бюджет. Если эти условия выполняются, работа даёт практический путь к обучению агента на конечном бизнес-результате без отдельной разметки каждого решения по ходу процесса.
Источники
Иллюстрация: рисунок из статьи «Training Advisors for LLM Agents from Task Outcomes», Sergei Polezhaev, Barys Liskavets, Ori Press и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


