
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Сильная модель передаёт слабой не только знания, но и собственную неустойчивость: вероятность одного и того же токена меняется из-за формулировки дополнительного контекста. В препринте, который не прошёл рецензирование и приводит числа из замеров самих авторов, Qiangqiang He, Jin Li и MingCai Chen сохранили лишь 52–65% исходного обучающего сигнала и получили результат лучше стандартной дистилляции. Для команд, которые дообучают рассуждающие модели на их собственных ответах, это меняет критерий отбора данных: полезен не весь разрыв с учителем.
Почему разница между учителем и учеником загрязнена
При дистилляции на ответах ученика (on-policy distillation) слабая модель сама генерирует решение. Затем учитель и ученик оценивают вероятность каждого токена в этом решении, а разница между оценками становится обучающим сигналом. Если учитель считает токен более вероятным, ученик должен чаще выбирать его в похожем контексте.
Такой подход предполагает, что вероятность от учителя служит устойчивым ориентиром. Работа показывает, что это не всегда так: дополнительная инструкция, оценка решения или эталонный ответ сдвигают вероятность токена, хотя задача, уже созданное решение и проверяемый токен остаются прежними.
Особенно часто сдвигались слова, которые организуют изложение, но не несут математическое содержание. У форм вроде maybe, however и therefore заметное отклонение возникало примерно в девяти случаях из десяти. У цифр, математических символов и элементов формул доля оставалась ниже 9,3%.
Знак дополнительной информации тоже не гарантировал осмысленной реакции. Положительный и отрицательный контекст часто сдвигали вероятность в одну сторону, даже когда один называл решение правильным, а другой — ошибочным. Значит, часть разрыва между учителем и учеником отражает реакцию учителя на форму контекста, а не знание о задаче.
Это объясняет риск дистилляции с привилегированной информацией. Эталонное решение или правильный ответ может сделать учителя полезнее, но одновременно сильнее меняет его распределение вероятностей. Если переносить весь сдвиг без разбора, ученик копирует и подсказку, и вызванные ею побочные колебания.
Как Cal-OPD измеряет ненадёжную часть сигнала
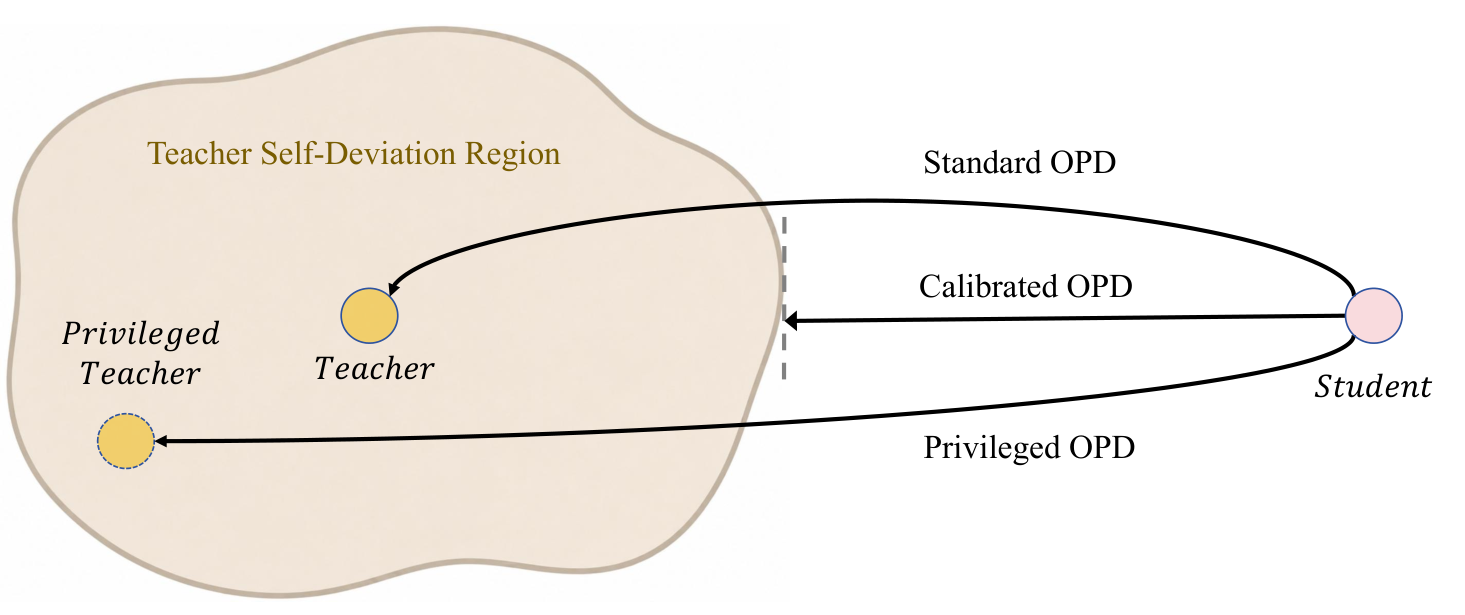
Cal-OPD оставляет траекторию ученика неизменной и дважды добавляет контекст только учителю. В основной конфигурации это положительная и отрицательная оценки решения. Модель сравнивает получившиеся вероятности с исходной оценкой учителя и строит для каждого токена диапазон, внутри которого изменение считает собственной неустойчивостью учителя.
Если вероятность ученика попадает в этот диапазон, токен не создаёт обучающего сигнала. Если она лежит снаружи, Cal-OPD использует только расстояние до ближайшей границы, а не полный разрыв с исходной оценкой учителя. Дополнительный контекст здесь ничего напрямую не преподаёт ученику: он служит измерительным инструментом.
Выбор вмешательства оказался существенным. Оценка правильности без эталонного решения дала лучший средний результат. Полное решение расширяло предполагаемый диапазон неустойчивости слишком сильно, поэтому метод отбрасывал вместе с шумом часть сведений о задаче. Простое ослабление всего сигнала также работало хуже: значение имеет граница для конкретного токена, а не единый коэффициент.
Метод проверяли на парах Qwen3-4B-Thinking-2507 и Qwen3-1.7B, а также Qwen3-30B-A3B-Thinking-2507 и Qwen3-4B. Обучение и оценка охватывали математические задачи AMC23, AIME24, AIME25, AIME26, HMMT26 и MATH500. Поэтому результаты относятся к дистилляции длинных математических рассуждений на моделях Qwen, а не ко всем видам генерации.
Что Cal-OPD меняет в плане обучения
Cal-OPD превзошёл стандартную дистилляцию в обеих парах моделей: средний выигрыш составил 2,3 и 3,1 пункта. Лучший результат он показал в 7 из 12 сочетаний бенчмарка и пары моделей. Стандартный метод во второй конфигурации ухудшил исходного ученика, хотя учитель был сильнее.
Фильтрация также сдержала рост ответов. Стандартная дистилляция поощряла более длинные рассуждения, тогда как Cal-OPD завершил обучение с более короткими траекториями. Несмотря на дополнительные вычисления учителя, в описанной конфигурации обучение прошло в 1,26 раза быстрее именно за счёт сокращения ответов.
Работа не требует менять архитектуру модели или формат собранных задач. Она меняет цикл эксперимента: кроме качества учителя, стоит измерять, насколько устойчивы его вероятности при контрастных вариантах контекста, и сравнивать полную дистилляцию с фильтрацией на уровне токенов.
Практический вывод не сводится к тому, чтобы отбрасывать фиксированную долю сигнала. Слишком широкая граница удаляет полезные различия, а слишком узкая возвращает шум. Команде потребуется подобрать вмешательства и степень фильтрации на своей предметной области; параметры из математических задач нельзя переносить как готовые.
Источники
Иллюстрация: рисунок из статьи «Calibrating Teacher--Student Discrepancy for On-Policy Distillation», Qiangqiang He, Jin Li, MingCai Chen, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


