
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Скрытые состояния отбракованных токенов можно вернуть в работу, чтобы точнее подготовить следующий блок ответа. В препринте NAVER Cloud и Seoul National University, который не прошёл рецензирование и содержит замеры самих авторов, Carryover Drafting увеличил среднее число принятых токенов на 6,5–14,7%. Для команд, уже внедряющих спекулятивное декодирование (speculative decoding), это способ ускорить генерацию без замены основной модели.
Отбракованный токен всё ещё хранит полезный вариант продолжения
При спекулятивном декодировании небольшая черновая модель предлагает сразу блок токенов, а основная модель проверяет их за один проход. Она принимает правильный префикс, добавляет следующий токен и отбрасывает остаток блока. Чем длиннее принятый фрагмент, тем реже приходится запускать основную модель.
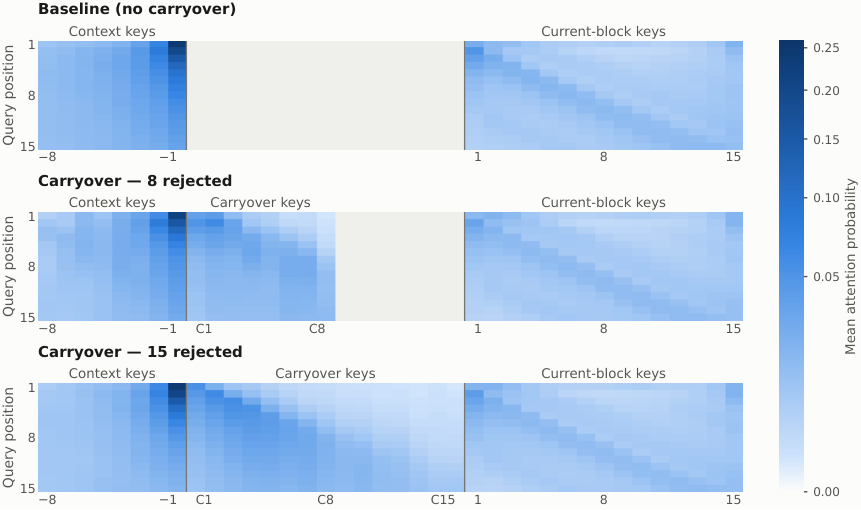
Проверка вычисляет внутренние представления для всего предложенного блока, включая ошибочную часть. Обычные черновые модели сохраняют состояния принятых токенов, а состояния после первой ошибки удаляют. Carryover Drafting передаёт их следующему черновику как временный KV-контекст — набор ключей и значений, к которым обращается механизм внимания.
Метод использует те же слои проекции, через которые черновая модель уже получает состояния принятого контекста. Единственный новый обучаемый элемент — вектор, который помечает состояния как отклонённые. Благодаря этой метке модель может учитывать полезные сигналы и снижать вес состояний, которые уводят продолжение в сторону.
Отклонённые состояния доступны только для чтения: они не попадают в KV-кэш основной модели и не заменяют принятый контекст. После следующей проверки старый набор удаляется, а его место занимает новый. Поэтому дополнительный контекст не растёт вместе с ответом и всегда ограничен одним предложенным блоком.
Ошибка в начале блока не делает все последующие состояния бесполезными. Отбракованная ветка может через несколько позиций снова приблизиться к продолжению, которое выберет основная модель. В анализе Carryover помогал сильнее на задачах, где такое повторное схождение встречалось чаще.
Обучение воспроизводит ошибки, которые возникнут при генерации
Обычное параллельное обучение черновика использует заранее записанные ответы основной модели. Оно не показывает состояния, которые возникнут, когда основная модель начнёт проверять собственные ошибки черновика. Последовательное разыгрывание полной генерации решило бы эту проблему, но лишило бы обучение параллелизма.
Авторы построили переход «черновик — проверка — черновик» независимо для каждой выбранной позиции ответа. Сначала черновая модель предлагает продолжение без расчёта градиентов. Замороженная основная модель параллельно проверяет предложения, после чего второй черновик получает отклонённые состояния и учится предсказывать записанное продолжение с новой позиции.
Градиенты проходят только через второй черновик, его существующие слои проекции и новую метку Carryover. Так обучение видит те же состояния, которые появятся при генерации, но не запускает длинную последовательную симуляцию для каждого примера.
Метод проверили с Qwen3-4B и Gemma 4 12B, параллельным DFlash и полуавторегрессионным Markov на задачах кода, математики, диалога, поиска по контексту, суммаризации, вызова инструментов и перевода. Замеры провели в vLLM на одной H200 при детерминированной и случайной генерации; длину проверяемого блока фиксировали, а адаптивное управление ею отключили.
Средний принятый фрагмент стал длиннее во всех проверенных сочетаниях модели, черновика и задачи. Сквозное ускорение vLLM относительно соответствующего исходного варианта выросло на 7,9–14,4%, то есть дополнительная работа с контекстом не съела выигрыш. На переводе прирост скорости достиг 28,8%, а при разных уровнях параллельной нагрузки Carryover сохранял преимущество.
Метод меняет планы только для команд с доступом к черновику
Carryover не служит универсальной надстройкой над любым API. Для него нужны скрытые состояния основной модели, управляемая черновая модель и возможность менять её обучение и путь генерации. При работе только через закрытый API такой доступ обычно отсутствует.
Для собственной системы на основе DFlash или родственного блочного черновика интеграция выглядит локальной: повторно использовать имеющиеся проекции, добавить обучаемую метку и выделить сменяемый участок KV-контекста. Однако взять готовую контрольную точку и включить перенос состояний только при генерации недостаточно. Черновик должен заранее научиться отличать отклонённую ветку от подтверждённого контекста.
При прототипировании нужно измерять две величины вместе: сколько дополнительных токенов принимает основная модель и сколько времени черновик тратит на проекцию и внимание к перенесённым состояниям. Рост длины принятого фрагмента сам по себе не гарантирует ускорения, если новый контекст перегружает черновик.
В работе проверяли фиксированную длину верификации, но не сочетание Carryover с адаптивным планировщиком DSpark. Если производственная система меняет размер блока по оценке уверенности, Carryover придётся обучать с той же политикой: планировщик влияет на то, какие отклонённые состояния модель увидит в следующем раунде.
Работа не требует пересматривать выбор основной LLM, но добавляет отдельный пункт в план оптимизации собственной генерации. Вместо дальнейшего усложнения черновика команда может сначала проверить, окупается ли повторное использование вычислений, которые основная модель уже выполнила и обычно выбрасывает.
Источники
Иллюстрация: рисунок из статьи «Carryover Drafting: Recycling Rejected States for Speculative Decoding», Jahyun Koo, Sunghyeon Woo, Jaeeun Kil и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


