
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
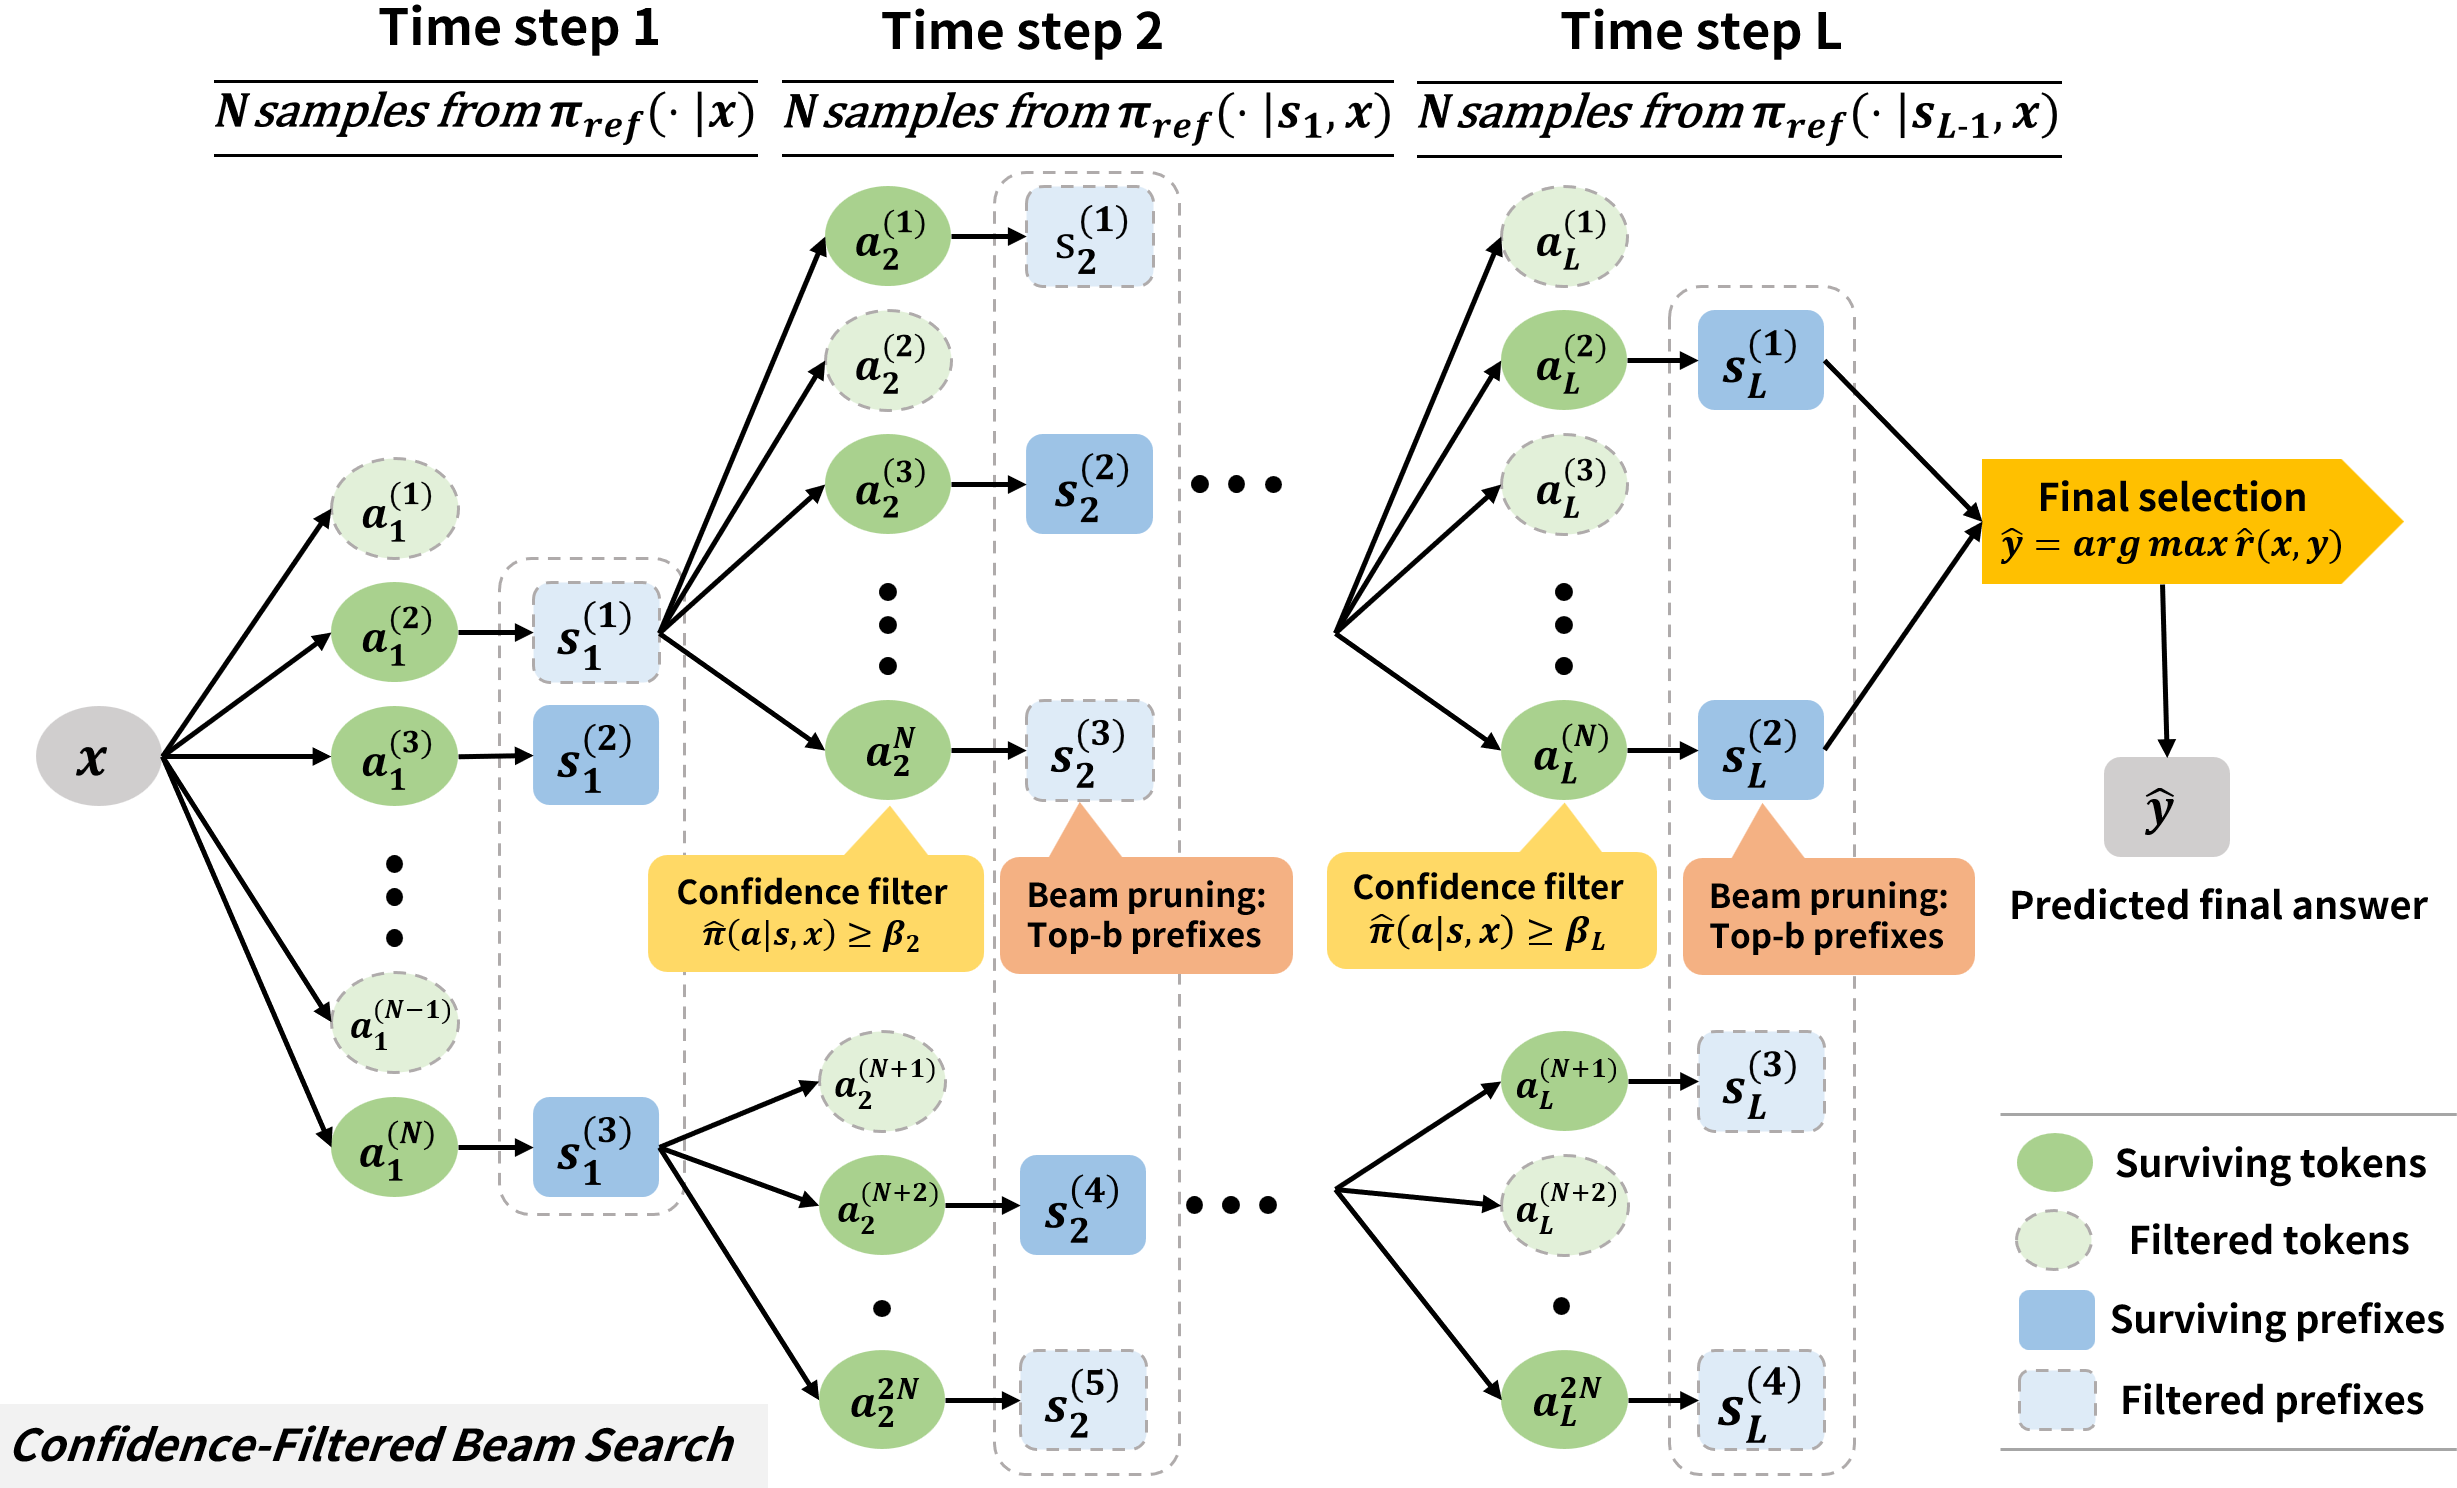
Для LLM вывели условие, при котором правильная цепочка рассуждений переживает поэтапный отсев вариантов. В препринте, который не прошёл рецензирование и содержит замеры самих авторов, CF-Beam меняет квадратичную зависимость числа проб от сложности нужного токена на почти линейную. Для длинных ответов это довод фильтровать редкие продолжения до сокращения списка кандидатов, а не только увеличивать бюджет генерации.
Работа разбирает лучевой поиск: модель на каждом шаге создаёт продолжения, оценивает их по собственной вероятности и оставляет несколько лучших цепочек. Авторы измеряют сложность через коэффициент покрытия токена C — величину, обратную вероятности получить нужный токен. Чем реже модель предлагает правильное продолжение, тем больше C.
В специально построенном трудном случае обычному лучевому поиску недостаточно N ≤ C²/16 проб на префикс: с вероятностью не меньше половины он безвозвратно отбрасывает правильный ответ. Причина в редких токенах, которые случайно получают завышенную оценку и вытесняют нужный префикс. CF-Beam сначала удаляет продолжения с оценённой вероятностью ниже порога, а затем выбирает лучшие цепочки; при фиксированных длине ответа, разрыве между префиксами и требуемой точности достаточное число проб зависит от C почти линейно.
Гарантия действует, когда правильный префикс на каждом шаге вероятнее конкурентов с устойчивым разрывом. Без этой связи внутренняя вероятность модели может вести поиск в сторону от ответа, который получит лучшую итоговую награду. Внешняя модель вознаграждения здесь оценивает только завершённые ответы; существует и вариант без неё, где итог выбирают по вероятности всей цепочки.
Проверки охватывают синтетический симулятор с шумной моделью вознаграждения и 500 задач на умножение целочисленных матриц с Qwen3-1.7B-Base. CF-Beam сравнивали с обычным лучевым поиском, Best-of-N, Majority Voting и Best-of-Majority. Теоретический порог зависит от вероятности правильного токена, которую рабочая система заранее не знает, поэтому в опытах также использовали приближённый порог относительно самого вероятного продолжения.
Источники
Иллюстрация: рисунок из статьи «Provable Test-Time Scaling for Beam Search in LLM Reasoning», Qijia He, Yu Huang, Yuan Cheng и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


