
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
ChainFlow ускорил генерацию Qwen3.5, не меняя токены, которые выбирает целевая модель. В одинаковых условиях он обошёл EAGLE-3 по пропускной способности на 39%, а DFlash — на 11%. Поскольку препринт не рецензирован и числа получили сами авторы, перед сменой стека результат стоит проверить на собственной нагрузке.
Черновик начинается со скрытых состояний целевой модели
При обычной генерации LLM выбирает токены последовательно. Каждый новый токен требует ещё одного прохода по модели, поэтому длинные ответы увеличивают задержку почти пропорционально своей длине.
Спекулятивное декодирование передаёт часть работы небольшому черновому модулю. Он предлагает продолжение, а целевая модель проверяет весь блок параллельно, принимает подходящий префикс и сама заменяет первый отклонённый токен. Поэтому итог по-прежнему определяет целевая модель, а черновик влияет только на скорость.
Последовательные черновые модули хорошо учитывают связь между токенами, но платят отдельным вычислением за каждый из них. Параллельные готовят весь блок сразу, однако рассматривают его позиции почти независимо: если начало пошло по другой ветке, качество следующих предложений быстро падает.
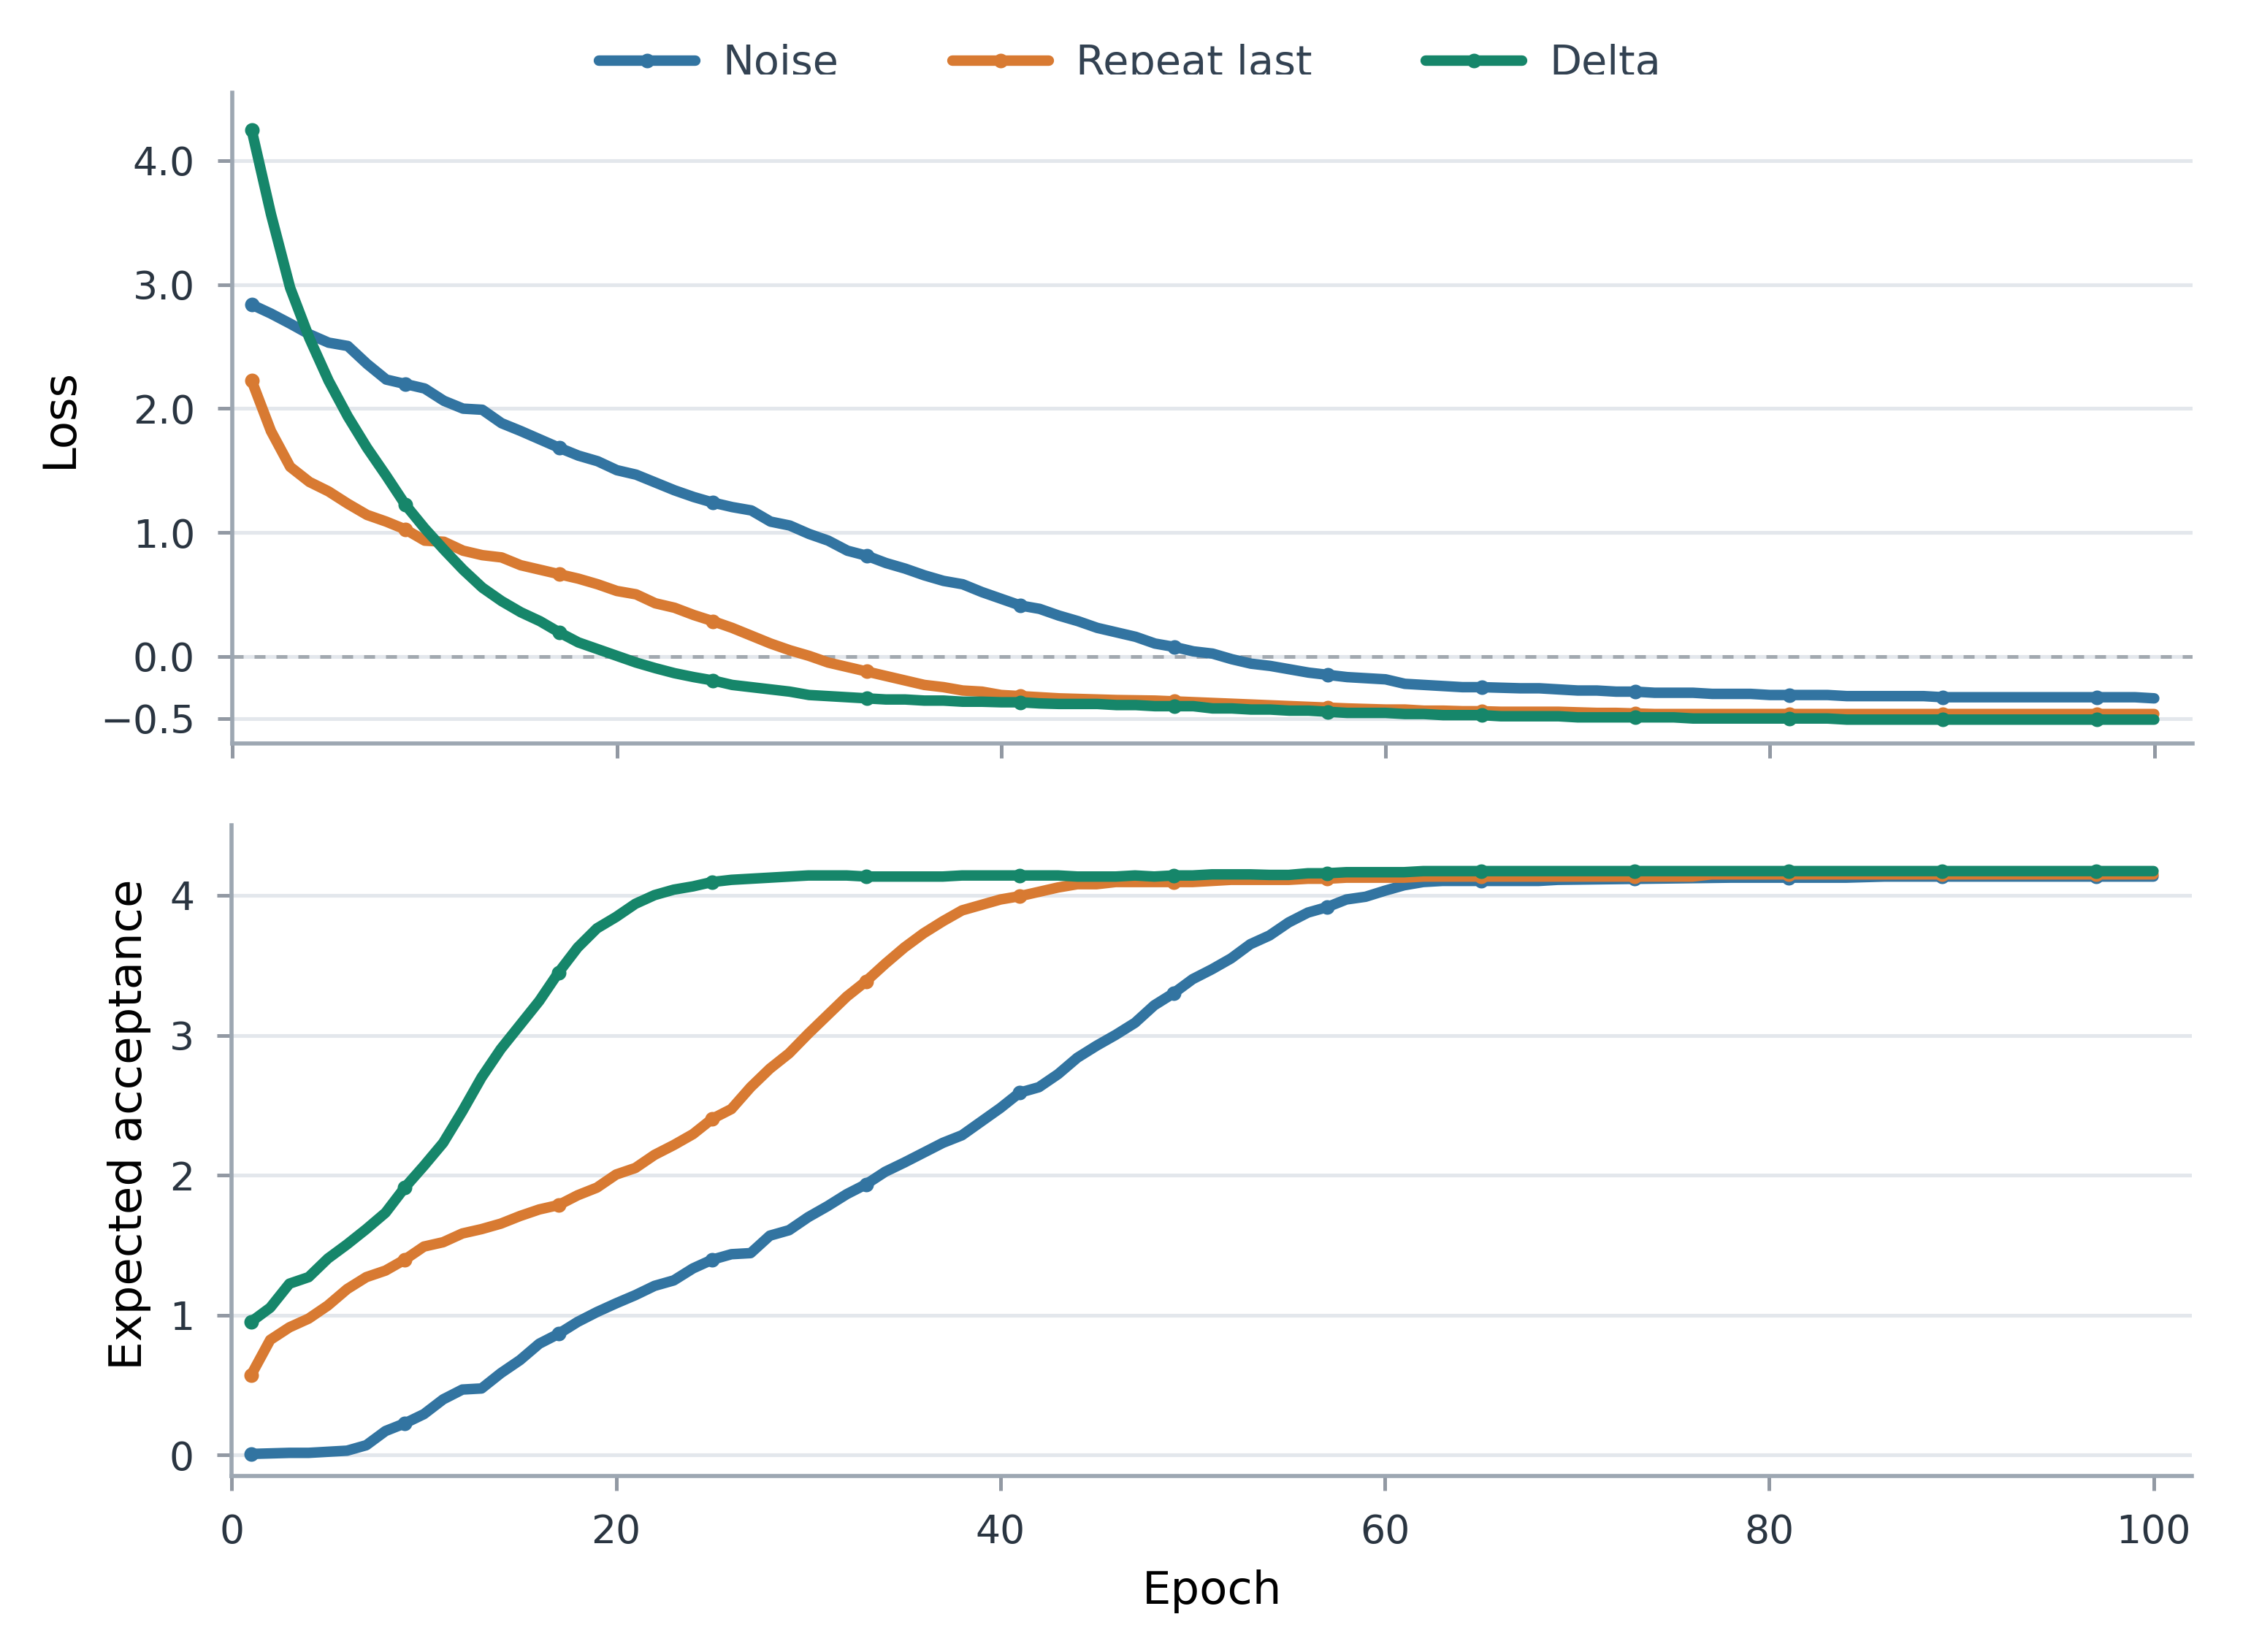
ChainFlow берёт исходную точку не из шума, а из недавних скрытых состояний Qwen3.5. Вариационный автокодировщик сжимает их, после чего обученный поток переносит продолжение к будущим состояниям модели. За один шаг серверной генерации модуль готовит восемь позиций, а замороженный выходной слой Qwen3.5 превращает полученные состояния в вероятности токенов.
Сам по себе параллельный прогноз всё ещё не знает, какой токен выбрали на предыдущей позиции. ChainFlow исправляет это двумя небольшими добавками: одна учитывает предыдущий токен, другая — весь уже выбранный путь. Они пересчитывают оценки кандидатов, но не запускают поток повторно.
Затем поиск строит не только одну цепочку, но и компактное дерево продолжений. Целевая модель проверяет его за один проход: каждая вершина видит общий подтверждённый контекст и своих предков. Если одна ветка не подходит, проверка соседней ветки не пропадает зря.
Прирост появляется у дерева, а не у одиночной цепочки
Метод проверяли на трёх размерах Qwen3.5 вплоть до 27B, сравнивая черновые модули одинакового размера и обученные на одинаковых данных. Серверные замеры проводили на NVIDIA B300 при одном активном запросе, жадном выборе токенов и реализации в vLLM.
В этих условиях ChainFlow оказался быстрее EAGLE-3 на 39% и DFlash на 11%. Среднее ускорение относительно обычной последовательной генерации достигло 2,12 раза на старшей модели. Преимущество обеспечило дерево кандидатов: одиночная цепочка ChainFlow на английских задачах уступала конкурентам.
Проверка охватывала код, математику, ответы на вопросы, поиск по документам, суммаризацию, вызов инструментов и перевод. Черновики сначала обучали на английском, затем последовательно адаптировали к турецкому, немецкому и французскому. Английская версия на турецких запросах могла замедлять генерацию, но после адаптации ChainFlow опережал обе сравниваемые системы.
ChainFlow меняет план для малых пакетов запросов
Работа даёт основание добавить ChainFlow в испытания, если сервис генерирует длинные ответы на Qwen3.5 и обрабатывает запросы по одному или небольшими пакетами. Код и обученные черновые модели открыты, а сам поток не требует менять основную модель.
При росте параллельной нагрузки преимущество быстро исчезает. Дерево сохраняло выигрыш до четырёх одновременных запросов; дальше обычное последовательное декодирование становилось быстрее, потому что целевая модель проверяла слишком много ветвей. EAGLE-3 и DFlash в этих условиях теряли меньше, поскольку отправляли на проверку более короткие блоки.
Есть и функциональная граница: дерево ChainFlow проверяли только с жадным выбором токенов. Для сервиса со случайной выборкой, крупными пакетами или другой архитектурой LLM эта работа пока задаёт направление эксперимента, а не готовую замену текущего контура генерации.
Многоязычным продуктам придётся планировать повторное обучение черновика вместе с добавлением языка. Последовательная адаптация сильнее стирала ранее выученный турецкий, чем у базовых методов, но подмешивание одной пятой турецких примеров почти устраняло этот эффект. Значит, набор для повторения старых языков становится частью инфраструктуры, а не разовой подготовкой данных.
Источники
Иллюстрация: рисунок из статьи «ChainFlow: Few-Step Latent Flow Matching for Speculative Decoding», Selim Aktas, Yusuf Erdem Erdem, Ahmed Zeer и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


