
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Одну химическую LLM научили сохранять общие навыки и перенимать сильные стороны нескольких специализированных учителей. Команда The Chinese University of Hong Kong, Shenzhen и Shanghai Artificial Intelligence Laboratory в препринте, который не проходил рецензирование и все числа для которого получили сами авторы, показала: ChemOPD чаще улучшает итоговую модель, чем обучение только у специалистов. Для разработчиков это разделяет одну задачу на две: сначала нужно правильно собрать специалистов, затем аккуратно встроить их знания в общего ученика.
Как градиенты решают, какие задачи учить вместе
Обычный способ собрать специалистов — разделить задачи по понятным категориям: редактирование молекул, оценка свойств, оптимизация и реакции. ChemOPD не считает такие названия достаточным основанием для группировки. Семантически близкие задачи могут мешать друг другу при обучении, а задачи из разных категорий — давать совместимый сигнал.
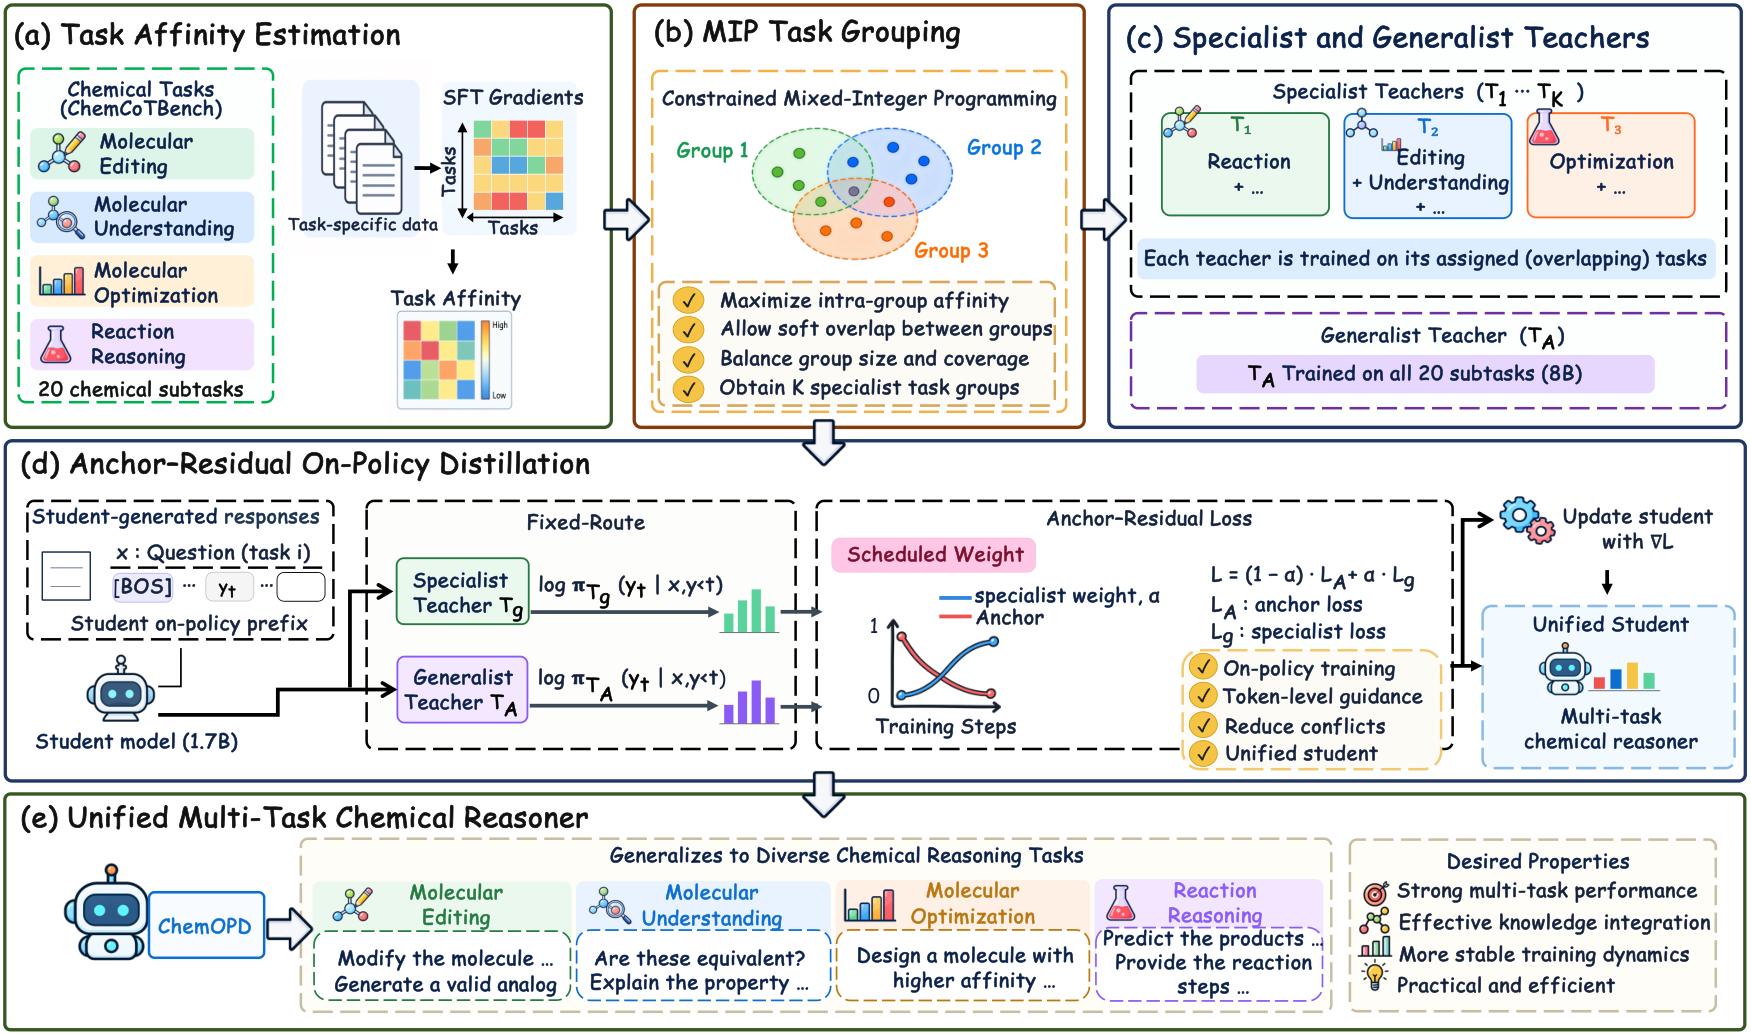
Метод сначала измеряет связь между парами задач. Для каждой берут две непересекающиеся части обучающих данных: по одной вычисляют градиент, то есть направление изменения параметров модели, а по другой проверяют, снизит ли такой шаг ошибку. Чем лучше совпадают направления градиентов двух задач, тем полезнее их учить вместе.
Затем задача смешанного целочисленного программирования собирает несколько групп с высокой внутренней совместимостью. Она учитывает ограничения на размер групп и разрешает частичное пересечение: одна задача может входить более чем в одного специалиста, если помогает развить его навыки. При этом во время переноса знаний каждый запрос заранее направляют только к одному специалисту.
На уровне учителей группировка по градиентам обошла общую модель по 20 из 31 показателя. В ретросинтезе оценка FTS, где большее значение означает лучший результат, выросла с 0,358 до 0,482. Выигрыш зависел от задачи: специализация не улучшала все способности одновременно, но в нескольких случаях работала лучше группировки по категориям ChemCoTBench.
Почему специалист не должен заменять общего учителя
Сильный учитель ещё не гарантирует сильного ученика. В опытах перенос только от специалистов иногда ухудшал модель относительно её состояния после начального обучения на всех задачах. Иными словами, специалист умел решать свою задачу лучше, но его сигнал не всегда удавалось встроить в модель с широким набором навыков.
ChemOPD оставляет общего учителя опорой. Ученик генерирует собственный ответ, после чего общий учитель и выбранный специалист оценивают одни и те же промежуточные состояния этого ответа. Модель учится на сигнале общего учителя, а разница между ним и специалистом служит поправкой.
Вес поправки растёт постепенно. В начале обучения студент следует более ровному сигналу общей модели, а затем всё сильнее учитывает специализацию. Это защищает уже собранные способности от резкой смены учителя и одновременно позволяет перенести различия, ради которых специалиста обучали.
При одинаковых специалистах, маршрутах запросов и объёме обучения такой подход перенёс большую долю доступного выигрыша, чем вариант только со специалистами. Разбор компонентов подтвердил обе части схемы: общий учитель помогал сохранить широкий профиль, а постепенное увеличение веса специалиста чаще работало лучше, чем его неизменный вес с первого шага. Отдельные задачи всё же предпочитали другой режим — например, показатель свойства QED оказался лучше при постоянном смешивании.
Меняет ли ChemOPD план разработки
Работу проверяли на двадцати подзадачах ChemCoTBench. Учителями служили три специалиста Qwen3-8B и общая модель того же размера, а знания переносили в Qwen3-1.7B. Все учителя начинали с одной контрольной точки и обучались по общей схеме; для ретросинтеза использовали отдельную выборку без пересечения строк продуктов, а не стандартное разделение по химической идентичности.
Эти условия ограничивают вывод химическими задачами, выбранными размерами моделей и одним семейством Qwen. Кроме того, найденная группировка — практический результат работы решателя при заданных ограничениях, а не доказанное единственное оптимальное разделение задач.
Для команды, которая собирает одну прикладную LLM из нескольких направлений, работа меняет прежде всего план обучения. Категории продукта не стоит автоматически превращать в границы специалистов: сначала полезно измерить, как задачи влияют на обучение друг друга. Сам перенос также стоит тестировать отдельно от качества учителей — таблица сильных специалистов не показывает, сможет ли единый ученик воспроизвести их преимущества.
Архитектуру сервиса при этом усложнять не обязательно. Несколько учителей, маршрутизация и смешивание сигналов нужны только во время обучения; при работе с запросами используется один ученик. Цена такого решения — более сложный обучающий контур с отдельной общей моделью, специалистами и предварительно заданным маршрутом для каждой задачи.
Источники
Иллюстрация: рисунок из статьи «ChemOPD: Multi-Teacher On-Policy Distillation for Multi-Task Chemical Reasoning», Yaoyao Xu, Xinjian Zhao, Xiaozhuang Song и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


