
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Обновления LLM при обучении с подкреплением научились защищать от редких расхождений между движками генерации и расчёта градиентов. В препринте, который пока не рецензировали, авторы получили на Qwen1.5-MoE-A2.7B среднюю точность 34,78% против 30,99% без коррекции. Метод пригодится в конвейерах, где ответы генерирует один движок, а модель обновляет другой.
Оба движка загружают одинаковые параметры, но различия в вычислительных ядрах, порядке операций и числовой точности меняют вероятности отдельных токенов. В моделях со смесью экспертов расхождение усиливает маршрутизация: небольшая численная ошибка может отправить токен к другому набору экспертов.
Обычная выборка по значимости исправляет сдвиг, умножая градиент токена на отношение вероятностей двух движков. Редкие большие отношения делают оценку градиента нестабильной: взвешенный второй момент, который определяет её разброс, достиг 22,9 — более чем в 20 раз выше оценки без коррекции. Фиксированное ограничение уменьшает разброс, но чаще обрезает токены, в которых модель уверена слабо.
Предложенный метод CIS отделяет уверенность модели от смещения логарифмических шансов между движками. Он ограничивает только большие положительные смещения одним порогом; после обратного преобразования допустимый вес автоматически становится меньше для токенов с высокой уверенностью. Так CIS ограничивает второй момент постоянной ценой управляемого смещения и не отбрасывает вклад токена полностью.
Метод проверили на трёх моделях со смесью экспертов: Qwen1.5-MoE-A2.7B-Chat, DeepSeek-V2-Lite и Qwen3-30B-A3B. Их обучали на GSM8K и оценивали по пяти математическим наборам; CIS показал лучший средний результат среди рассмотренных способов на каждой модели. Для внедрения нужны исходные логарифмы вероятностей со стороны генерации и дополнительный поэлементный проход без новых прямых или обратных вычислений модели.
Источники
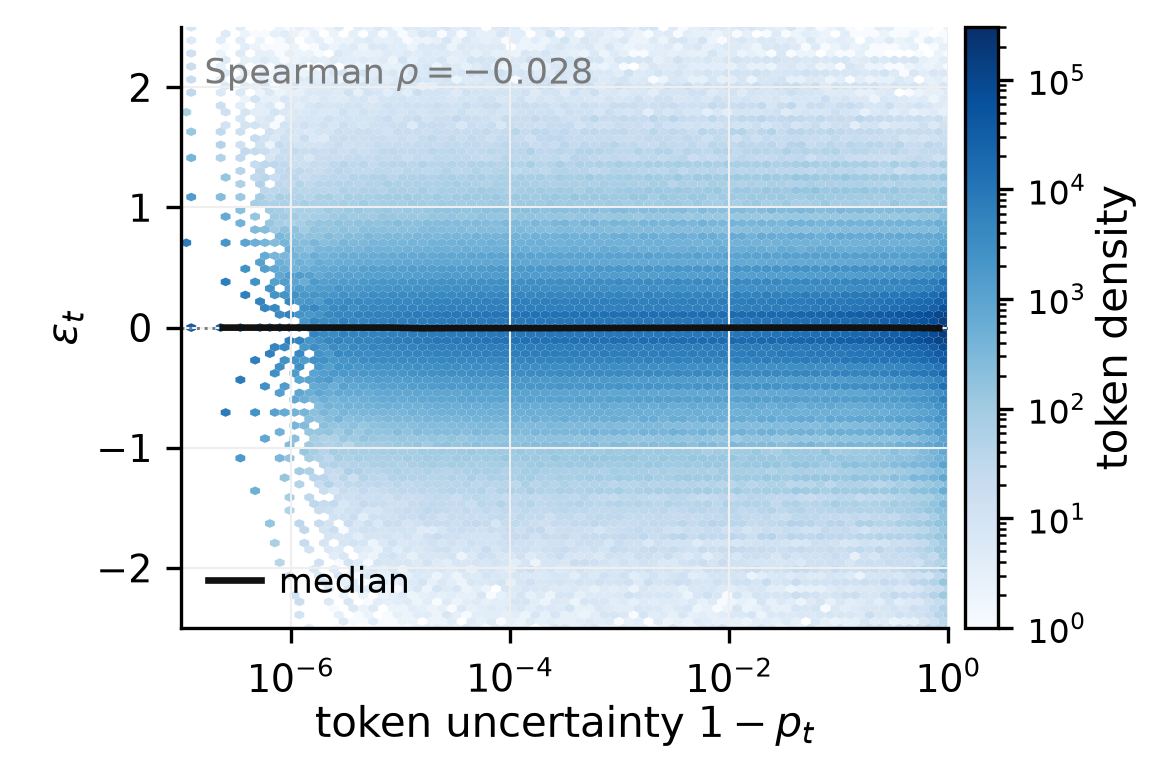
Иллюстрация: рисунок из статьи «Rethinking Training-Inference Mismatch in LLM Reinforcement Learning: Where It Arises and How to Correct It», Tianrun Yu, Kaixiang Zhao, Shangzhe Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


