
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM-агента научили находить собственные слабые места и подбирать под них новые тренировочные задачи без более сильной модели-учителя. В нерецензированном препринте, где все числа получили сами авторы, ClawLoop дал Qwen3.6-27B более высокие результаты, чем исходная модель и однопроходный конвейер ClawGym. Такой подход позволяет строить обучение вокруг ошибок самого агента, а не заранее составленного набора примеров.
Как агент собирает задачи с проверяемым ответом
ClawLoop рассчитан на агентов, которые работают в изолированной среде с файловой системой, командной оболочкой, пакетами и сетевым доступом. В отличие от агента с фиксированным набором инструментов, такой агент может читать и менять файлы, запускать программы и собирать многошаговые процессы.
Главная сложность здесь не в том, чтобы придумать текст задания, а в том, чтобы создать начальное состояние среды и однозначно проверить результат. ClawLoop решает эту задачу двумя способами.
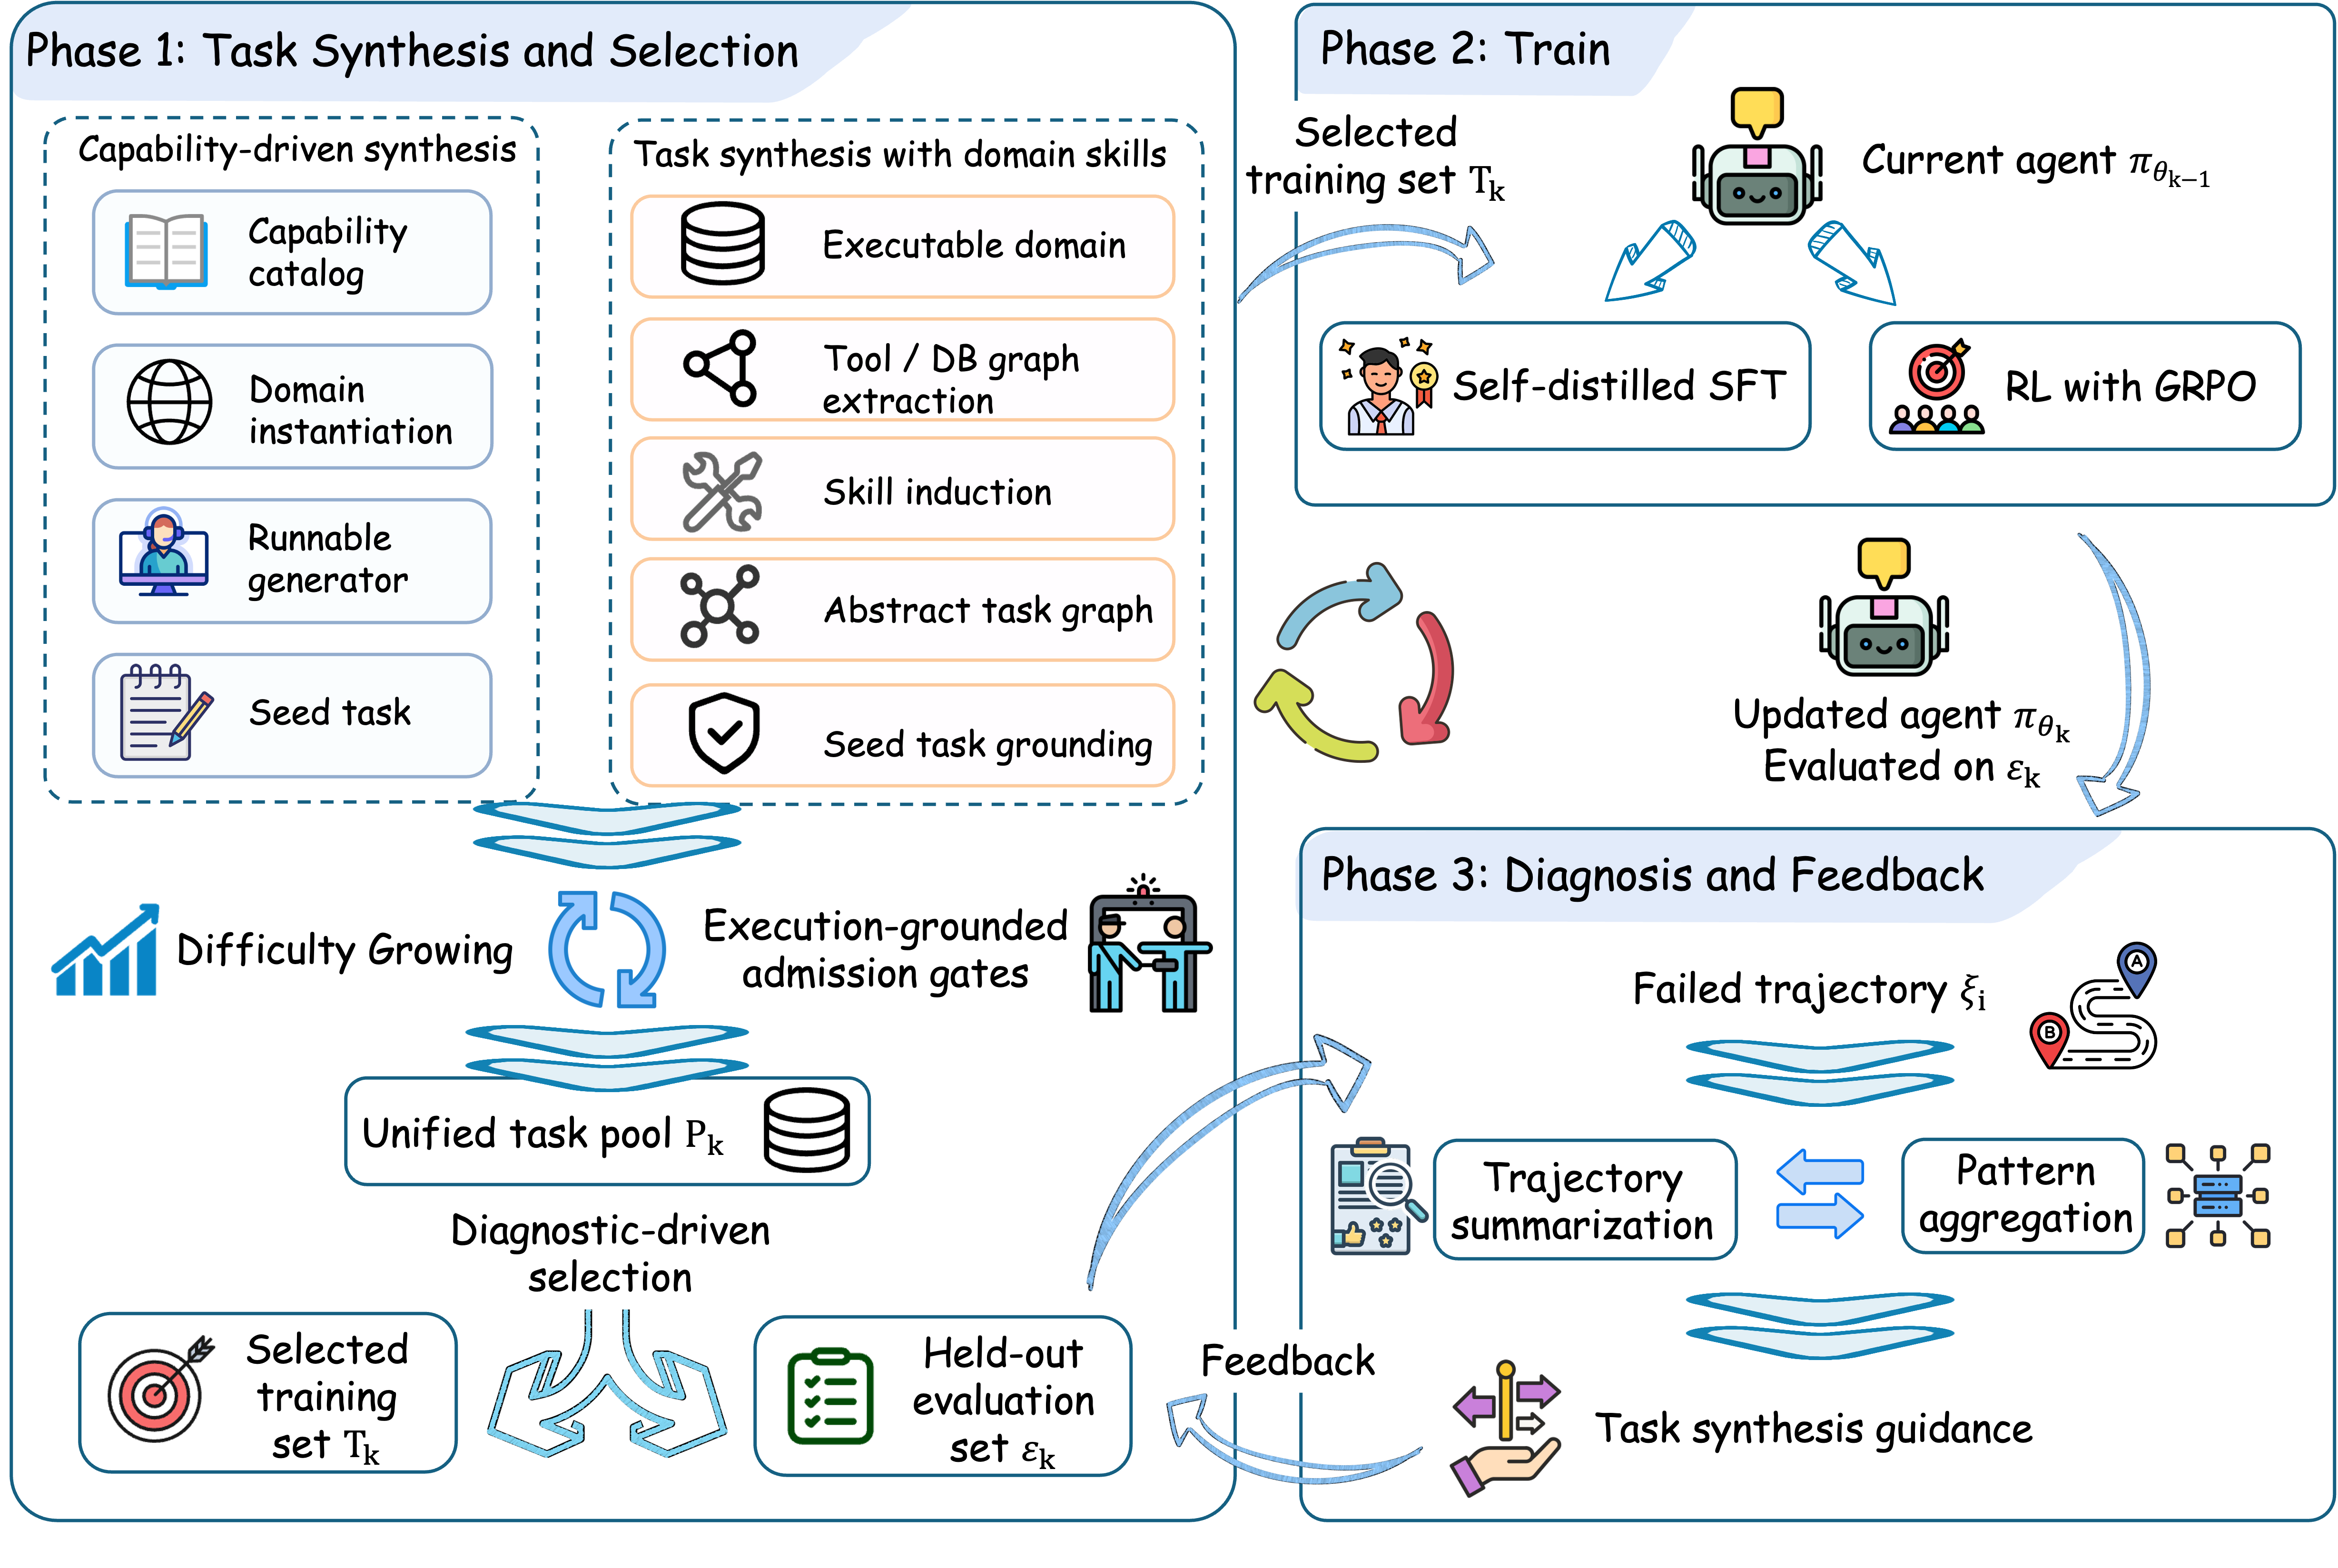
Первый способ отталкивается от способности: например, сверить несколько источников, объединить документы или выполнить расчёт по правилам предметной области. Модель пишет исполняемый генератор, который создаёт исходные файлы, вычисляет эталонный ответ и задаёт формат результата. Ответ поэтому возникает из выполнения кода над созданными данными, а не из предположения модели.
Второй способ начинается с предметной области и доступных в ней инструментов. ClawLoop анализирует команды, параметры и таблицы, объединяет связанные операции в навыки, а затем строит граф задачи. Сначала граф задаёт зависимости, развилки и промежуточные цели без привязки к конкретным командам. После этого система наполняет его данными и превращает конечное состояние в набор исполняемых проверок.
Кандидаты проходят статическую и исполнительную проверку. Система проверяет структуру задания и целостность рабочей среды, запускает эталонное решение и убеждается, что проверяющий код принимает правильный результат. Затем задачу пробует сам агент: слишком простые и практически нерешаемые примеры не попадают в обучение.
Как ошибки превращаются в следующий учебный цикл
После синтеза ClawLoop делит задачи на обучающую и отложенную части. На успешных траекториях агент дообучается с учителем; задачи подходящей сложности можно использовать для обучения с подкреплением. В основном эксперименте цикл повторяли три раза, а на каждом шаге создавали 1024 новых задания и выполняли по восемь попыток решения.
Отложенные задачи нужны не только для итоговой оценки. Для каждой неудачной траектории агент находит действие, после которого решение пошло неверно, определяет причину и формулирует недостающий навык. Затем ClawLoop объединяет похожие случаи: например, агент меняет основной файл, но забывает обновить импорты в зависимых модулях.
Следующий цикл получает этот отчёт как программу обучения. Если агент уже справляется с категорией, система усложняет соответствующие задания. Лучше всего сработало постепенное повышение сложности: максимум на один уровень за цикл. Более резкое усложнение увеличивало длину траекторий, но не давало столь же полезного обучающего сигнала.
Qwen3.6-27B улучшил результаты на SkillsBench, Claw-Eval-Live и ClawGym-Bench. Данные также перенесли на Qwen3.5-4B и Qwen3.5-9B: обе модели прибавили на всех трёх наборах тестов по сравнению с обучением на данных ClawGym. Это отделяет качество заданий от способности модели, которая их создавала.
Что меняется в планах команд
ClawLoop меняет планы прежде всего там, где уже можно автоматически подготовить рабочую среду и проверить конечный результат. Вместо постоянной закупки траекторий у более сильной модели команда может замкнуть собственный цикл: собирать неудачи, превращать повторяющиеся причины в задания и обновлять модель на новых примерах.
Для этого проверяющий код становится частью продукта обучения, а не вспомогательным скриптом. Если результат нельзя выразить через состояние файлов, базы данных или другой исполняемый критерий, ClawLoop не снимает проблему субъективной оценки. Система особенно подходит для задач, где существует несколько допустимых путей, но итог можно проверить однозначно.
Работу проверяли на OpenClaw с одной основной моделью и тремя наборами тестов: один оценивает применение профессиональных навыков, два других — работу с файлами и исполняемыми средами. Обучение и оценка использовали один тип рабочей оболочки, хотя SkillsBench не привязан к OpenClaw. Поэтому результаты поддерживают идею переноса навыков, но пока относятся к агентам с похожей моделью исполнения и строгими проверками результата.
Практический вывод не в том, что агент способен бесконечно улучшать себя. После нескольких циклов результаты на двух наборах вышли на плато. Полезная часть работы — инженерная схема, которая связывает диагностику, синтез задач, проверку и обучение без внешнего учителя.
Источники
Иллюстрация: рисунок из статьи «ClawLoop: Self-Improving Agents via Harness-Native Training Loop», Hansi Yang, Linji Hao, Hongyan Hao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


