
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM-агента научили решать, стоит ли задавать пользователю уточняющий вопрос, по тому, улучшит ли ответ итог задачи. Команда University of Connecticut, University of Notre Dame и University of Massachusetts Amherst получила на UserGym Travel преимущество 13,2 процентного пункта над сильнейшим базовым методом, однако препринт не рецензирован, а числа получили сами авторы. Подход меняет обучение интерактивных агентов: ценность вопроса приходится пересчитывать вместе с политикой, которая решает задачу.
Полезность вопроса измеряют через два продолжения задачи
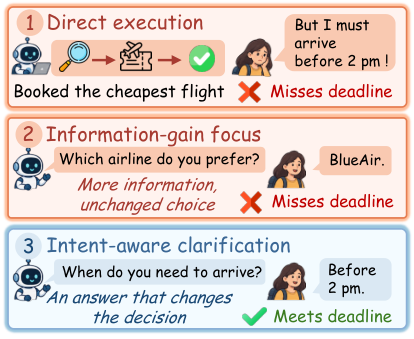
Сам по себе информативный ответ не обязательно помогает агенту. Если два подходящих рейса обслуживает одна авиакомпания, вопрос о предпочтительной авиакомпании уточнит интересы пользователя, но не повлияет на выбор. Вопрос о крайнем времени прибытия может сразу исключить один вариант.
CLEAT оценивает остаточную ценность вопроса (residual query value). Для этого система запускает два продолжения из одной истории диалога и с одной скрытой целью пользователя. В первом агент задаёт выбранный вопрос, получает ответ и решает задачу; во втором продолжает самостоятельно.
Разница между результатами показывает, что именно добавил вопрос. Оценка учитывает заданную бенчмарком стоимость лишнего взаимодействия. Поэтому бесполезное уточнение может получить нулевую или отрицательную ценность, даже если оно раскрывает новую информацию.
Ветка без принудительного вопроса сохраняет обычное поведение агента: он всё ещё может спросить что-либо сам. CLEAT тем самым сравнивает выбранное уточнение не с молчанием, а с текущей способностью модели вести диалог. Это важная деталь: метод измеряет дополнительную пользу вопроса относительно уже обученной политики.
Возможные темы вопросов заранее задаёт конструктор целей, а отдельный компонент превращает тему в готовую реплику. Небольшой контроллер получает историю и тему, после чего предсказывает ожидаемую прибавку к результату. Он не знает скрытую цель пользователя и учится только на итогах парных прогонов.
Контроллер и политика учатся на одних исходах
Во время сбора обучающих примеров контроллер предлагает тему с высокой ожидаемой ценностью. Ещё одну тему система выбирает для охвата вариантов, которые контроллер мог недооценить. Обе сравниваются с общим продолжением без навязанного вопроса.
Результаты выполняют две функции. Разница между ветками становится меткой для контроллера, а исход каждого прогона обновляет политику агента. Поскольку система чаще проверяет перспективные темы, авторы корректируют веса примеров так, чтобы такое смещение не меняло ожидаемое направление обучения.
После обновления политики прежняя оценка вопроса может устареть. Агент способен научиться лучше использовать ответ либо, наоборот, решать ту же задачу без помощи. CLEAT поэтому повторяет сбор парных исходов и переобучает контроллер вместе с политикой; после последнего обновления контроллер дополнительно освежают на результатах финальной модели.
Метод проверяли с Qwen3-4B на четырёх наборах задач: UserGym, τ2-Bench, IN3 и AskBench. Они охватывают персональный выбор, работу с инструментами, пропущенные требования и ложные предпосылки. CLEAT показал лучший средний результат во всех десяти режимах, а точность определения недостающих условий в IN3 выросла на 6,5 процентного пункта относительно сильнейшего сравниваемого метода.
Сравнения включали подсказки без дополнительного обучения, пороговые правила, награды за прирост информации, обучение с учителем и GRPO. Отдельные проверки показали, что обновление контроллера вместе с политикой работало лучше фиксированного контроллера, а обученная политика сохраняла часть выигрыша даже без его вмешательства при использовании.
Для внедрения нужен симулятор пользователя, а не только журнал диалогов
CLEAT меняет планы команд, которые строят агентов для ограниченных предметных областей. Если возможные недостающие условия можно перечислить, а поведение пользователя — воспроизвести в испытательной среде, метод даёт понятную схему: сравнивать вопрос с самостоятельным действием и направлять обучающий бюджет туда, где различие влияет на задачу.
Одного набора состоявшихся диалогов для такого обучения недостаточно. Метод требует многократно продолжать одну историю с одной и той же скрытой целью пользователя, меняя только решение спросить или действовать. В рабочем сервисе получить такие парные исходы трудно, поэтому практическая реализация опирается на симулятор либо специально построенную испытательную среду.
При использовании парные прогоны уже не нужны. Контроллер оценивает доступные темы и задаёт лучший вопрос, только если ожидаемая прибавка положительна. Если он выбирает продолжение без вопроса, дальше действует основная политика, которая по-прежнему может уточнять самостоятельно.
Фиксированные конструктор тем и генератор формулировок делают CLEAT ближе к агентам с известным набором полей и ограничений, чем к полностью открытым помощникам. Проверка проходила с симулированными пользователями, поэтому работа пока обосновывает архитектуру обучения, но не её эффективность в диалогах с реальными пользователями и меняющимися целями.
Источники
Иллюстрация: рисунок из статьи «CLEAT: Learning Value-Guided Clarification for Interactive Agents», Jiatan Huang, Zheyuan Zhang, Ziming Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


