
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Дообучение Text-to-SQL-моделей научились направлять на недостающие SQL-структуры и ошибки, которые модель показывает уже во время обучения. На отложенной части BIRD система достигла 64,9% правильных результатов исполнения с Qwen2.5-Coder-7B-Instruct, хотя работа не рецензирована и все числа получили сами авторы. Для команд это вариант не наращивать корпус вслепую, а дополнять конкретные пробелы.
Каркасы запросов показывают, каких структур не хватает
Команда Qifeng Cai из Peking University и Beihang University начинает с каркасов SQL-запросов. Из запроса удаляют названия таблиц, столбцов и псевдонимы, а значения заменяют обозначениями типов. Операторы, соединения таблиц, вложенность, агрегаты и порядок секций сохраняют.
Так запросы к разным базам можно считать структурно одинаковыми. Например, выборка столбца с фильтром по числу и сортировкой превращается в один каркас независимо от предметной области базы. Этот уровень абстракции позволяет сравнивать не формулировки вопросов, а сочетания SQL-конструкций.
COAL-SQL фиксирует каркасы исходного набора как уже покрытые точки, а затем жадно выбирает из большого внешнего корпуса наиболее удалённые варианты. Алгоритм одновременно ищет структуры, которых нет в исходных данных, и не даёт новым примерам собраться вокруг одного редкого шаблона.
В эксперименте исходный набор включал 3000 примеров BIRD, а дополнение — 3500 примеров. По доле восстановленных пар соседних SQL-элементов такой отбор обошёл синтез по схеме OmniSQL на 16,2 процентного пункта при одинаковом объёме дополнения.
Выбранный каркас ещё нужно перенести на учебную базу: подобрать таблицы и столбцы, собрать исполняемый запрос и сформулировать естественный вопрос. Пример принимают, только если запрос разбирается, выполняется, возвращает непустой результат и сохраняет выбранную структуру. Смысловую согласованность вопроса и SQL дополнительно проверяет модель-оценщик.
Провал становится материалом для следующего шага
После расширения корпуса COAL-SQL запускает групповое обучение с подкреплением GRPO. Для каждого вопроса модель создаёт восемь вариантов ответа, а награда зависит прежде всего от того, совпал ли результат исполнения с эталонным. Если в группе есть правильные и неправильные запросы, GRPO получает контрастный сигнал и усиливает удачное поведение.
Проблема возникает, когда неверны все варианты. В начальной модели такие случаи составляли 15,1% учебных примеров и концентрировались вокруг вложенных запросов, соединений нескольких таблиц и сочетаний агрегатов. В группе нет правильного SQL, поэтому относительное сравнение не показывает, как решить задачу.
COAL-SQL обрабатывает такие провалы на двух уровнях. После шага обучения сильная LLM получает условие и эталонный SQL, строит подробную трассу решения, а система оставляет её только тогда, когда итоговый запрос даёт тот же результат, что и эталон. Промежуточные рассуждения отдельно не проверяются.
Накопленные за эпоху ошибки используют шире. Система ищет другие примеры с родственными каркасами, определяет основную ошибку — например, неверное соединение, агрегат или выбор столбца — и добавляет целевую практику. Прямое исправление закрывает конкретный провал, а связанные задачи должны закрепить саму SQL-конструкцию.
Планы меняются, если уже есть эталонные запросы и контур исполнения
COAL-SQL полезен не как готовая универсальная модель, а как схема дообучения поверх существующего набора Text-to-SQL. Полный запуск использовал 12 644 разных примера: работа показывает, как распределить ограниченный бюджет данных между структурными пробелами, прямыми исправлениями и похожими упражнениями.
Для повторения нужны вопросы с эталонным SQL, учебные базы, возможность многократно исполнять сгенерированные запросы и сильная LLM для построения исправлений. Без эталонных запросов система не сможет проверить трассы, а без исполнения — отделить синтаксически правдоподобный SQL от запроса с правильным результатом.
Основной результат получен на Qwen2.5-Coder-7B-Instruct и BIRD dev. Авторы также провели перенос между бенчмарками и разбор компонентов, но центральный вывод относится к дообучению открытой модели на базах и структурах, близких к целевой задаче, а не к замене общего Text-to-SQL-контура.
Полный цикл занял 23,47 часа на восьми GPU H20. Сам поиск родственных каркасов почти не влияет на это время: основная стоимость приходится на генерацию, проверку примеров, многократные ответы модели и GRPO. Поэтому подход меняет план данных сильнее, чем план инфраструктуры: сначала стоит измерить покрытие SQL-структур, а затем направить уже предусмотренные вычисления на обнаруженные пробелы.
Источники
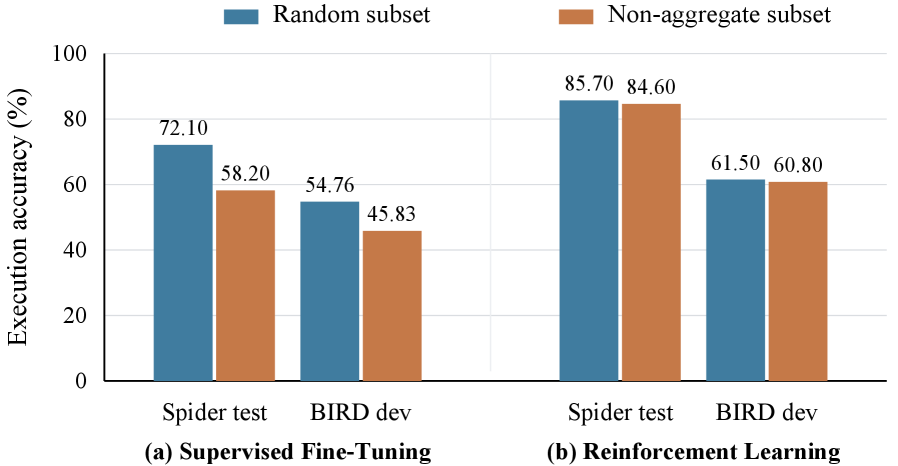
Иллюстрация: рисунок из статьи «COAL-SQL: Coverage-Guided Augmentation and Failure-Driven Learning for Text-to-SQL Post-Training», Qifeng Cai, Xuanguang Pan, Hao Liang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


