
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
В NetHack агенты стали лучше проходить длинные игровые эпизоды, когда повторяющиеся цепочки действий за них выполняли готовые процедуры, а отдельные команды оставались запасным выходом. С такими процедурами среднее продвижение почти утроилось, хотя препринт не рецензирован и числа в нём получили сами авторы. Работа предлагает практическую схему для агентов, которые подолгу управляют программами: типовые действия стоит закреплять в коде, но полностью закрывать низкоуровневый API рано.
Как код заменял цепочки решений
В обычной схеме управляющая LLM на каждом шаге выбирает отдельную команду: направление движения, поиск, удар или действие с предметом. Чем длиннее задача, тем чаще приходится вызывать модель, передавать ей историю и надеяться, что она не ошибётся в одном из промежуточных решений.
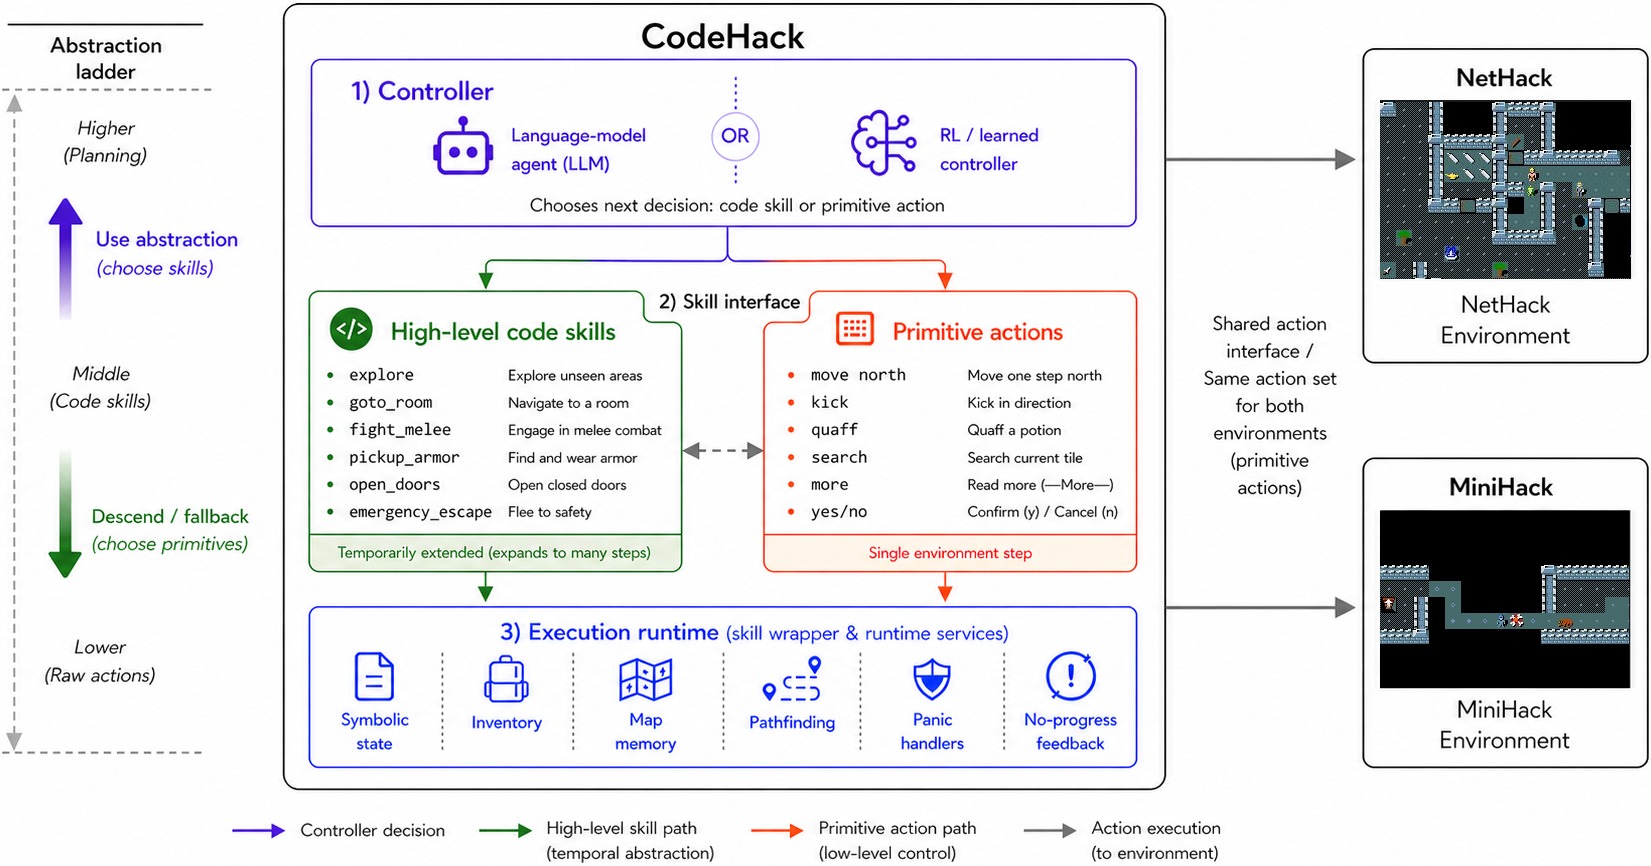
В CodeHack часть этой работы выполняют навыки — процедуры на Python с понятными модели названиями и описаниями. Например, explore исследует уровень, fight_melee ведёт ближний бой, а open_doors открывает двери. Процедура сама выпускает последовательность игровых команд и возвращает управление модели после завершения или неожиданного события.
Среда хранит карту, состояние инвентаря и другие структурированные сведения. Поэтому код принимает локальные решения без нового обращения к LLM, а модель выбирает цель крупнее: исследовать область, подобрать снаряжение или спуститься на следующий уровень.
Авторы собрали библиотеку из 78 навыков и сравнили три интерфейса. В первом агенту доступны только отдельные команды, во втором — только навыки, в третьем — оба варианта. Реализации навыков во время экспериментов не менялись.
Управление без дополнительного обучения проверяли на 14 моделях семейств GPT, Llama, Gemma и Qwen. Отдельно Llama-3.1-8B-Instruct и Qwen-3.5-4B обучали с подкреплением. Контролируемые задачи MiniHack изолировали навигацию, бой и использование предметов, а NetHack проверял длинные последовательности в процедурно создаваемом подземелье.
Готовые навыки экономили вызовы модели и ускоряли обучение
В MiniHack переход от отдельных команд к навыкам повысил среднюю долю успешно выполненных задач на 55 процентных пунктов. Выигрыш сохранился и в NetHack: агенты набирали больше очков, проходили глубже и реже тратили решения модели на локальные перемещения.
Расчётная стоимость одного игрового эпизода по тарифам OpenRouter снизилась с 4,35 до 0,59 доллара. Смешанный интерфейс оказался дороже режима только с навыками, но всё равно требовал меньше расходов, чем управление отдельными командами. Причина не в более дешёвой модели, а в том, что один её ответ запускает сразу несколько действий.
Навыки помогли и при обучении с подкреплением. При одинаковом бюджете обучения прирост достигнутой глубины оказался в 7,2 раза больше, чем у агента с отдельными командами. Смешанный интерфейс увеличил прирост в 8,6 раза: обучение смогло использовать готовые процедуры, не теряя доступ к точным действиям.
Это сравнение не доказывает, что тот же выигрыш сохранится в браузере, среде разработки или корпоративной системе. Все длинные запуски проходили в NetHack, а библиотеку заранее написали для этой среды. Работа измеряет пользу уже доступных процедур, а не способность агента самостоятельно находить и программировать их.
Планы стоит менять на уровне интерфейса агента
Для команды, которая строит агента поверх низкоуровневого API, результат поддерживает двухуровневую архитектуру. Повторяемые последовательности лучше оформлять как проверяемые функции, а LLM оставлять выбор функции, параметров и момента переключения. Это сокращает число решений, которые модель должна принять правильно, и уменьшает объём истории, повторно передаваемой при каждом вызове.
Полностью заменять отдельные действия навыками не стоит. Авторы удаляли из библиотеки разные группы процедур: смешанное управление обычно теряло меньше качества, потому что агент мог выполнить недостающий шаг отдельными командами, а затем вернуться к навыкам. Такой запасной путь полезен и при редких состояниях, которые разработчики не предусмотрели.
У смешанной схемы есть цена: модель получает более широкий список действий и иногда выбирает менее экономный путь. Режим только с навыками оказался дешевле, поэтому для узкого и хорошо описанного процесса он может быть достаточен. Смешанный режим оправдан там, где среда меняется, встречаются исключения или ошибка процедуры блокирует весь сценарий.
Работа не сравнивает расходы на разработку библиотеки с экономией на вызовах модели. Поэтому решение зависит от повторяемости: чем чаще агент исполняет одну и ту же длинную цепочку, тем быстрее окупается перенос локальной логики в код. Для редких сценариев поддержка отдельного навыка может стоить дороже сэкономленных обращений к LLM.
Практический следующий шаг — не менять модель, а разобрать журналы агента. Повторяющиеся цепочки низкоуровневых вызовов можно превратить в функции с явными условиями запуска, остановки и аварийного возврата. После этого стоит отдельно измерить долю завершённых задач, стоимость одного запуска и частоту обращений к запасным командам.
Источники
Иллюстрация: рисунок из статьи «Up and Down the Abstraction Ladder: Code-Based Skills for Language Agents», Bart{\l}omiej Cupia{\l}, Jens Tuyls, Maciej Wo{\l}czyk и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


