
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM научили один раз писать исполняемый контроллер, который затем выбирает действия без обращения к модели и без планирования. В препринте Harvard University, MIT и IHMC, который не прошёл рецензирование и содержит замеры самих авторов, такой код работал быстрее нейросетевого контроллера PPO. Это позволяет перенести затраты на LLM из рабочего контура в этап обучения.
Как разделили логику контроллера и числа
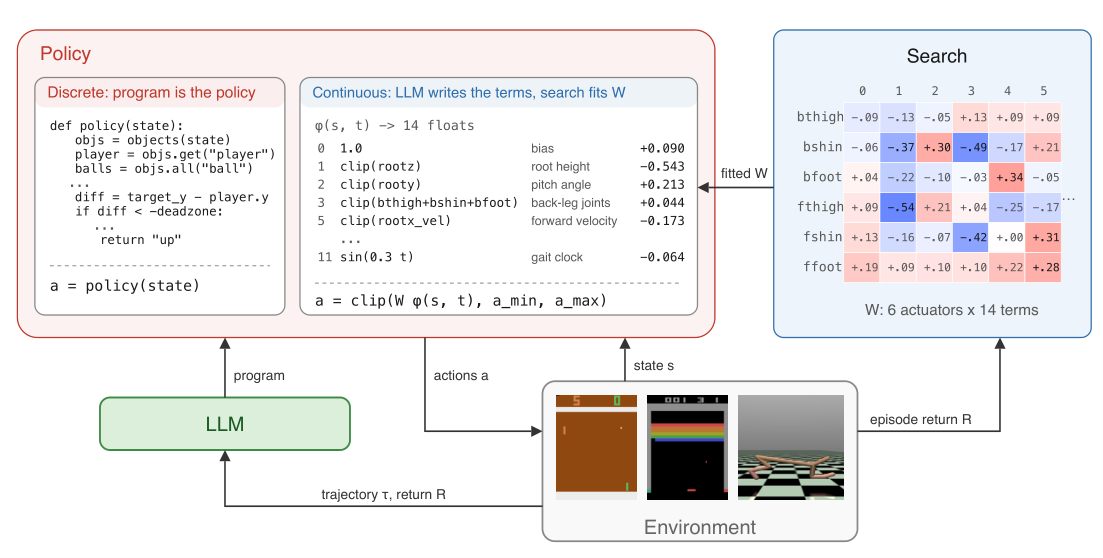
Code to Control создаёт не модель мира, а функцию на Python, которая получает текущее состояние среды и сразу возвращает действие. После обучения для очередного решения не нужны ни LLM, ни прогноз следующих состояний, ни поиск по возможным сценариям.
В играх с дискретными действиями LLM пишет контроллер целиком. Среда выполняет программу, возвращает траекторию и награду, после чего модель меняет код. Следующая версия может, например, учитывать скорость объекта, предсказывать его будущую позицию или добавлять допустимое отклонение от цели, чтобы персонаж не колебался рядом с ней.
В непрерывном управлении работу делят иначе. LLM пишет набор признаков: положение корпуса, скорости суставов, взаимное положение конечностей и периодические сигналы, которые задают ритм движения. Отдельный безградиентный поиск случайно изменяет числовые коэффициенты и оставляет варианты, которые приносят больше награды.
Итоговый контроллер умножает вычисленные признаки на матрицу коэффициентов и ограничивает команды допустимым диапазоном. Структура программы отвечает за то, какие свойства состояния учитывать, а числовая настройка определяет силу их влияния на приводы.
LLM не получает уравнения среды или демонстрацию правильного поведения. Для дискретных задач она исправляет код по результатам эпизода, а для непрерывных создаёт несколько независимых наборов признаков. Лучший найденный контроллер сохраняется отдельно, поскольку очередное изменение программы нередко ухудшает уже работавшую логику.
Прямой код оказался быстрее планирования
Метод проверяли на Atari, Flappy Bird и задачах непрерывного управления MuJoCo. В играх контроллер получал не исходные пиксели, а готовый список объектов с координатами, размерами и скоростями. В MuJoCo входом служили положения и скорости суставов, поэтому работа оценивает управление по структурированному состоянию, а не распознавание сцены.
На всех проверенных играх Atari Code to Control обошёл ReAct, который обращался к LLM при каждом действии, и WorldCoder, который строил программную модель мира и планировал через неё. На большинстве задач MuJoCo прямой контроллер также превзошёл методы с программной моделью мира.
Один из контроллеров Pong сначала направлял ракетку к текущей позиции мяча и получил −8. После изменения он начал экстраполировать движение мяча по скорости, и результат вырос до +18. Небольшая правка превратила запаздывающую реакцию в упреждающее управление без отдельного планировщика.
Выбор действия занимал 11,4 микросекунды: почти в 7 раз быстрее PPO и примерно в 4000 раз быстрее планирования WorldCoder по принятому в работе протоколу. Разрыв возникает не из-за ускорения самой LLM, а потому что после синтеза её вообще нет в контуре исполнения.
Flappy Bird показал ещё одно следствие разделения структуры и параметров. При изменении гравитации, сопротивления, силы взмаха и геометрии препятствий часть контроллеров продолжила работать без изменений. В остальных случаях авторы оставляли программу прежней и заново подбирали только числовые константы.
Когда подход меняет архитектуру продукта
Работа даёт практический шаблон для систем, где решение зависит главным образом от текущего состояния, а задержка на каждом шаге критична. LLM можно использовать во время разработки, чтобы получить читаемую структуру контроллера, а в рабочей среде выполнять обычный код с предсказуемым временем ответа.
Для непрерывного управления полезно разделить два цикла. Структуру признаков меняют редко и с участием LLM, а коэффициенты подстраивают чаще по награде из симулятора или среды. Если динамика меняется, сначала можно заново подобрать числа и только затем платить за повторный синтез программы.
Такой вариант стоит добавить в план прототипа, если команда собиралась вызывать LLM для каждого действия или запускать планировщик поверх модели мира. Он также упрощает проверку поведения: формулы и условия контроллера можно прочитать, воспроизвести и сравнить между версиями.
Границы применимости проходят там, где текущего наблюдения недостаточно. Эксперименты охватывают симуляторы со структурированным состоянием и преимущественно реактивные задачи. Если агенту нужно восстанавливать скрытую историю, работать напрямую с изображением или просчитывать долгие последствия решений, модель мира и планирование могут остаться более подходящей архитектурой.
Результаты MuJoCo также требуют смотреть не только на итоговую награду. В некоторых средах агент получает её за то, что остаётся в рабочем состоянии, даже если почти не движется вперёд. Поэтому для продукта целевую функцию придётся сверять с наблюдаемым поведением, а не принимать высокий балл за доказательство полезного управления.
Источники
Иллюстрация: рисунок из статьи «Code to Control: Synthesizing Parameterized Reactive Controllers», Zergham Ahmed, Joshua B. Tenenbaum, Chris Bates и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


