
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
CodeQuant2 ускорил генерацию рассуждающих моделей после четырёхбитной квантизации активаций и весов и снизил потерю качества на задачах по математике и коду. В нерецензированном препринте Xingyu Liu и коллег, где числа получили сами авторы, среднее ускорение составило 2,42 раза относительно 16-битного BF16. Метод показывает, как сократить требования к GPU без переобучения модели с нуля.
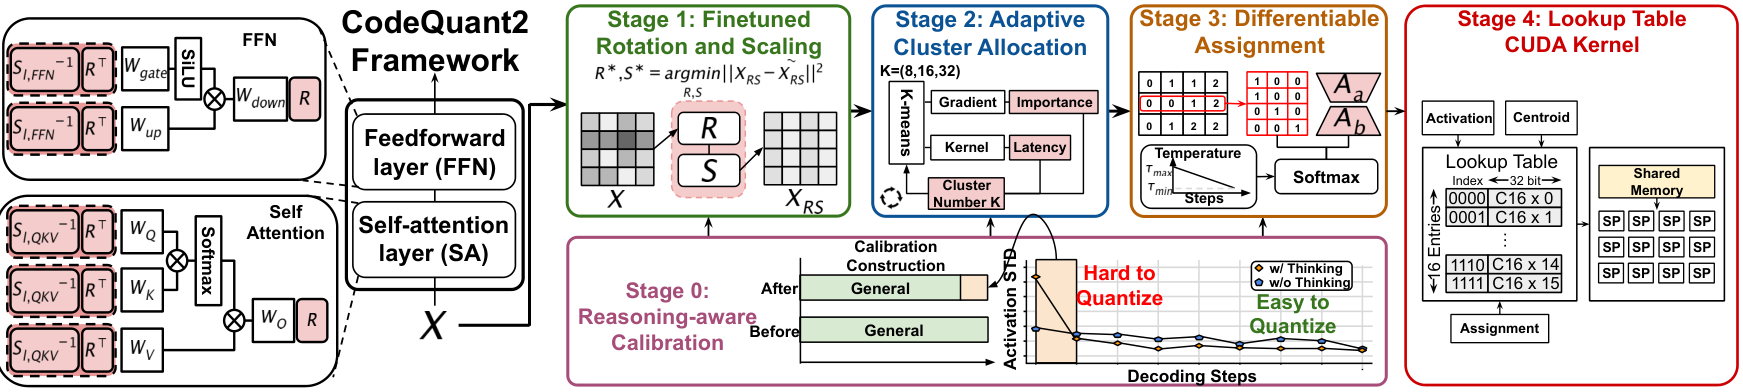
В начале рассуждения активации меняются сильнее: на первых шагах их разброс оказался примерно на 20% выше, чем при генерации без режима рассуждения. Поэтому CodeQuant2 добавляет в калибровочный набор первые токены ответов полной модели. Если калибровать только на обычных текстах или поздних фрагментах цепочки, преобразования хуже учитывают экстремальные значения, а ранняя ошибка распространяется на продолжение ответа.
Сначала метод обучает поворот и масштабирование, которые распределяют выбросы активаций между каналами. Затем он группирует веса и хранит для каждой группы代表ительное значение. Число таких значений выбирается отдельно для каждой матрицы: чувствительные получают больше, устойчивые — меньше, причём алгоритм учитывает не только ошибку, но и замеренную задержку на GPU. Отдельное ядро CUDA выполняет умножения через таблицу соответствий (LUT), не восстанавливая исходные веса.
На Qwen3-4B-Thinking полный набор компонентов поднял средний результат по шести задачам с 66,4% до 77,0%. На LiveCodeBench модель обошла предыдущий CodeQuant на 15 процентных пунктов. Разбор компонентов показывает, что прирост дают и подавление выбросов, и распределение числа групп по матрицам, и калибровка на начале рассуждения.
Проверки охватили Qwen3-4B-Thinking, Qwen3-8B и Phi4-Reasoning, задачи MATH-500, GSM8K, AIME25, AIME26, HumanEval и LiveCodeBench, а также GPU A6000, L40s и A100. Качество сравнивали с CodeQuant и другими способами квантизации, скорость — с BF16. Работа оценивает ответы по бенчмаркам, но не разбирает, стали ли цепочки рассуждений после квантизации более повторными или избыточными.
Источники
Иллюстрация: рисунок из статьи «CodeQuant2: Enhanced Outlier Mitigation and Adaptive Clustering for Low-Precision LRMs», Xingyu Liu, Xiangyang Yin, Tianhua Xia и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


