
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM научили откладывать сжатие фрагмента, если его значение станет понятно только из следующих документов. Работа KAIST, University of Macau и MIT описывает CoEM; препринт не прошёл рецензирование, а все числа получили сами авторы. На длинных входах метод обошёл другие схемы памяти с тем же бюджетом, поэтому для многошагового анализа важен уже не только выбор фактов, но и момент их сжатия.
Раннее сжатие стирает связи между документами
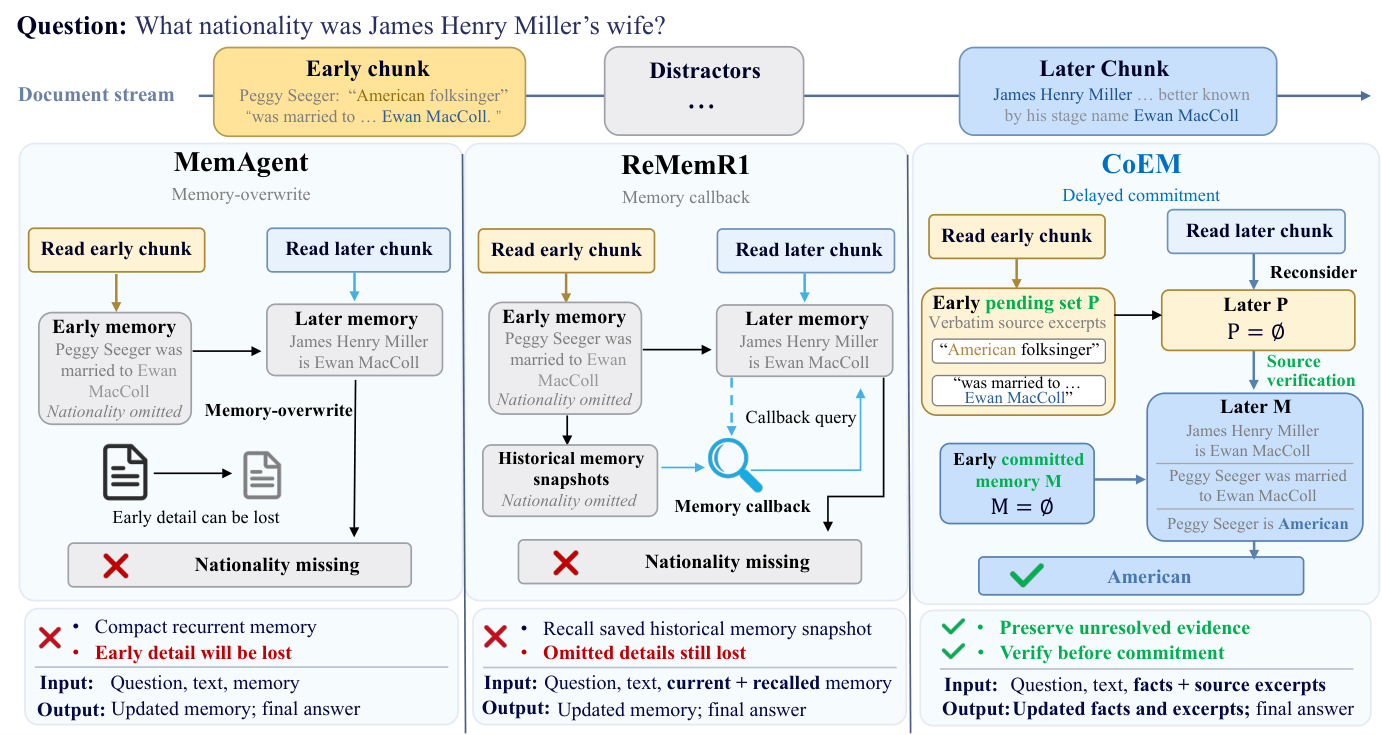
Системы с рекуррентной памятью читают длинный вход частями. После каждого фрагмента модель записывает краткое резюме в ограниченную текстовую память, передаёт его на следующий шаг и больше не возвращается к исходному тексту.
Такая схема экономит контекст, но требует сразу решить, что важно. Фрагмент может казаться посторонним, пока следующий документ не свяжет имя с псевдонимом, произведение с актёром или событие с датой. Если первая деталь не попала в резюме, восстановить цепочку уже нельзя.
В диагностическом анализе трёх наборов вопросов от 32,03 до 44,53% примеров содержали сведения с отложенной значимостью. Это не редкий пограничный случай, а повторяющаяся причина ошибок: смысл раннего фрагмента раскрывается лишь после чтения более позднего.
CoEM делит тот же фиксированный бюджет памяти на две части. Подтверждённая память хранит короткие факты, а отложенный набор — дословные выдержки, ценность которых пока неясна. Исходные документы при этом по-прежнему читаются последовательно и не остаются доступными целиком.
Как CoEM решает, когда зафиксировать факт
После получения нового фрагмента модель повторно рассматривает каждую отложенную выдержку. Она может превратить её в краткий факт, сохранить до следующего шага или удалить. Если место заканчивается, система сначала освобождает его: фиксирует либо отбрасывает самые ранние выдержки.
Перед записью факта отдельная замороженная модель проверяет, следует ли формулировка из процитированного источника. Факт, который объединяет несколько отрывков, должен ссылаться на все нужные фрагменты. Проверка подтверждает опору на доступный текст, но не гарантирует истинность источника и правильность итогового ответа.
Обновление памяти выполняется целиком или не выполняется вообще. Если хотя бы один новый факт не проходит проверку либо результат превышает бюджет, CoEM сохраняет прежнее состояние. Это защищает уже записанные сведения от частично выполненного сокращения.
Политику памяти обучают с подкреплением по двум сигналам. Первый зависит от правильности конечного ответа, второй штрафует неподтверждённые факты, недоступные цитаты и нарушения бюджета на каждом шаге. Поздняя ошибка возвращает сигнал к более раннему решению сохранить выдержку, поэтому модель учится не просто выбирать сведения, а удерживать их до подходящего момента.
Метод проверяли с Qwen3.5-4B и Qwen3.5-9B на HotpotQA, 2WikiMultiHopQA и MuSiQue. Все три набора требуют собрать ответ из нескольких разнесённых фрагментов; обучение шло на HotpotQA, а два других набора использовали для проверки переноса без дополнительного обучения.
На входе из 6 400 документов CoEM с Qwen3.5-9B обошёл лучший сопоставимый метод на 10,4–11,4 пункта F1 при одинаковом бюджете памяти. F1 объединяет точность и полноту ответа в одну оценку. В искусственном тесте, где связанные свидетельства разделяли большим промежутком, преимущество достигло 25,3 пункта при расстоянии в 128 частей текста.
Когда стоит менять архитектуру продукта
Работа меняет планы для систем, которые читают поток документов по частям и не могут держать исходный корпус в контексте. Это могут быть агенты для многошагового поиска, анализа досье или обработки длинных цепочек записей, где поздний документ меняет смысл раннего.
Главное архитектурное следствие — не сжимать каждый найденный фрагмент сразу. Между исходным текстом и постоянной памятью нужен ограниченный слой дословных выдержек, а решение о записи следует пересматривать после поступления нового контекста. Для каждого краткого факта полезно сохранять ссылки на поддерживающие его отрывки.
Цена такой схемы — более сложный контур: политика управления памятью, проверяющая модель, контроль двух бюджетов и повторное рассмотрение отложенных записей. CoEM также требует отдельного обучения с подкреплением; это не настройка подсказки, которую можно добавить к любой модели без подготовки данных и вычислений.
Проверка охватывает ответы на вопросы по нескольким документам и две модели семейства Qwen. Для анализа кода и научных материалов статья предлагает тот же принцип лишь как следующее направление, поэтому перенос на производственные документы потребует собственного сравнения с обычным сжатием и поиском по базе.
Источники
Иллюстрация: рисунок из статьи «CoEM: Empowering Long-Context Reasoning with Commit-on-Evidence Memory», Jingguang Li, Yebo Wu, Zuyi Guo и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


