
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Диалоговый поиск можно улучшить без обучения отдельной модели. CompCQR, работа Seoul National University и LG AI Research, повысил средний обратный ранг до 22,5% относительно сильнейшего базового подхода, хотя препринт не рецензирован и числа получили сами авторы. Для продуктовой команды это переносит затраты с подготовки данных и дообучения на многократный запуск уже существующего поисковика.
Пять частей запроса превращаются в сотни вариантов
Обычный поиск плохо обрабатывает реплики вроде «А что произошло потом?»: смысл зависит от предыдущих вопросов и ответов. Системы диалогового поиска поэтому переписывают текущую реплику в самостоятельный запрос, но часто вызывают LLM несколько раз или обучают отдельную модель под эту задачу.
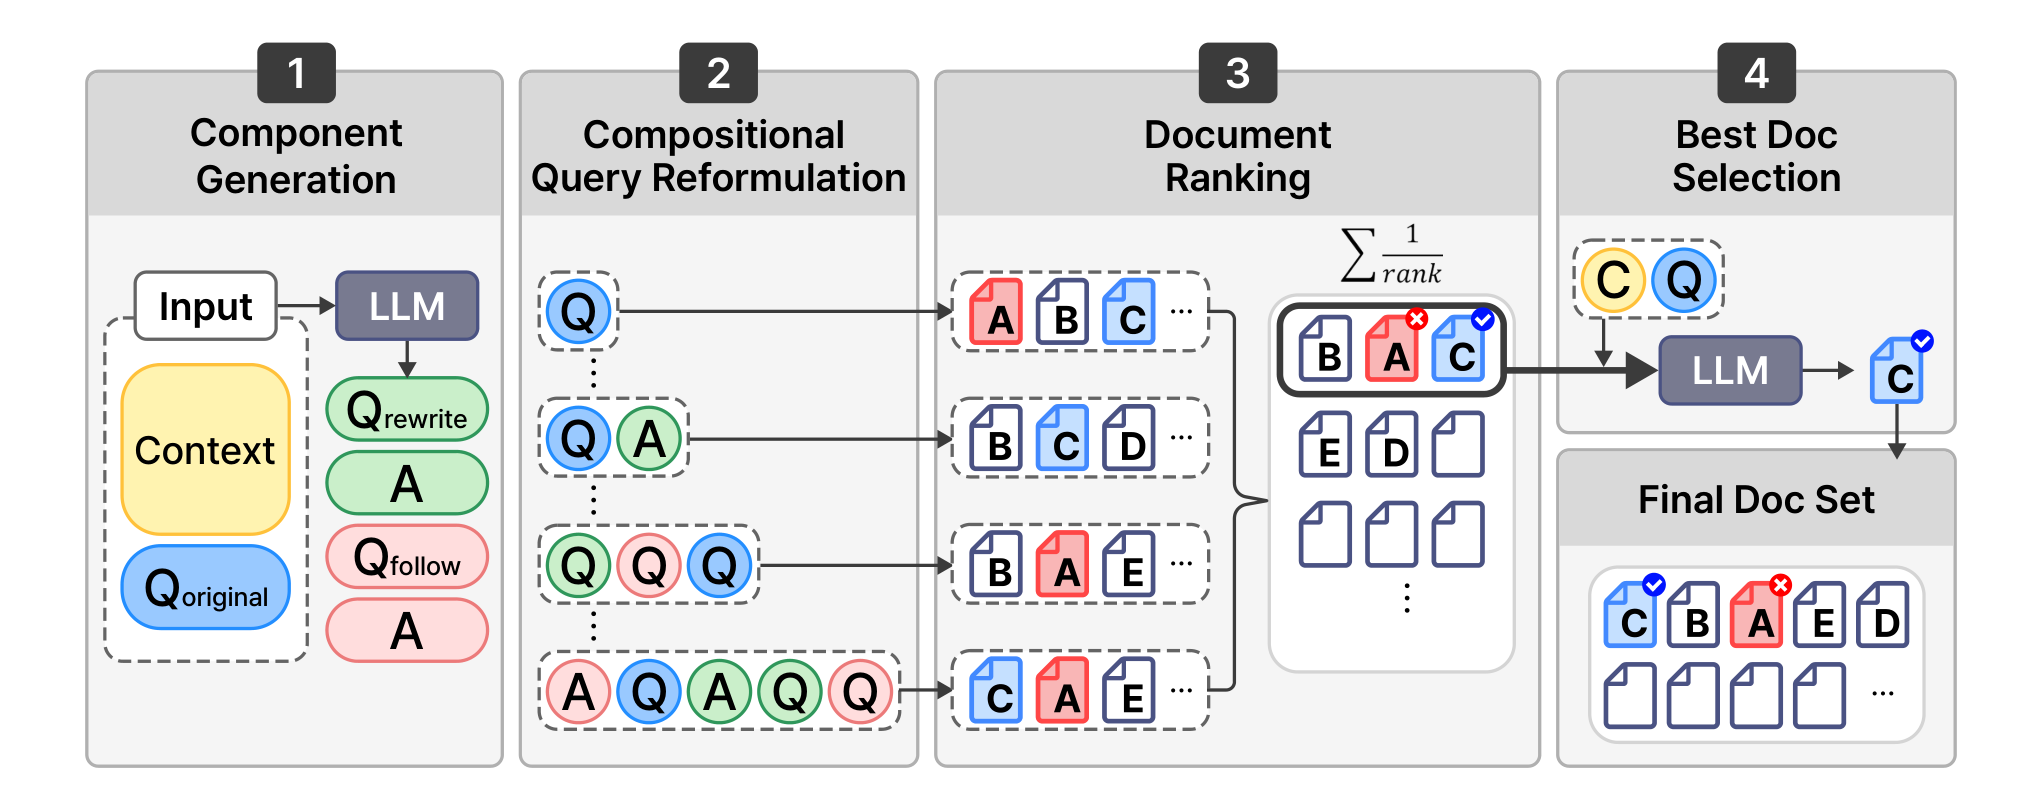
CompCQR сначала делает два обращения к LLM. Первое создаёт самостоятельный запрос и предполагаемый ответ, второе — возможный следующий вопрос пользователя и ответ на него. Вместе с исходной репликой получается пять смысловых частей.
Метод соединяет эти части в разном составе и порядке, получая 325 запросов без новых обращений к LLM. Каждый вариант отправляется в поисковик отдельно. Это не обычное размножение перефразировок: содержание остаётся почти тем же, а меняются состав и последовательность фрагментов.
Затем CompCQR объединяет найденные документы по обратным рангам. Документ получает больше веса, если встречается в выдаче для многих вариантов и занимает там высокие позиции. При равенстве выигрывает тот, который нашли больше запросов.
Последнее обращение к LLM отвечает уже за точность. Модель получает историю диалога, текущий вопрос и верхнюю часть объединённой выдачи, выбирает документ с достаточной информацией для ответа и переносит его на первое место. Остальной список не перестраивается.
Порядок слов меняет набор найденных документов
Главное наблюдение работы касается плотного поиска, который представляет запросы и документы числовыми векторами. На TopiOCQA с поисковиком ANCE перестановка одинаковых частей меняла 28% документов в верхней части выдачи. Значит, варианты с одним содержанием исследуют разные участки поискового пространства.
Качество измеряли через средний обратный ранг: чем ближе первый релевантный документ к началу выдачи, тем выше показатель. На разреженном поиске BM25 максимальный относительный выигрыш над прежними подходами составил 14,7%. Разбор компонентов также показал, что предполагаемый ответ приносит больше всего пользы, а сведения о возможном следующем вопросе добавляют отдельные сигналы о намерении пользователя.
Проверка охватила четыре англоязычных набора диалогов: QReCC, TopiOCQA, CAsT19 и CAsT20. В экспериментах использовали Llama-3.1-8B-Instruct и GPT-4.1-mini, а документы искали через BM25 и ANCE. В сравнение вошли методы с обучением, гибридные системы и подходы, которые работают только через подсказки для LLM.
Результат зависел не только от генерации запросов. Когда из схемы убирали объединение выдачи или финальный выбор документа, качество падало. CompCQR работает как конвейер: разнообразные запросы повышают полноту, объединение сохраняет повторяющиеся сигналы, а LLM исправляет верхнюю позицию.
Когда CompCQR меняет архитектурный план
Работа даёт альтернативу командам, которые собирались размечать диалоги и дообучать модель переформулирования запросов. CompCQR можно поставить перед готовым поисковиком и настроить на проверочном наборе, не меняя саму модель поиска. Это сокращает объём собственного машинного обучения и упрощает замену LLM.
Но отсутствие обучения не означает низкую стоимость всего конвейера. Экономия приходится на обращения к LLM, тогда как каждый составной запрос запускает поиск заново. Для BM25 порядок частей не влияет на результат, поэтому остаётся только 31 уникальная комбинация; у плотного поиска вариантов существенно больше, и вместе с ними растут задержка и вычислительная нагрузка.
Поэтому CompCQR выглядит практичнее для поиска, где качество важнее минимальной задержки: исследовательских помощников, внутренней базы знаний или асинхронной подготовки ответа. В интерактивном продукте со строгим временем отклика сначала потребуется измерить весь путь от генерации частей до объединения документов, а не только стоимость LLM.
Метод также стоит проверять именно с тем поисковиком и корпусом, которые пойдут в продукт. Работа показывает, что плотный и разреженный поиск предпочитают разные части запроса, а параметры объединения авторы настраивали на проверочных данных. Для русского корпуса результаты остаются гипотезой, поскольку эксперименты проводили на английском языке.
Источники
Иллюстрация: рисунок из статьи «CompCQR: Compositional Query Generation for Training-Free Conversational Search», Yunah Jang, Kang-il Lee, Joongbo Shin и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


