
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Система распознавания эмоций в диалоге может превзойти отдельную LLM по качеству и при этом реже обращаться к ней. В препринте, который не прошёл рецензирование и приводит замеры самих авторов, Sai Babu Udayagiri и коллеги получили лучший результат на всех проверенных наборах данных, передавая LLM только неуверенные прогнозы дешёвого классификатора. Для контакт-центра это меняет базовую архитектуру: LLM становится второй ступенью, а не обработчиком каждой реплики.
Уверенность классификатора управляет вызовами LLM
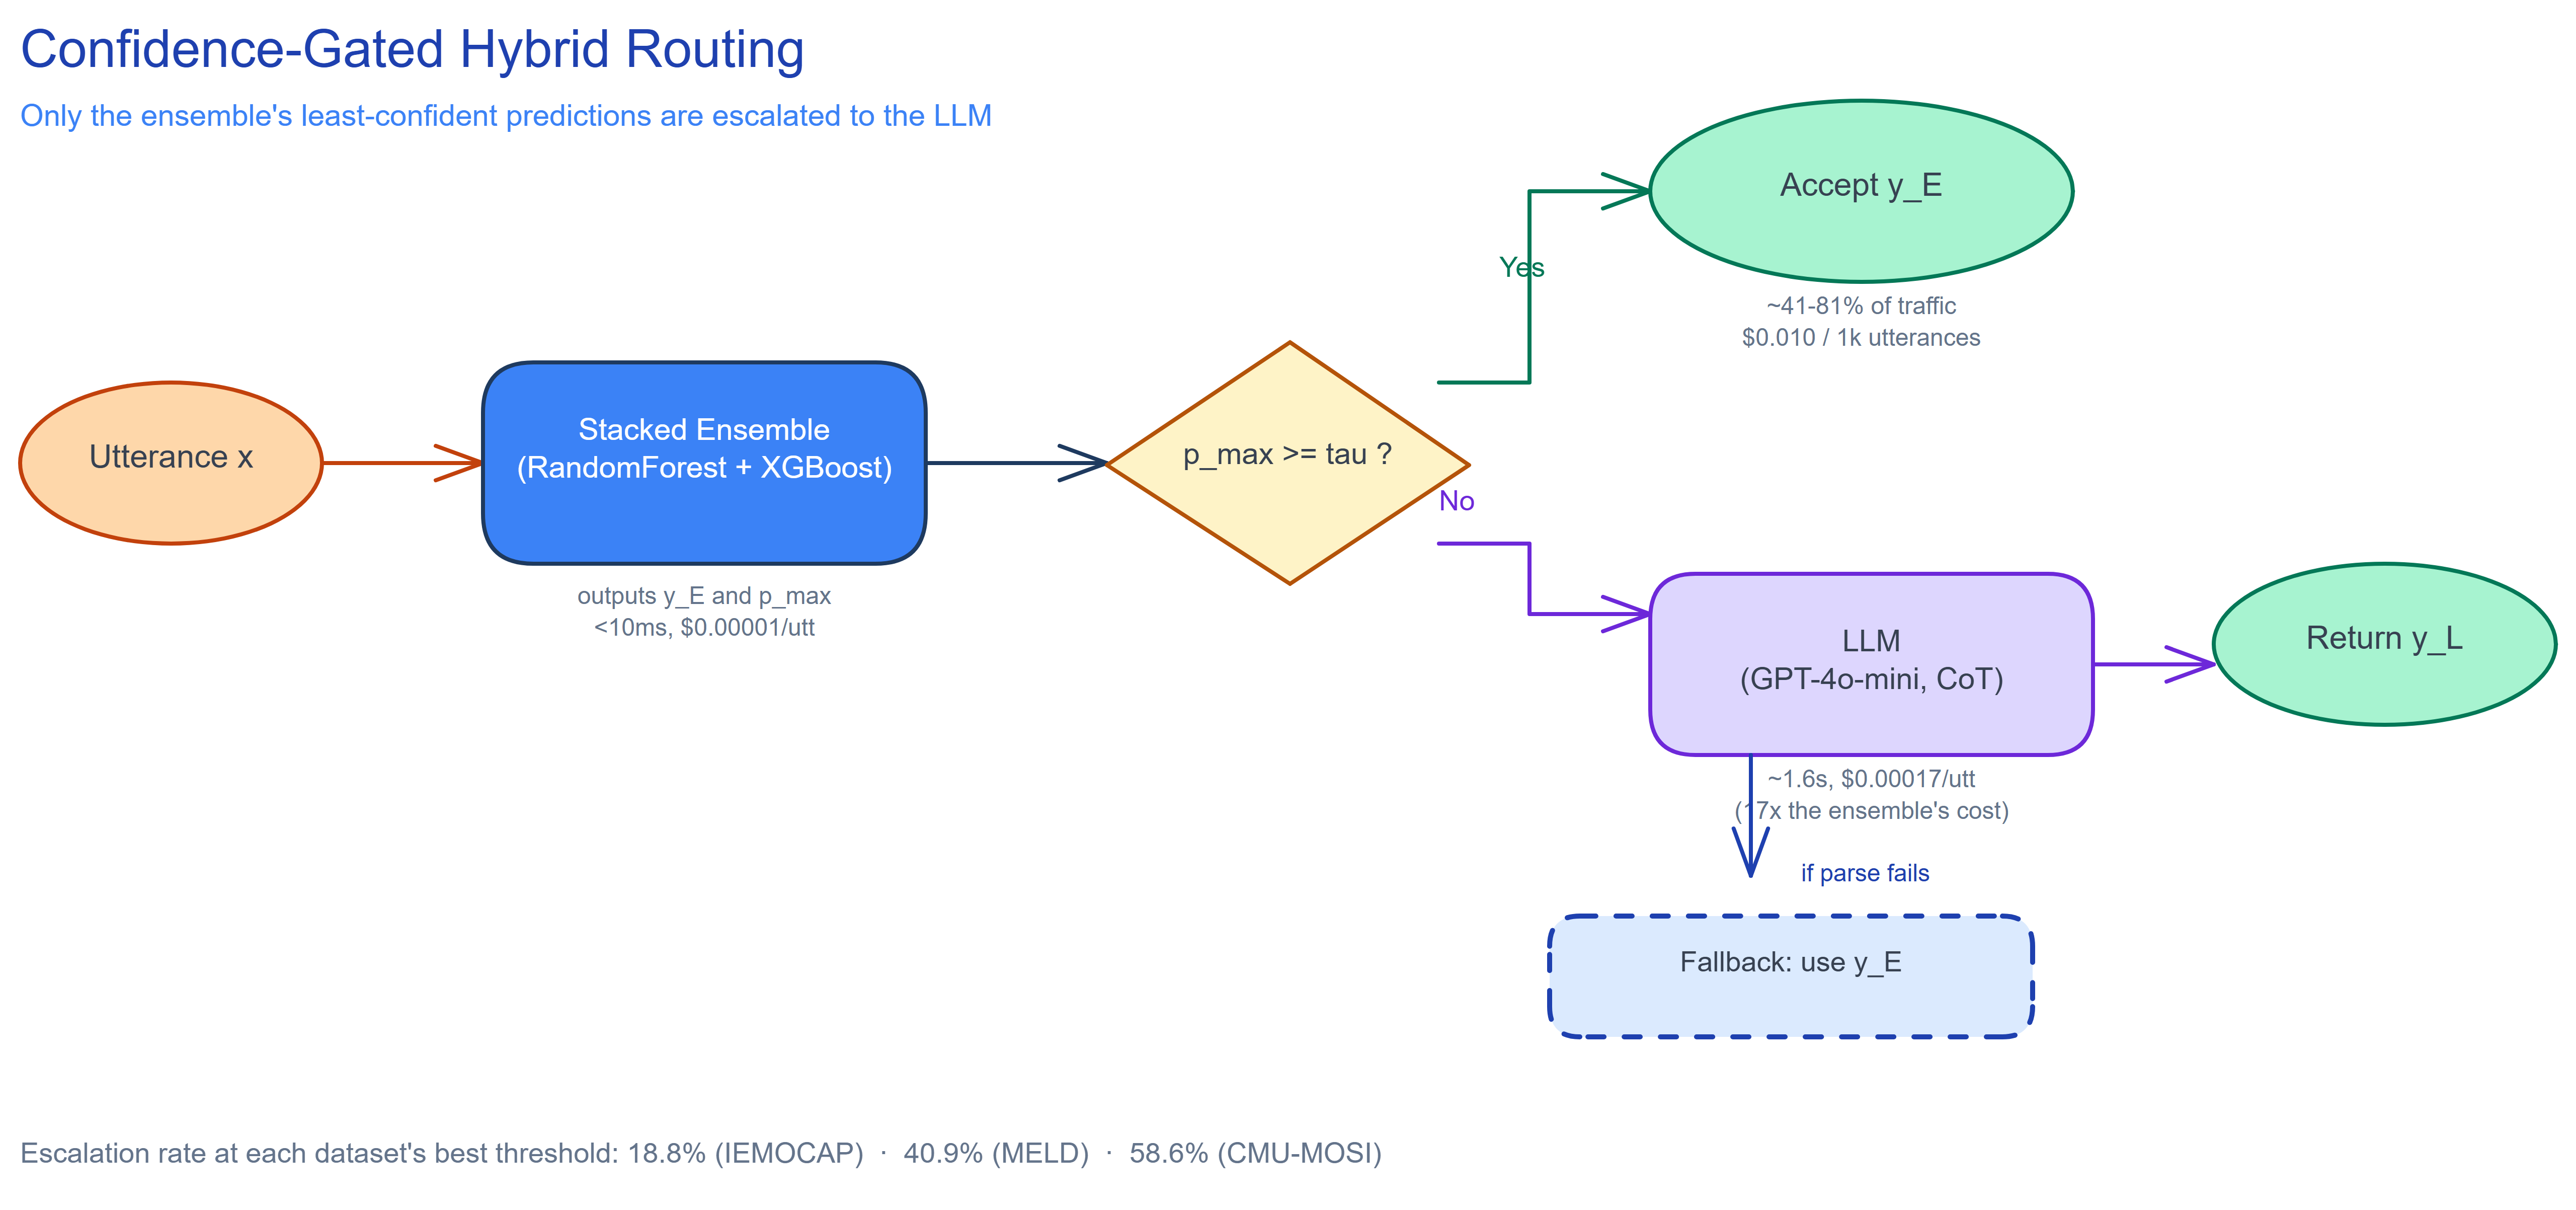
Первая ступень каскада — ансамбль из RandomForest и XGBoost, результаты которых объединяет логистическая регрессия. Он получает вектор текущей реплики, контекст предыдущих реплик и признак смены говорящего. Модели обучают отдельно для каждого набора данных, но для неё не нужны тонкая настройка трансформера и обслуживание на GPU.
Ансамбль возвращает класс эмоции и вероятность наиболее вероятного класса. Если вероятность выше заданного порога, система принимает этот ответ. Если ниже — отправляет реплику с контекстом в GPT-4o-mini или Llama-3-8B-Instruct. Когда ответ LLM не удаётся разобрать, каскад возвращается к прогнозу ансамбля.
Порог превращает качество и стоимость в управляемый параметр. Чем он выше, тем больше реплик уходит в LLM. Но схема работает только при правильно настроенной уверенности: модель не должна считать сомнительный прогноз надёжным. В экспериментах ансамбль скорее недооценивал свою уверенность, поэтому лишний раз вызывал LLM, а не пропускал сложную реплику.
Качество измеряли взвешенной F1-мерой: она объединяет точность и полноту по классам, учитывая частоту каждого класса. Проверка охватывает IEMOCAP с актёрскими диалогами, MELD с репликами из телесериала и CMU-MOSI с видеомонологами. Во всех случаях система анализировала текст; её не проверяли на реальных расшифровках разговоров контакт-центра.
Чистый ансамбль и чистая LLM ошибаются на разных репликах
На IEMOCAP каскад получил взвешенную F1-меру 0,620. Отдельный ансамбль достиг 0,595, а лучшая конфигурация GPT-4o-mini — 0,536. На этом наборе ансамбль лучше справлялся с длинными диалогами, тогда как LLM выигрывала на репликах с коротким контекстом.
На MELD и CMU-MOSI порядок менялся: там отдельная LLM обходила ансамбль. Деревья хуже распознавали редкие классы и нейтральные высказывания, а пошаговое рассуждение GPT-4o-mini на MELD, наоборот, слишком редко выбирало частый нейтральный класс. Поэтому ни один из чистых вариантов не оказался надёжным выбором для всех задач и поставщиков моделей.
Каскад использует это несовпадение ошибок. Он оставляет ансамблю реплики, на которых тот уверен, а спорные передаёт LLM. На MELD и CMU-MOSI гибрид также показал лучший численный результат, хотя на CMU-MOSI прибавка оказалась в пределах погрешности. Статистически значимый прирост подтвердился на IEMOCAP и MELD.
Экономика зависит от доли эскалаций. Для IEMOCAP обработка миллиона реплик каскадом стоила в расчёте работы около 82 долларов против 170 долларов при вызове LLM для каждой реплики. Ансамбль выполняется на CPU и не добавляет сетевую задержку к уверенным ответам.
Работа меняет архитектурный план, но не заменяет пилот
Команде, которая проектирует подсказки оператору, маршрутизацию обращений или анализ разговоров, имеет смысл сравнивать не две, а три схемы: локальный классификатор, сплошные вызовы LLM и каскад. Работа даёт готовый третий вариант без отдельной модели-маршрутизатора: решение принимает сама вероятность класса.
Переносить порог из статьи в продукт нельзя. В экспериментах его выбирали по полностью размеченной проверочной выборке, тогда как у нового контакт-центра такой выборки обычно ещё нет. Авторы смоделировали холодный старт: разметки 200 реплик хватало, чтобы подобрать порог с отставанием от оптимума на 0,3–0,6 пункта F1.
При выбранных порогах LLM получала 45,4–58,6% реплик. Это не схема, где дорогая модель включается только в исключительных случаях: бюджет и задержку всё равно нужно рассчитывать почти на половину потока. Зато долю вызовов можно менять явно, а причину маршрутизации — низкую уверенность первой модели — журналировать и проверять.
Перед внедрением нужен пилот на собственных расшифровках с теми же классами эмоций, языком и качеством распознавания речи, что будут в продукте. На пилоте стоит отдельно проверить калибровку вероятностей, стоимость при реальном распределении реплик и долю эскалаций по группам пользователей. Работа обосновывает каскад как исходную архитектуру, но её результаты не служат гарантией для домена контакт-центра.
Источники
Иллюстрация: рисунок из статьи «When to Call an LLM: A Confidence-Gated Hybrid for Cost-Effective Emotion Recognition in Conversational AI», Sai Babu Udayagiri, Arjun Chouhan, Ravisekhar Kanagala и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


