
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модели с рассуждением стали тратить меньше токенов без команды отвечать короче и без досрочной остановки. Команда University of Maryland, AI Foundations и Capital One сократила генерацию до 25% при сопоставимой точности; препринт не рецензирован, а числа получили сами авторы. Для сервисов с длинными цепочками рассуждений это предлагает способ снизить нагрузку на этапе генерации, не добавляя новую логику в рабочий контур.
Как уверенность превращают в обучающий сигнал
Метод ConfSFT начинается с обычных цепочек рассуждений, которые строит текущая версия модели. В них выбирают промежуточные точки: перед словом Wait или на границах абзацев. Эти маркеры нужны только для равномерного отбора состояний и не несут особого смысла.
В каждой точке модели показывают уже написанную часть рассуждения и просят сразу сформулировать пробный ответ. Уверенность вычисляют как среднее геометрическое вероятностей токенов этого ответа с поправкой на его длину. Эталонный ответ и отдельная модель-оценщик для такой разметки не нужны.
Этот показатель нельзя читать как вероятность правильного ответа. Уверенность 0,8 не означает, что модель права в восьми случаях из десяти. Здесь это внутренний сигнал: насколько естественным для модели выглядит пробный ответ при уже накопленном рассуждении.
Затем оценку переводят в текстовую метку по шкале из 50 уровней с шагом 2%. При дообучении ошибку считают только по этой метке. Условие задачи, цепочку рассуждений и служебную фразу исключают из функции потерь, поэтому модель не учится воспроизводить конкретное решение и не получает штрафа за его длину.
После каждого цикла модель заново строит цепочки и размечает их своими обновлёнными вероятностями. Всего использовали 600 математических задач. Такой процесс учитывает, что после дообучения меняются и рассуждения, и внутренняя оценка ответа.
Во время работы ConfSFT больше не просит модель выводить уверенность. Не нужны проверяющая модель, порог остановки или отдельный запрос для пробного ответа: применяется стандартная генерация до обычного завершения.
Почему цепочки стали короче
Промежуточная уверенность оказалась связана сразу с двумя свойствами. Чем она выше, тем чаще пробный ответ совпадает с правильным и с окончательным ответом модели. Одновременно снижается средняя польза от дальнейшего рассуждения: продолжение реже исправляет результат.
До обучения модель часто игнорировала собственный сигнал. В цепочках Nemotron после первого достижения уверенности 0,95 она генерировала ещё 1766 токенов по медиане. В примерах это выглядело как повторная проверка уже найденного решения или новый вывод того же факта.
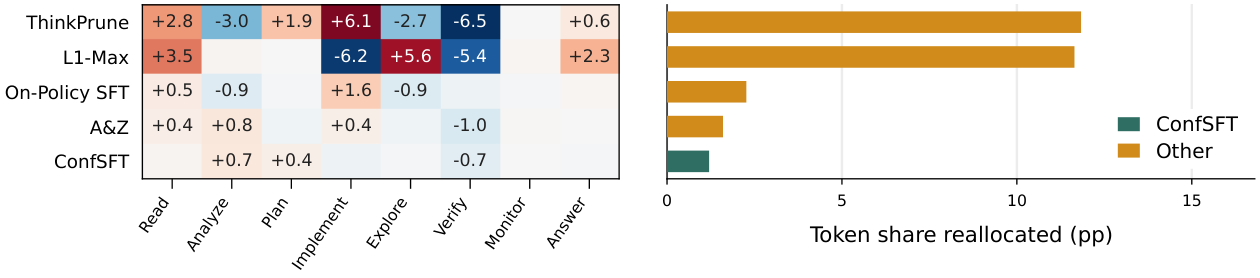
После ConfSFT такие повторы сокращались, хотя состав рассуждения заметно не менялся. Авторы разметили цепочки по типам действий — анализу, планированию, вычислению, проверке и другим — и обнаружили, что доли этих действий в основном сохраняются. Метод не вырезал один конкретный этап, а уменьшал общий объём вычислений.
Связь проверили на семействах Gemma, Qwen, Nemotron и GPT-OSS. Модели обучали на задачах AIME прошлых лет, подбирали вариант на AIME 2024, а затем оценивали на математике, естественных науках и программировании через AIME 2025, GSM8K, GPQA-Diamond, HumanEval и LiveCodeBench. Значит, показанный перенос охватывает несколько классов задач, но остаётся проверкой на тестах с формализованным ответом.
Замена уверенности на положение точки внутри цепочки или на признак правильности дала менее стабильный эффект. Перемешивание меток между примерами почти убрало выигрыш или развернуло его в обратную сторону. Следовательно, результат связан не просто с дообучением на промежуточных состояниях: важна связь конкретного состояния с его собственной градуированной оценкой.
Когда ConfSFT меняет планы продукта
Работа не предлагает новый режим API, который можно включить при запросе. Команде нужен доступ к вероятностям токенов при подготовке данных и возможность дообучать веса модели. Если продукт использует только закрытый внешний API без такого доступа, метод сам по себе архитектурный план не меняет.
Для собственной модели ConfSFT позволяет перенести оптимизацию из рабочего контура в обучение. В отличие от ранней остановки, сервису не приходится во время каждого ответа извлекать промежуточные варианты, сравнивать уверенность с порогом и управлять завершением. Это упрощает обслуживание, а объём генерации сокращается внутри самой модели.
Цена этого решения возникает раньше: нужно построить цепочки, извлечь пробные ответы, вычислить метки и несколько раз обновить набор данных после изменения модели. Эталонная разметка не требуется, но вычислительная работа по подготовке примеров остаётся. Денежный эффект будет зависеть от инфраструктуры и тарифа, поскольку статья сравнивает токены и точность, а не стоимость эксплуатации.
Практический вывод узкий: ConfSFT стоит проверять там, где длинные рассуждения уже составляют заметную часть задержки или нагрузки и команда контролирует дообучение. Он не заменяет оценку качества на данных продукта — сокращение цепочки полезно только при сохранении нужной точности на собственных задачах.
Источники
Иллюстрация: рисунок из статьи «Learning to Stop without Learning to Stop: Self-Supervised Confidence Training Improves Reasoning Efficiency», Parsa Hosseini, Akasha Tigalappanavara, Sumit Nawathe и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


