
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Разделённые ИИ-агенты научились сверять, одинаково ли планировщик и исполнитель понимают состояние среды, и исправлять разногласия до следующего действия. В работе Nanjing University, Meituan и University of Science and Technology of China доля успешных попыток в MiniGrid выросла на 15,8 процентного пункта, хотя препринт не рецензирован и числа получили сами авторы. Для систем с отдельными ролями это добавляет новый контроль: проверять нужно не только план и действие, но и факты, на которых они основаны.
Один план не гарантирует общего понимания среды
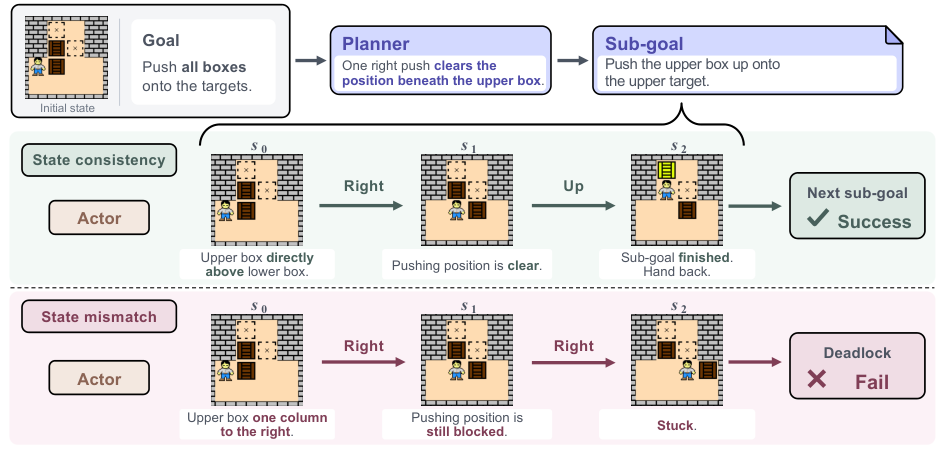
В архитектуре Plan-Act планировщик разбивает цель на подзадачи, а исполнитель выбирает конкретные действия. Они могут по-разному прочитать одно наблюдение, даже если исполнитель точно следует полученной подзадаче.
В примере с Sokoban планировщик правильно определяет положение ящика и ожидает последовательность «вправо, затем вверх». Исполнитель считает, что ящик находится на одну клетку правее, дважды толкает его вправо и заводит задачу в тупик. Оба рассуждения внутренне связны, но опираются на разные состояния среды.
Такое расхождение встретилось хотя бы один раз в 85% разобранных неудачных траекторий. Оно сохранялось при работе с изображениями и структурированным текстом, а разница между ролями превышала обычный разброс повторных ответов одной модели.
Чтобы находить конфликт, обе роли вместе с подзадачей или действием возвращают компактное описание состояния в JSON. Схема заранее задаёт поля и допустимые значения: например, положение объекта, условие для действия или достижение цели. Система сравнивает ответы на одном и том же наблюдении и отмечает поля, где значения противоречат друг другу.
Для самой проверки не нужны правильный ответ среды и отдельная модель-оценщик. Однако совпадение ответов ещё не означает, что они верны: обе роли могут одинаково ошибиться.
Контролируемые вмешательства показали, что важна именно информация о состоянии, а не дополнительный текст. Для GPT-5.6-sol корректный возврат управления планировщику при невыполнимой подзадаче вырос с 0,4% до 94,5%. Для Qwen3-VL-8B доля первых действий, которые приближали выполнимую подзадачу к цели, выросла с 32,2% до 80,9%.
Как ConPAct возвращает противоречие в цикл агента
ConPAct-I запускает сверку в момент передачи управления между ролями. Если значения расходятся, система приостанавливает действия в среде и возвращает обеим ролям спорные поля вместе с их прежними ответами.
Планировщик и исполнитель повторно изучают свои наблюдения, обмениваются объяснениями и могут изменить описание состояния. Вместе с ним они пересматривают подзадачу или следующее действие. Система снова сравнивает поля и продолжает цикл, пока ответы не совпадут либо не закончится отведённый бюджет обсуждения.
Такой контур отличается от свободной самопроверки. Модель не получает общую просьбу «найти ошибку», а видит конкретное противоречие: одна роль считает проход свободным, другая — заблокированным. Проверка остаётся программной, поэтому для неё не требуется ещё один вызов модели в роли судьи.
Для обучения предложены два варианта. ConPAct-S собирает траектории с включённой сверкой и оставляет согласованные фрагменты работы, а также диалоги, в которых роли устранили конфликт. Ошибочные ответы сохраняются в контексте, чтобы модель видела причину исправления, но обучается она только на допустимом согласованном ответе.
ConPAct-R подходит, если у команды уже есть траектории ReAct. Учитель разбивает записанную последовательность действий на подзадачи, добавляет описания состояния и восстанавливает обмен между ролями. Возле неудачных действий он создаёт примеры ошибочного понимания и последующего исправления, не меняя исходную последовательность действий.
Командам стоит добавить контракт состояния до нового обучения
Работа меняет план разработки для систем, где планировщик и исполнитель вызываются отдельно. Между ними полезно передавать не только текстовую подзадачу, но и машиночитаемый контракт состояния: небольшой набор фактов, которые обе роли обязаны заполнить по одинаковой схеме.
Первый практический шаг не требует дообучения. Можно выбрать факты, от которых зависит следующее действие, сравнивать их на границе ролей и приостанавливать необратимые операции при конфликте. Логи расхождений затем покажут, какие поля стоит включить в обучающие примеры.
Цикл согласования добавляет вызовы модели и задержку, поэтому его разумно запускать на передачах управления и перед действиями с заметными последствиями, а не после каждого рассуждения. Если состояние нельзя выразить компактными взаимоисключающими значениями, программное сравнение потребует отдельной нормализации.
Основные проверки прошли в Sokoban, Crafter, Procgen и MiniGrid/BabyAI с моделями семейств Claude, GPT, Kimi и Qwen. Среды охватывают изображения и текстовые состояния, однородные и смешанные пары моделей, но остаются игровыми и имеют доступное для оценки истинное состояние. Поэтому работа обосновывает сам механизм сверки, а не перенос конкретного размера выигрыша на браузерную автоматизацию или бизнес-процессы.
ConPAct не заменяет качество планирования и исполнения. Он закрывает более узкий сбой: две способные роли принимают разумные решения о разных версиях одной и той же ситуации.
Источники
Иллюстрация: рисунок из статьи «Consistent Plan-Act for Long-Horizon Agentic Tasks», Heng-Zhuang Li, Yi-Kai Zhang, Yu Wang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


