
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Автоматическая диагностика ИИ-агентов стала точнее на длинных журналах, когда модель-оценщик заставили искать пропущенные свидетельства, а не подтверждать первую версию сбоя. В препринте Scale AI, который не проходил рецензирование и где все числа получили сами авторы, Continual Search поднял F1 для GPT-5.5 более чем на 40% — с 0,349 до 0,498. Для команд это сдвигает внимание с выбора более крупной модели на то, как она просматривает журнал и пересматривает диагноз.
Правдоподобная ошибка не всегда оказывается первой
При разборе сбоя нужно найти не последнее видимое последствие, а первое существенное отклонение от правильного хода работы. Именно оно показывает, что исправлять: модель, управляющий код агента, среду исполнения или средство проверки результата.
В длинном запуске эти события могут находиться далеко друг от друга. Агент делает вызовы инструментов, повторяет попытки, получает состояния среды и сохраняет промежуточные файлы. Ошибка проявляется в конце, хотя её причина скрыта в раннем ответе сервиса, неверной конфигурации или незамеченном результате инструмента.
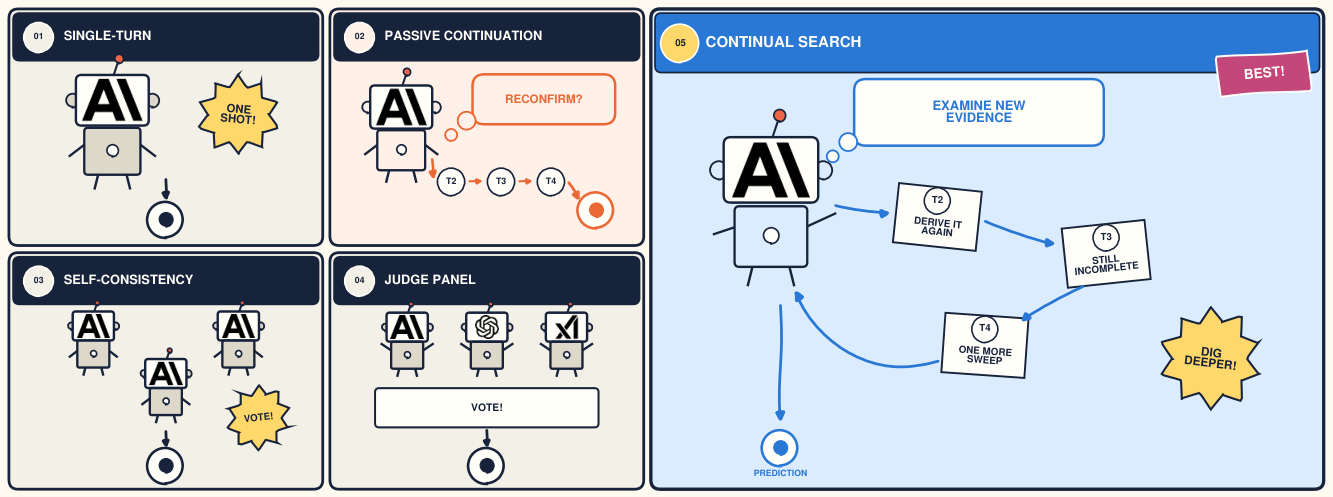
Обычная модель-оценщик проходит по доступным материалам один раз. Как только она находит связное объяснение, дальнейший поиск часто прекращается. Повторная просьба «проверь ответ» тоже не решает проблему: модель рассуждает над уже прочитанным, но не обязательно открывает другие файлы или участки журнала.
Continual Search начинает с того же первого диагноза, но затем требует оспорить его и найти ещё не проверенные свидетельства. Между обычным продолжением и Continual Search менялась только эта инструкция; модель, материалы запуска, инструменты и исходный ответ оставались одинаковыми. Поэтому эксперимент отделяет поиск новых данных от простого увеличения времени на рассуждение.
Метод проверяли на MegaRCA-Mix, TRAIL, TELBench, AgentRx и Who&When. MegaRCA-Mix включает 50 размеченных вручную сбоев с медианным объёмом журнала 286 тысяч токенов, а в самом коротком наборе медиана составляет 2,4 тысячи. Модели получали доступ только на чтение и сами выбирали, какие журналы, результаты проверки и файлы среды открыть.
Дополнительные проходы помогают, только когда остаётся что искать
На длинных журналах Continual Search дал лучший итоговый результат и для GPT-5.5, и для Opus-4.8. У второй модели F1 на MegaRCA-Mix вырос с 0,478 до 0,620. F1 объединяет точность и полноту в одну оценку: высокий результат требует и редко обвинять неверный компонент, и находить большую часть реальных причин.
Рост совпал с тем, что модели читали больше уникальных материалов. На TRAIL объём впервые увиденных свидетельств при Continual Search вырос примерно на 38%, а при обычном продолжении — на 14%. Повторно открытые фрагменты из подсчёта исключали, поэтому разница отражает не перечитывание, а расширение поиска.
Несколько независимых запусков модели и группа разных моделей-оценщиков уступили последовательному поиску. Дополнительные вычисления сами по себе не компенсировали пропущенные свидетельства: независимые попытки могли снова останавливаться на одной и той же правдоподобной версии.
На коротких журналах картина менялась. Первый проход уже охватывал большую часть доступных данных, а требование продолжать поиск иногда заставляло модель отказаться от правильного ответа. Значит, число проходов нельзя задавать одинаково для любой траектории: нужен признак того, что в журнале ещё остались непросмотренные области.
В планах стоит менять контур диагностики, а не базовую модель
Работа не даёт основания переносить диагностику на более дорогую модель только ради её класса. Внутри одного семейства модель более низкого уровня могла обойти старшую, если лучше исследовала материалы запуска. Для архитектуры важнее предоставить оценщику выборочный доступ к полному набору артефактов и сохранять историю уже проверенных свидетельств.
Практический контур должен отделять поиск от вынесения вердикта. На каждом проходе модель фиксирует текущую гипотезу, перечисляет факты в её пользу, ищет противоречия и открывает ещё не изученные части запуска. Остановиться можно, когда новые проходы перестают расширять набор свидетельств, а не когда модель несколько раз повторила один диагноз.
Такой подход особенно уместен для агентов, которые долго работают с файлами, внешними сервисами и изолированными средами. Если журнал короткий и полностью помещается в один проход, Continual Search добавит расходы и может ухудшить ответ. Следовательно, его стоит включать по масштабу и структуре конкретного запуска, а не делать обязательным этапом для каждого сбоя.
Диагноз при этом относится только к наблюдаемой записи. В экспериментах часть агентов работала на закрытых моделях, чьи внутренние рассуждения недоступны; реальная причина могла возникнуть там и проявиться позже. Такой результат годится для исправления видимых компонентов системы, но не доказывает, что восстановлена полная причинная цепочка.
Источники
Иллюстрация: рисунок из статьи «Root-Cause Attribution Is a Search Problem: Continual Search for Long-Horizon Agent Failures», Harsh Raj, David Lee, Anas Mahmoud и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


