
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Оценку моделей предложили проверять вместе с правилами подсчёта, чтобы отделить устойчивые места лидерборда от сравнений, где победитель меняется вместе с методикой. Хотя работа не рецензирована и числа получили сами авторы, в проверке LLM-оценщиков 12,25% попарных сравнений потребовали отказаться от однозначного вывода. Значит, одного итогового балла недостаточно: вместе с ним нужно фиксировать условия, при которых сохраняется порядок моделей.
Контракт оценки задаёт версию эталонной разметки, функцию подсчёта и порог, после которого результат засчитывают. Протокол требует заранее объявить эти условия, измерить расхождения между ними, определить область допустимого сравнения, статистически подтвердить устойчивые результаты и пометить остальные как спорные. Так смена методики становится проверяемой частью эксперимента, а не скрытой настройкой лидерборда.
Для LLM-оценщиков проверили 17 моделей на почти 50 тысячах парных сравнений. Для 69% сравнений с достаточным отрывом верхняя оценка доли спорных случаев не превысила 7,2%; при малом отрыве результаты чаще зависели от состава оценщиков. Сверка с человеческими метками показала, что 65% спорных случаев вызваны ошибкой модели-оценщика, а не неоднозначностью примера.
Обучаемая часть метода не дала убедительного преимущества перед простым правилом. В аудите DocRE весь её запас свёлся к одному сравнению, где система вовремя отказалась выбрать победителя; правило без обучения прошло те же основные проверки. Для внедрения полезнее сам протокол и журнал спорных решений, чем отдельная нейросеть поверх метрик.
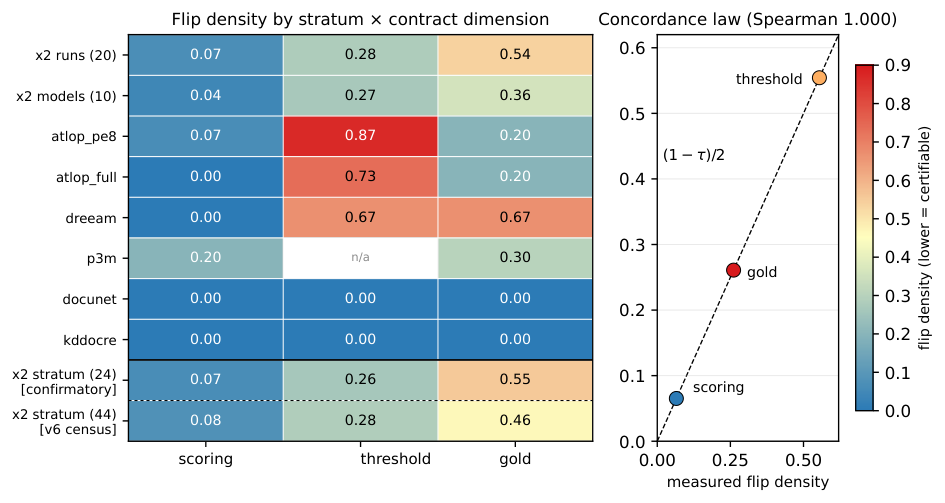
Работу проверяли в двух средах: на 44 запусках одной внутренней архитектуры DocRE и на панели LLM-оценщиков. Статистическое подтверждение в DocRE относится только к однородному семейству, а не к порядку опубликованных моделей; на реальных значениях уверенности подтверждение между разными моделями пришлось отозвать. Метод поэтому помогает очертить границы лидерборда, но не превращает любой набор оценок в надёжный рейтинг.
Источники
Иллюстрация: рисунок из статьи «Contract-Explicit Evaluation: From Auditing Learned Readers to Scoped Certificates», Hao Lu, Weixing Zhu, Ruiyang Li, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


