
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Политику управления научили переноситься между похожими динамическими системами по записям, где нет последствий управляющих действий. Niklas Emonds и Georgia Koppe показали это в препринте, который не рецензирован и приводит их собственные замеры: на новых вариантах Lorenz-63 награда составила −0,036 против −0,046 при подстановке вектора ближайшей обучающей системы; чем выше значение, тем лучше результат. Новый объект можно приспособить к готовому контроллеру без повторного обучения самой политики — если заранее известно, как воздействие меняет его состояние.
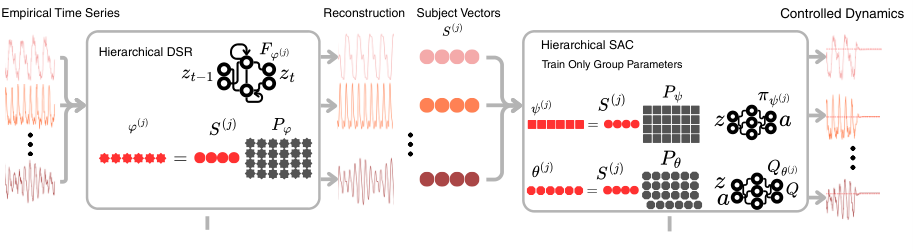
Сначала модель восстанавливает общую динамику группы систем и описывает различия между ними низкоразмерными векторами. Те же векторы задают параметры общей политики и функции ценности, поэтому различия в движении системы сразу влияют на способ управления. Политику обучают только в симуляции: действие добавляет возмущение к скрытому состоянию, после чего модель рассчитывает следующий шаг.
Общая политика переносилась на реальные уравнения симуляторов надёжнее, чем отдельные политики для каждого восстановленного мира, хотя внутри обучающих симуляций отдельные контроллеры работали не хуже. Это указывает на полезный эффект ограничения: общая политика меньше подстраивается под ошибки конкретной модели. На Lorenz-63 она также получила более высокую среднюю награду, чем MPC, который заново планировал последовательность действий на каждом шаге.
Метод проверяли на семействе из 64 вариантов Lorenz-63, двойных маятниках и моделях по нейронно-поведенческим записям. В последнем опыте действия разрешали менять только декодированную нейронную активность, а движение руки должно было измениться через восстановленную динамику; модель смогла подавить предсказанное движение. Эти результаты остаются проверкой в симуляции: записи без действий не позволяют установить, как физический исполнитель связан с системой, поэтому способ воздействия приходится задавать отдельно.
Источники
Иллюстрация: рисунок из статьи «Learning Transferable Policies from Action-free Time Series Through Dynamical Embeddings», Niklas Emonds, Georgia Koppe, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


