
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковые модели научили точнее возвращать слова из входного контекста, не заставляя основную сеть заново воспроизводить их через словарь. Nathan Godey и Yoav Artzi из Cornell University показали на CPLM, что модель со скользящим окном сравнялась с полной обработкой контекста при в 12 раз меньшем расходе памяти на токен, хотя препринт не рецензирован и все числа получили сами авторы. Для команд, которые обучают собственные модели под длинные документы и поиск, это указывает на альтернативу дорогому полному вниманию.
Как блок копирования обходит узкий словарный выход
Обычная языковая модель выбирает следующий токен через словарный выход: преобразует внутреннее состояние в вероятности для всего словаря. Это неудобный маршрут для буквального повторения. Около 60% токенов в FineWeb-Edu уже встречаются раньше в доступном контексте, но модель всё равно должна провести их через тот же выход, что и новые слова.
Проблема возникает и при обучении. Словарь обычно гораздо шире внутреннего представления модели, поэтому выходной слой сжимает обратный сигнал, который получает основная сеть. Даже если механизм внимания нашёл нужное место во входе, модели ещё надо научиться восстановить соответствующий токен через матрицу словаря.
CPLM добавляет рядом отдельный блок Copy-Paste. Он сопоставляет текущее состояние с прошлыми позициями, выбирает одну из них и переносит находящийся там токен в итоговое распределение. Если одинаковый токен встретился несколько раз, вероятности этих позиций складываются.
Основной выход управляет маршрутом с помощью специального токена <copy>. Ещё один обучаемый элемент позволяет отменить копирование и вернуться к обычному словарному прогнозу, если подходящей позиции нет. Модель сама решает, когда использовать каждый путь: отдельной разметки копируемых фрагментов и вспомогательной функции потерь не требуется.
Этот путь не только упрощает выдачу повторяющегося токена, но и передаёт основной сети менее сжатый сигнал обучения. Эксперименты с остановкой градиента показали, что большая часть выигрыша связана именно с этим сигналом, а не с готовым механизмом копирования на выходе. На крупнейшей конфигурации дополнительные параметры занимали 0,5%, а вычислительные затраты выросли примерно на 3%.
Копирование помогло не только повторять слова
Метод проверяли на моделях разных размеров вплоть до 1,7 млрд параметров. Их предобучали на FineWeb-Edu с полной обработкой контекста, скользящим окном, гибридным вниманием и Gated DeltaNet. Затем модели оценивали на текстах из других источников, задачах с длинным контекстом, поиске одного факта, математике, коде и выполнении инструкций.
Во всех проверенных архитектурах CPLM быстрее снижала ошибку предобучения. В варианте со скользящим окном модель достигла итогового качества обычной версии вдвое быстрее. Улучшение сохранилось и для токенов, которые блок Copy-Paste почти не использовал: дополнительный путь менял обучение всей сети, а не только обслуживал буквальные повторы.
После дообучения на примерах ответов средний результат по математике, коду и выполнению инструкций вырос на 1,2–5,1 пункта в зависимости от архитектуры. На LongBench, где проверяют работу с длинными документами, средний выигрыш составил 4,1 пункта. Особенно заметно менялась модель со скользящим окном: блок копирования давал ей доступ к далёким токенам без полного внимания ко всему документу.
Проверки охватывают исследовательские модели, а не крупные промышленные LLM. Они обучены по одному основному рецепту и не проходили настройку безопасности. Результаты показывают устойчивый эффект на выбранных масштабах и архитектурах, но сами по себе не доказывают, что тот же выигрыш сохранится у закрытых моделей с десятками или сотнями миллиардов параметров.
Когда CPLM меняет архитектурный план
Работа касается команд, которые контролируют предобучение или продолжают обучение открытой модели. Copy-Paste нельзя подключить к закрытой LLM через API: он меняет выходной слой, кэш контекста и путь обратного сигнала. Для продукта на готовой внешней модели архитектурный план поэтому не меняется.
Для собственной модели метод стоит проверять там, где ответы часто возвращают элементы входа: в коде, диалогах, обработке документов и поиске по внешним материалам перед генерацией. Скользящее окно может оставить локальное внимание дешёвым, а отдельный кэш ключей — дать доступ к словам за его пределами. Это не заменяет смысловой поиск, но уменьшает цену точного извлечения уже найденного фрагмента.
Практический эксперимент потребует обучить обычную модель и CPLM на одинаковых данных и сравнить не только итоговые тесты. Команде также нужно измерить память кэша, задержку генерации, качество на токенах без копирования и поведение на документах длиннее обучающего контекста. Именно эти замеры покажут, окупает ли архитектурная правка усложнение инфраструктуры.
У более точного копирования есть и продуктовый риск. Модель может вернее воспроизводить чувствительные или защищённые авторским правом фрагменты из входных документов. Если CPLM используют в поиске по корпоративным данным, проверка прав доступа и фильтрация ответа становятся частью оценки метода, а не отдельной задачей после запуска.
Источники
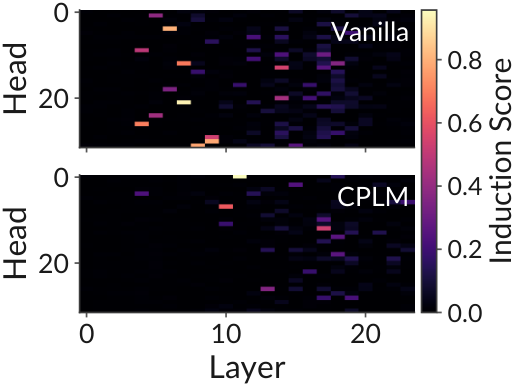
Иллюстрация: рисунок из статьи «Copy-Paste Language Models», Nathan Godey, Yoav Artzi, CC BY-SA 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


