
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Речевую диалоговую модель научили отвечать быстрее, не заменяя её токенизатор и синтезатор речи. Хотя препринт не рецензирован и все числа получили сами авторы, CoSTA примерно в 1,7 раза ускорила генерацию того объёма речевых токенов, который затем получает синтезатор. Для существующих систем это открывает путь к меньшей задержке без полной перестройки речевого контура.
Один токен заменяет повторяющуюся последовательность
Речевые диалоговые модели обычно используют одно пространство токенов и для генерации ответа, и для синтеза звука. Модель последовательно предсказывает речевые токены, а декодер превращает их в звуковую волну. Чем длиннее последовательность, тем больше шагов приходится выполнять один за другим.
Авторы из Institute of Automation, Chinese Academy of Sciences и связанных организаций предложили разделить эти два пространства. Во время генерации CoSTA использует расширенный словарь, где один новый токен может обозначать часто встречающуюся последовательность исходных токенов. Перед синтезом система детерминированно разворачивает его обратно, поэтому прежний декодер получает ровно тот формат, для которого был обучен.
Последовательности находят с помощью BPE — алгоритма, который многократно объединяет частые соседние пары. Здесь сжатие без потерь означает только обратимость разбиения: составной токен всегда можно восстановить в исходную последовательность. Это не гарантирует, что адаптированная модель выберет тот же ответ, поэтому одного нового словаря недостаточно.
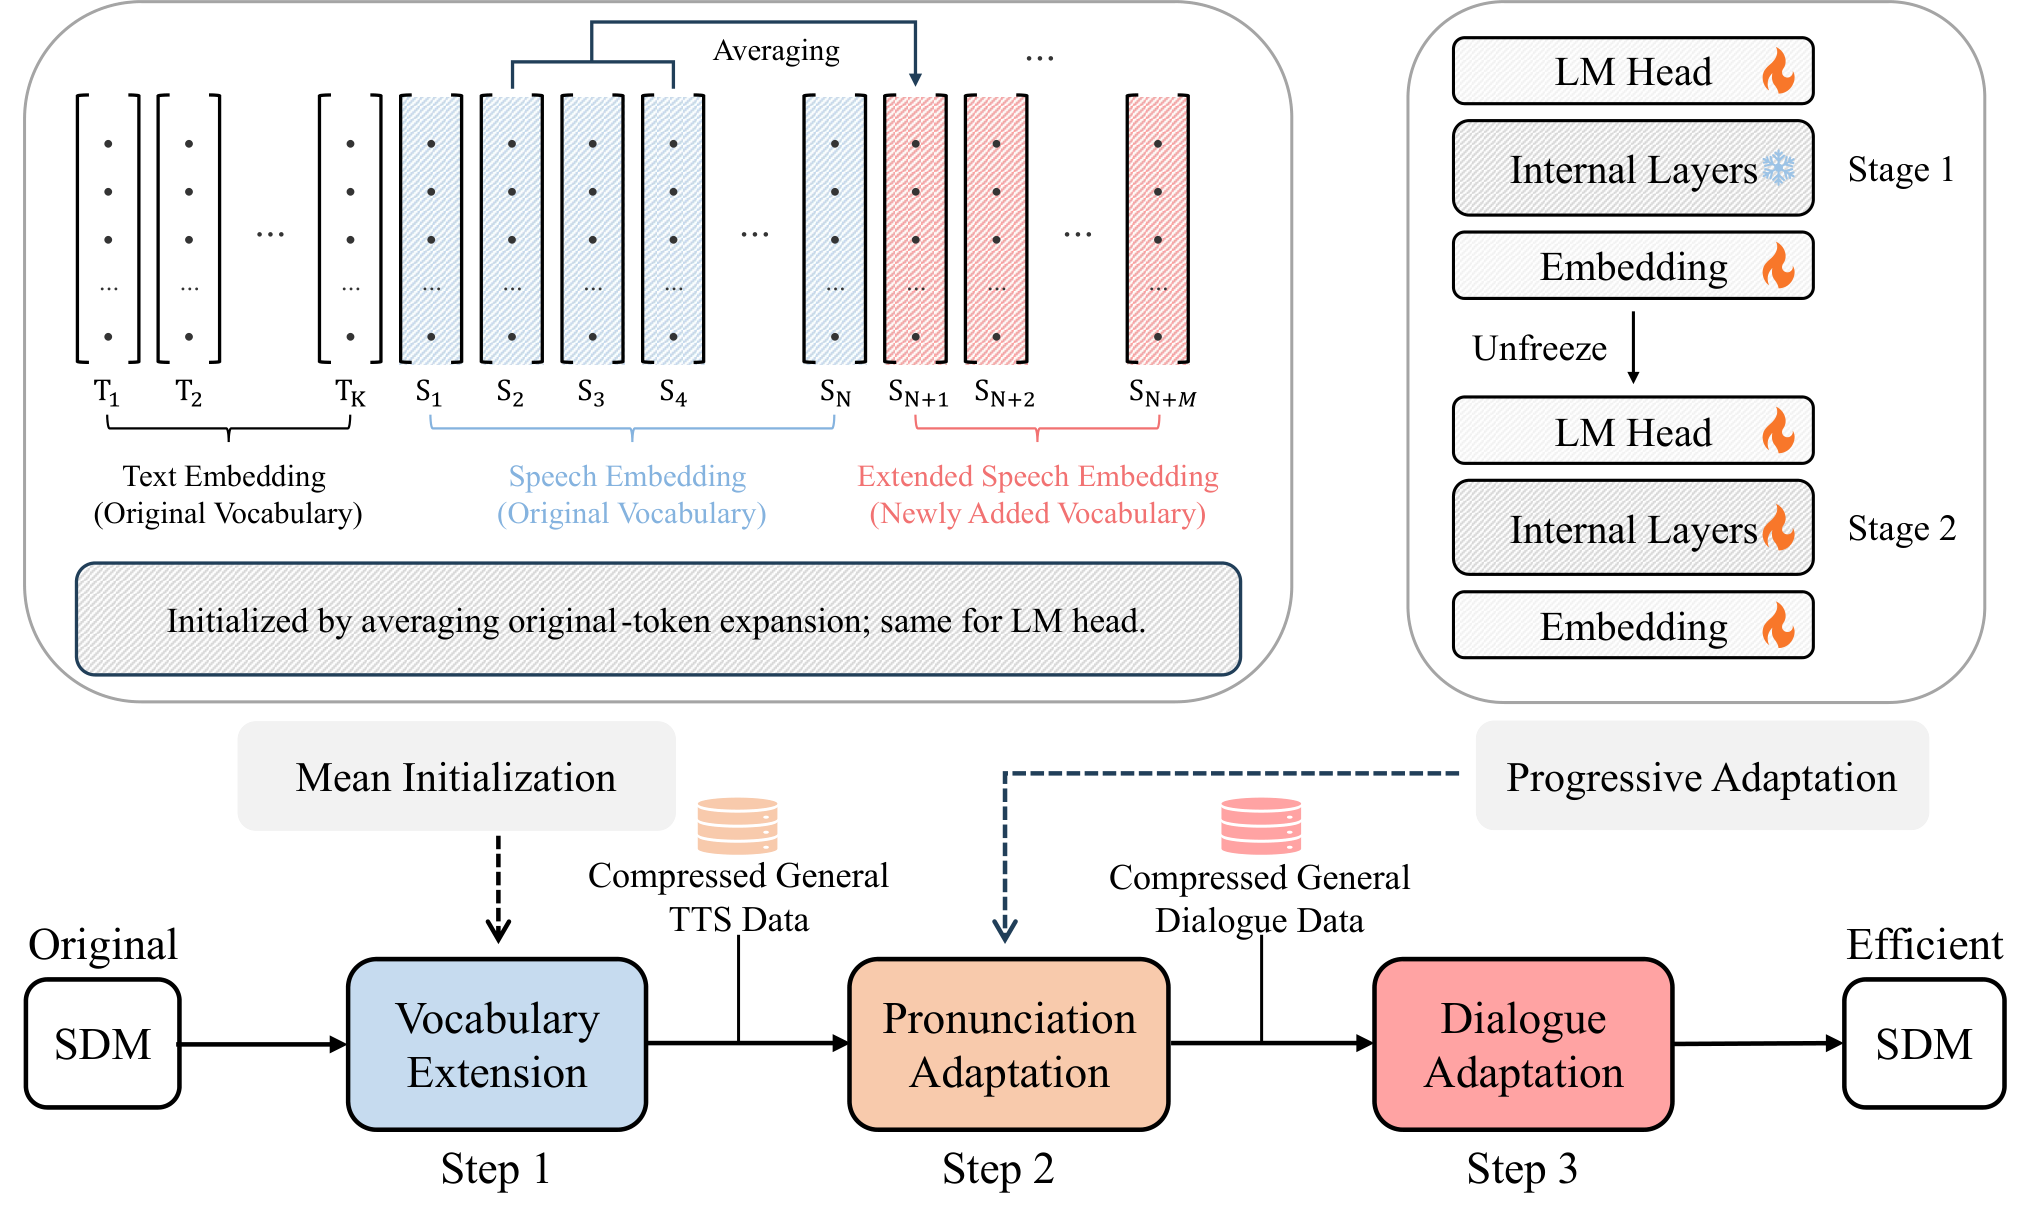
CoSTA адаптирует модель в три этапа. Сначала она добавляет составные единицы в словарь и инициализирует каждую усреднёнными параметрами исходных токенов. Затем модель учится произносить текст через сжатые последовательности, после чего проходит адаптацию на речевых диалогах. На последнем этапе речевой кодировщик и декодер остаются замороженными.
В основной конфигурации словарь расширили на 80 тысяч единиц. Новые строки в таблице представлений и выходном слое увеличили число параметров исходной модели примерно на 6%. Значит, метод сокращает число последовательных шагов, но одновременно делает дороже выбор следующего токена из расширенного словаря.
Ускорение дошло до полной задержки ответа
Главный замер считает, сколько исходных речевых токенов модель фактически производит за секунду после разворачивания составных единиц. Такая метрика отделяет выигрыш генератора от скорости синтеза звука и позволяет сравнить CoSTA с исходной Step-Audio 2 mini при одинаковом формате на входе декодера.
Выигрыш сохранился на уровне всей системы. При максимальной проверенной параллельности средняя задержка китайского ответа сократилась с 15,56 до 9,49 секунды, а пропускная способность выросла с 0,515 до 0,820 запроса в секунду. Пиковое потребление памяти при этом осталось близким к исходному варианту.
Качество проверяли на китайских и английских заданиях URO-Bench: пересказе, рассуждениях, открытых диалогах и бытовых разговорах. Автоматические оценки охватывали содержание ответа, ошибки распознавания сгенерированной речи и качество звучания; отдельно провели прослушивание. CoSTA сохранила качество относительно исходной модели и обычной адаптации на тех же данных.
Основные опыты провели на Step-Audio 2 mini, а перенос подхода дополнительно проверили на архитектуре OpenS2S. Обучающие речевые диалоги были синтезированы, а испытания охватывали общие разговорные задачи на китайском и английском. Поэтому результаты описывают прежде всего модели с дискретными речевыми токенами, а не эмоциональную речь, персональные голоса или разные акустические условия.
Когда CoSTA меняет план разработки
Работа меняет план команды, если задержку создаёт именно последовательная генерация речевых токенов, а готовый токенизатор и декодер уже устраивают по качеству. Вместо их замены можно расширить словарь языковой части, провести две стадии адаптации и вставить обратимое разворачивание перед синтезатором. Интерфейс речевого декодера и формат сохранённых токенов менять не придётся.
Это особенно полезно для длинных ответов и диалогов с ограниченным бюджетом генерации. Составные единицы занимают меньше позиций в контексте, поэтому модель может продолжать разговор дольше до исчерпания лимита. Тот же приём можно сочетать с токенизатором, который изначально выпускает токены с меньшей частотой.
Максимально расширять словарь невыгодно. Более крупные составные единицы сильнее сокращают последовательность, но увеличивают выходной слой, замедляют выбор следующего токена и в какой-то момент ухудшают ответ. Команде придётся подбирать словарь под собственную модель, оборудование и профиль нагрузки, а не переносить конфигурацию из статьи без замеров.
Если основное время занимает синтез звука, передача аудио или внешние сервисы, ускорение языковой части даст меньший эффект. Практический тест должен отдельно измерять генерацию токенов и полную задержку ответа при рабочей параллельности. CoSTA ценна не как новый речевой стек, а как способ снять одно узкое место, сохранив уже внедрённые компоненты.
Источники
Иллюстрация: рисунок из статьи «CoSTA: Compressed Speech Token Adaptation for Efficient Spoken Dialogue Models», Yingzhuo Deng, Chong Li, Bingxin Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


