
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Одну модель научили попеременно писать решения и тесты так, чтобы тесты не получали награду за бессмысленную уступчивость. В нерецензированном препринте, где числа получили сами авторы, CoVer на базе Qwen2.5-14B-Instruct повысил долю задач, решённых с первой попытки, на 7,1 процентного пункта. Для собственного дообучения генератора кода это даёт альтернативу фиксированным наборам тестов и отдельной модели-проверяющему.
Как тест получает награду за информацию, а не за пропущенный код
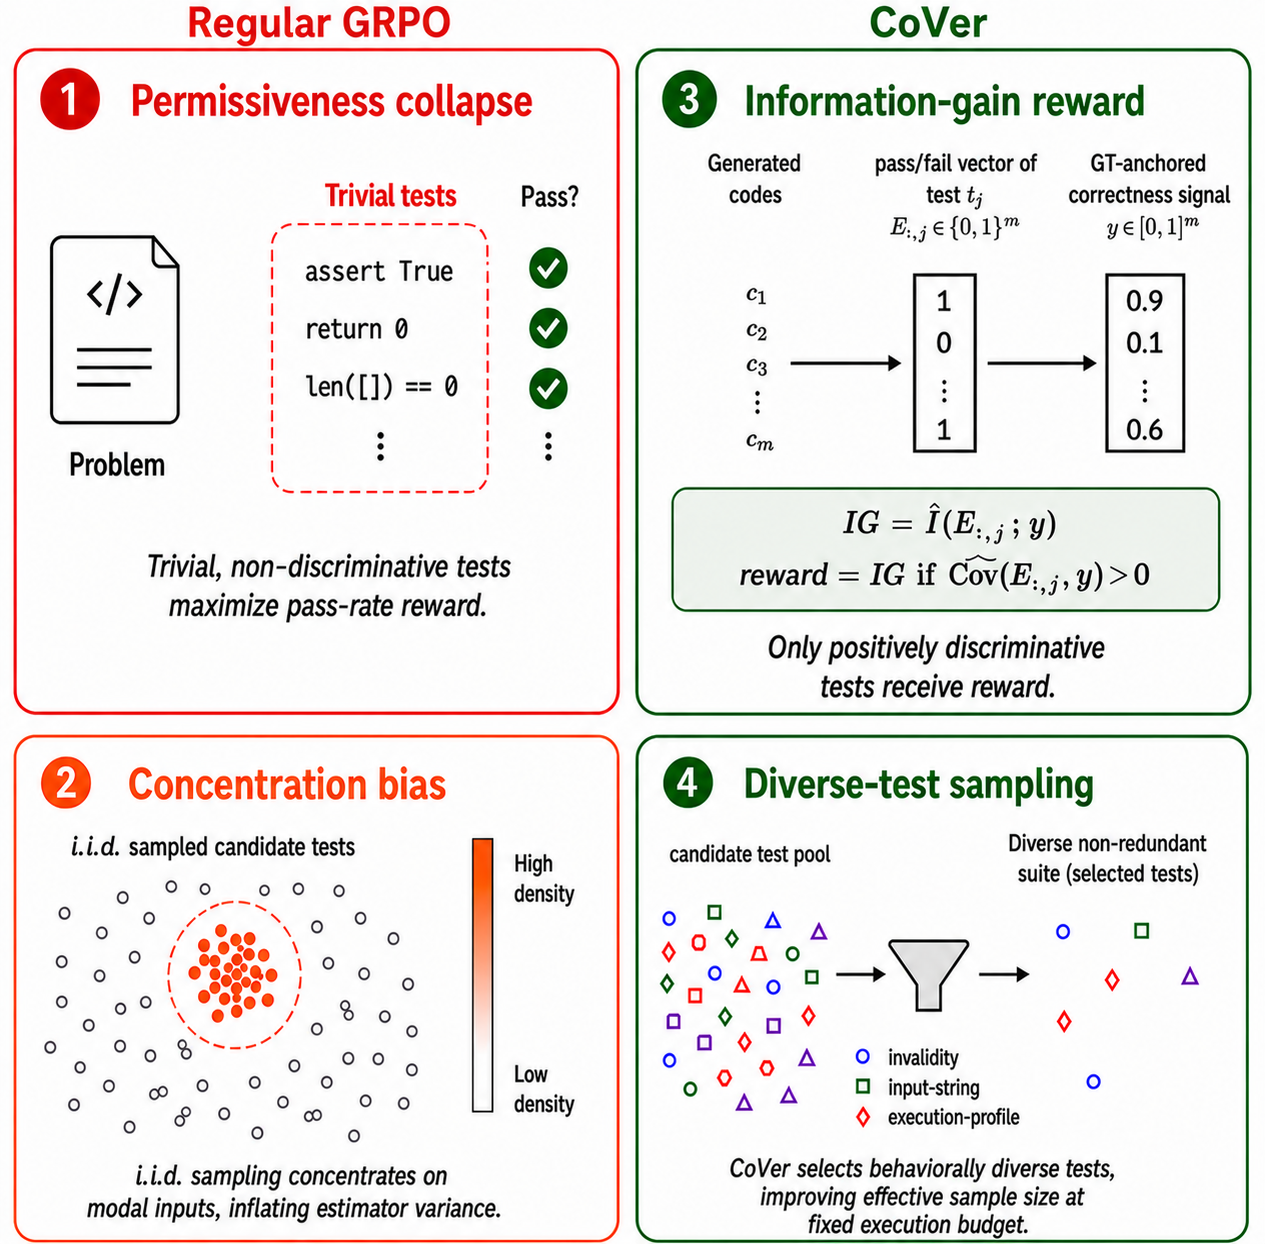
При самообучении через игру с собой (self-play) модель выступает в двух ролях: пишет несколько решений задачи и придумывает для них тесты. Обычная награда за долю пройденных проверок создаёт неверный стимул. Тест, который принимает любой код, легко набирает максимум, хотя ничего не говорит о корректности решений.
CoVer сначала запускает каждое решение на эталонных тестах из обучающего набора. Модель получает не только итог «верно» или «неверно», а долю пройденных проверок. Поэтому частично правильные программы отличаются друг от друга даже в начале обучения, когда ни одна ещё не решила задачу полностью.
Затем каждый сгенерированный тест применяют ко всем вариантам кода. Получается столбец ответов «пройден» и «не пройден», который сопоставляют с оценками частичной корректности. Наградой служит взаимная информация: она показывает, насколько исход теста помогает предсказать реальное качество программы.
Одной статистической связи недостаточно. Если слабые решения проходят тест чаще сильных, CoVer обнуляет награду. То же происходит с тестом, который пропускает все программы или отклоняет их все: постоянный ответ не уменьшает неопределённость и потому не приносит награды.
Обе роли обновляют одни и те же параметры через GRPO — метод обучения с подкреплением, который сравнивает ответы внутри группы без отдельной модели критика. Код получает награду за долю пройденных эталонных тестов, а проверяющий — за способность отличать более правильные решения от менее правильных.
Почему 16 разных тестов полезнее 32 похожих
Тесты одной модели часто концентрируются вокруг похожих входных данных. Формулировки могут отличаться, но наборы программ проходят и проваливают их одинаково. Такие проверки многократно усиливают один сигнал и создают впечатление, что наблюдений больше, чем фактически независимых вариантов поведения.
CoVer фильтрует тесты по трём признакам. Сначала удаляет проверки, которые нельзя выполнить, затем объединяет варианты с одинаковым нормализованным вводом и наконец убирает тесты с одинаковым профилем исполнения — тем же распределением успешных и неуспешных запусков по кандидатам.
В основном эксперименте для задачи генерировали 16 решений и 32 теста, а для расчёта награды оставляли 16 неповторяющихся проверок. Все пары кода и тестов всё равно исполняли, поэтому отбор не сокращал предварительные запуски. Он очищал статистический сигнал при том же бюджете исполнения.
Этот результат выглядит контринтуитивно: использование всех сгенерированных тестов оказалось хуже отфильтрованного подмножества. Отбор по разнообразию прибавил 1,67 процентного пункта к средней точности относительно варианта, который рассчитывал награду по всему набору.
Когда схема меняет план разработки
CoVer касается команд, которые сами дообучают модель для генерации кода и располагают задачами с эталонными тестами. Вместо отдельного проверяющего можно обучать одну модель в двух ролях, а вместо награды за долю принятых решений — оценивать, помогает ли тест различать качество программ. Для продукта, который только вызывает готовую модель через API, схема не добавляет нового этапа.
Эталонные тесты при обучении остаются обязательными: через них CoVer получает устойчивую оценку частичной корректности. Метод также предполагает детерминированное исполнение в изолированной среде. Сценарии с интерфейсами, распределёнными системами и случайными побочными эффектами в проверку не входили.
Основные замеры провели на Qwen2.5-Instruct двух размеров. Обучение шло на части CodeContests, а итоговую точность проверяли на LiveBench, MBPP, LiveCodeBench, CodeContests и CodeForces. CoVer получил лучшую среднюю долю решений с первой попытки среди сравниваемых методов в обоих масштабах, но эти результаты пока показывают перенос внутри ограниченного набора моделей и задач.
Схема пригодилась и при ранжировании нескольких решений. Когда CoVer-7B подставили в CodeT, средний результат вырос ещё на 3,5 процентного пункта относительно CodeT с исходной Qwen2.5-7B-Instruct. Значит, совместное обучение улучшило не только первый ответ модели, но и тесты, которыми выбирают один вариант из нескольких.
Работа меняет прежде всего устройство обучающего контура: тест следует вознаграждать за новую информацию о корректности, а не за количество принятых программ. При этом рост результата на задачах не превращает модель в формальный верификатор, поэтому сгенерированный код по-прежнему требует независимых проверок перед эксплуатацией.
Источники
Иллюстрация: рисунок из статьи «Information-Gain Rewards over Diversity-Pruned Tests: GT-Anchored Verifier Co-Training for Reliable Code Generation», Ana Nunez, Peyman Najafirad, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


