
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM-агента научили точнее распределять итоговую награду между действиями в длинной задаче, повторно используя уже собранные прогоны. Хотя препринт пяти китайских организаций не рецензирован и числа в нём получили сами авторы, на ALFWorld метод CRBC обошёл сильнейший из проверенных вариантов на 5,59 процентного пункта. Для внедрения не нужны дополнительные обращения к среде или отдельная модель ценности.
Общие состояния связывают независимые прогоны
Методы группового обучения с подкреплением, включая GRPO, запускают агента несколько раз на одной задаче и сравнивают итоговые результаты. Если один прогон закончился успехом, все его действия получают положительную оценку. Такая оценка не различает шаг, который приблизил решение, и случайное действие, после которого агент всё же справился.
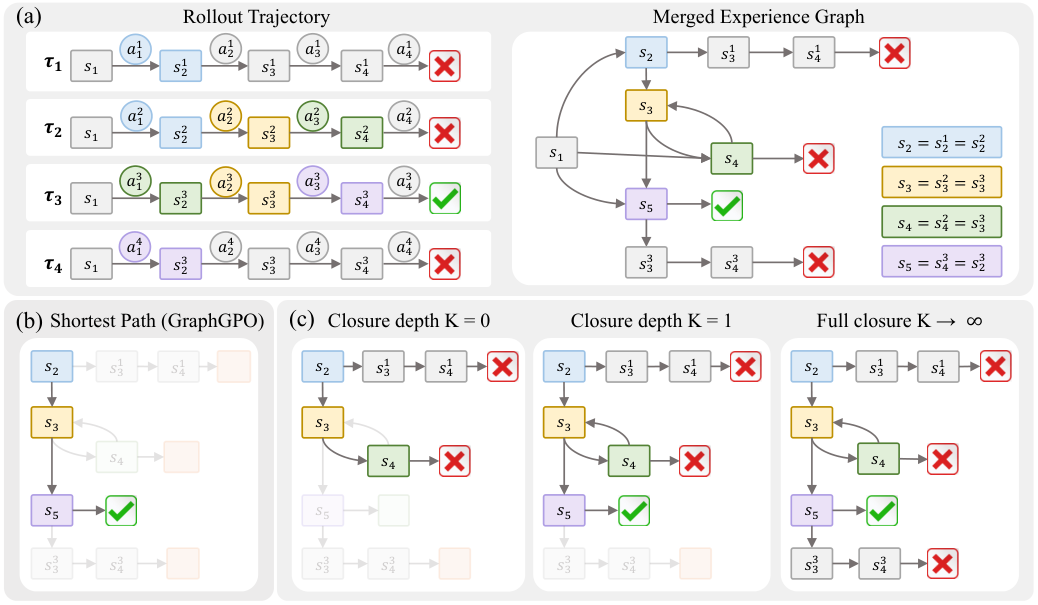
Длинные прогоны часто пересекаются в одинаковых промежуточных состояниях. В ALFWorld таким состоянием может быть одно и то же положение объектов, а в WebShop — одинаковое состояние магазина. Эти точки авторы называют якорями: от одного якоря разные прогоны могут перейти к успеху или неудаче разными путями.
Простое усреднение учитывает исходы продолжений, которые действительно встретились после якоря, но не переносит сведения через следующие общие состояния. Оценка по кратчайшему пути переносит их дальше, однако редкий удачный маршрут способен перевесить множество неудачных. CRBC совмещает дальнее распространение награды с частотами, которые наблюдались в прогонах.
Для этого метод объединяет группу прогонов в конечный процесс. Узлами становятся якоря, переходами — выполненные действия, а завершения задачи превращаются в конечные состояния успеха и неудачи. Вероятность действия или перехода равна его частоте в собранной группе; невстречавшиеся варианты в процесс не входят.
Затем CRBC одним решением системы линейных уравнений находит фиксированную точку Беллмана. Ценность якоря показывает приведённую с учётом длины пути вероятность успеха, если следовать поведению из собранных прогонов. Ценность действия получают из ценностей следующих состояний, а разность между ценностью действия и якоря становится шаговой оценкой.
Эту оценку нормализуют и складывают с обычной оценкой всего прогона. Поэтому CRBC не заменяет групповой оптимизатор: он меняет способ, которым тот распределяет итоговый сигнал между отдельными решениями агента.
Полное распространение награды улучшило три среды
На ALFWorld с Qwen2.5 CRBC достиг доли успешных задач 96,09%. Это на 5,59 процентного пункта выше HGPO, сильнейшего результата среди выбранных для сравнения методов.
На WebShop метод показал лучшую среди проверенных вариантов долю успеха — 81,51%. На визуальном Sokoban результат составил 82,81%, что на 5,21 пункта выше GraphGPO. В ALFWorld CRBC также дошёл до итогового качества GraphGPO примерно за вдвое меньше обновлений.
Проверка глубины распространения отделяет эффект полного замыкания от простого усреднения в общей точке. Чем дальше ценность проходила по объединённому процессу, тем больше прогонов влияло на оценку ранних действий; полная фиксированная точка дала лучший итоговый результат.
Эксперименты охватывают текстовые ALFWorld и WebShop на нескольких масштабах Qwen2.5, а также визуальный Sokoban с Qwen2.5-VL. Во всех задачах агент получал двоичный сигнал об успехе в конце прогона, а состояния сопоставлялись внутри группы одной задачи. Теоретическая гарантия тоже относится к этому конечному процессу, построенному из наблюдавшихся переходов, а не ко всем возможным состояниям среды.
Менять модель не требуется, но нужны устойчивые якоря
Работа не даёт причины менять базовую LLM или весь контур обучения. CRBC можно рассматривать как замену модуля, который рассчитывает преимущество каждого шага после сбора группы прогонов. Он использует те же ответы модели, переходы среды и итоговые награды.
В профильном замере полный расчёт преимуществ занял 0,18% времени обновления. Основные расходы по-прежнему пришлись на выполнение прогонов и обновление политики, поэтому линейное решение не стало заметной частью цикла обучения.
Метод подходит прежде всего агентам с длинными сценариями, редкой итоговой наградой и повторяющимися состояниями. Команде придётся определить функцию, которая считает два состояния одним якорем. Если она объединит разные ситуации, награда пойдёт по неверным переходам; если будет слишком строгой, прогоны почти не поделятся сведениями.
Практический пилот можно провести на уже существующем пакете групповых прогонов: построить граф якорей, рассчитать шаговые оценки CRBC и сравнить обучение с текущим GRPO или локальным усреднением при одинаковом числе обращений к среде. Работа показывает, что улучшение связано именно с полным распространением по наблюдавшимся переходам, а не с дополнительными данными или отдельным критиком.
Источники
Иллюстрация: рисунок из статьи «Cross-Rollout Bellman Closure for Long-Horizon Agentic Reinforcement Learning», Yangyang Ren, Haodong Zhu, Linlin Yang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


