
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
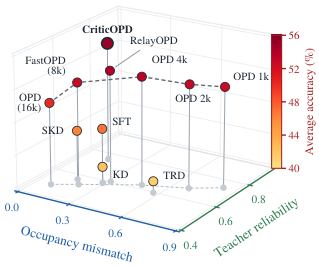
Учителя LLM научили направлять ученика после ошибочного рассуждения, даже когда обычное продолжение лишь закрепляет ошибку. В работе Brigham Young University и University of North Carolina at Chapel Hill метод CriticOPD обошёл обычную дистилляцию на собственных ответах на обеих версиях Qwen3; это препринт, который не прошёл рецензирование, а числа получили сами авторы. Метод может изменить этап дообучения моделей для задач, где правильный ответ можно проверить автоматически.
Почему учитель продолжает ошибку ученика
Дистилляция на собственных ответах (on-policy distillation) устроена так: ученик генерирует решение, а более крупный учитель задаёт для каждого его фрагмента распределение вероятностей следующего токена. Это сокращает разрыв между обучением и использованием модели: ученик тренируется на тех состояниях, в которые сам попадает.
Метод опирается на скрытое предположение: учитель способен продолжить решение правильно из любого фрагмента, написанного учеником. Авторы называют это восстанавливаемостью. Если ученик уже допустил логическую ошибку, предположение перестаёт работать.
На ошибочных решениях, где учитель изначально знал ответ, его вероятность закончить решение правильно падала с 0,82 до 0,29 по мере роста ошибочного контекста. На корректных решениях такого падения не было. Значит, дело не только в длине текста или сложности задачи: учитель подстраивается под неверную логику, которую видит перед собой.
При этом способность найти ошибку сохранялась. Учитель мог неверно продолжить рассуждение, но всё ещё достаточно точно указывал проблемную фразу и предлагал исправление. CriticOPD использует именно этот разрыв между слабым продолжением и более надёжной критикой.
Как критика возвращает полезный сигнал
Для правильных решений CriticOPD работает как обычная дистилляция. Если ответ неверен или закончился без результата, учитель получает условие, эталонный ответ и решение ученика, разбитое на абзацы. Он перечисляет ошибки, цитирует проблемные места и кратко описывает исправления.
Ученик сохраняет решение до абзаца с последней найденной ошибкой, отбрасывает последующий текст и пишет новый финал, видя критику. Все токены новой обучающей последовательности по-прежнему генерирует ученик: учитель не перехватывает ответ и не вставляет в него собственное решение.
Затем роли контекста расходятся. Учитель оценивает переписанный фрагмент вместе с критикой, поэтому лучше отличает исправление от продолжения ошибки. Ученик обучается на том же фрагменте без критики. Во время обычного использования ему не нужны ни обратная связь, ни дополнительный диалог.
После такого переписывания вероятность правильного продолжения со стороны учителя выросла почти впятеро относительно исходной ошибочной траектории. Сигнал остаётся близок к состояниям, которые создаёт сам ученик, поэтому метод не заменяет его ответы последовательностями, написанными другой моделью.
Когда CriticOPD меняет план обучения
Основные эксперименты охватили Qwen3-0.6B и Qwen3-1.7B в режиме без скрытого рассуждения, которых обучали с помощью Qwen3-4B-Instruct-2507. Для обучения использовали математические задачи DAPO-Math-17k, а качество проверяли на наборах с олимпиадной математикой и другими задачами на вычисляемый ответ.
На крупном ученике CriticOPD прибавил к средней точности обычного OPD 4,57 процентного пункта, на малом — 4,06 пункта. Наибольшая разница возникла в конкурсных задачах, где длинная цепочка рассуждений даёт больше возможностей уйти по неверной ветке. Метод также опередил варианты, которые обрезают поздние части ответа или позволяют учителю переписывать траекторию.
Цена улучшения — дополнительная генерация учителя и ученика для каждого ошибочного решения. Однако выбранная контрольная точка CriticOPD потребовала 42% вычислений от полного обучения OPD в использованном рецепте, поскольку модель достигла лучшего результата раньше.
Работа меняет план прежде всего для команд, которые дообучают собственную модель на математике или другой задаче с проверяемым итогом. Вместо удаления плохих ответов или полной замены их ответами учителя можно сохранить ошибочное состояние ученика и обучить восстановлению после него.
Методу нужен эталонный ответ, чтобы решить, когда запускать критику, и привязать её к правильному результату. Для кода эту роль потенциально могут выполнять модульные тесты, но обучение на коде в работе не проверяли. Для открытых диалоговых задач потребуется отдельная модель оценки или критик, способный самостоятельно определять корректность.
Источники
Иллюстрация: рисунок из статьи «Recovering Reliable Supervision via Critique-Guided On-Policy Distillation», Kaixiang Zhao, Tianrun Yu, Shangzhe Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


