
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM научили исправлять вероятные недостатки ответа до того, как их укажет пользователь. В нерецензированном препринте Fanzhi Zeng, Anubrata Das, Maytal Saar-Tsechansky и Liu Leqi, где числа получили сами авторы, CToM повысил итоговую точность на математических задачах с 74,1% до 79,6%. Для продуктовых команд это кандидат на отдельный этап обучения агента, а не приём, который достаточно добавить в системную инструкцию.
Черновик проходит мысленную проверку пользователем
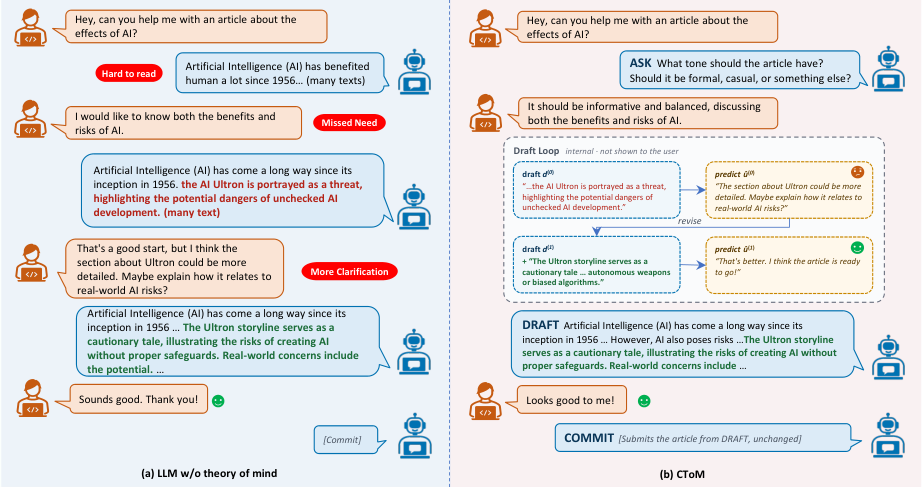
CToM работает с тремя действиями: задать уточняющий вопрос, подготовить ответ или завершить задачу. Если модель выбирает ответ, она сначала создаёт скрытый черновик, предсказывает следующую реплику пользователя и проверяет, выражает ли эта реплика удовлетворение результатом.
Предсказанное замечание запускает ещё одну редакцию. Пользователь видит только последний вариант, когда модель ожидает положительную реакцию или исчерпывает разрешённое число внутренних попыток. Если для решения не хватает информации, модель может не угадывать предпочтения, а запросить их напрямую.
Во время обучения показанный черновик получает в качестве цели реальную реплику симулятора пользователя. Для отброшенных вариантов симулятор отдельно генерирует ответы, которые дал бы на них. Так модель учится не просто критиковать собственный текст, а воспроизводить реакцию конкретного собеседника с его скрытыми требованиями.
Этот сигнал объединили с групповой относительной оптимизацией политики (GRPO). Она поощряет успешное решение задачи и штрафует диалог за усилия пользователя: дополнительные реплики и длину видимых сообщений. Внутренние черновики в эту метрику не входят, хотя модель всё равно генерирует их при работе.
При запуске симулятор уже не нужен. Агент сам предсказывает реакцию, редактирует ответ и только затем отправляет его. Дополнительные запросы к симулятору и альтернативные ответы нужны на этапе обучения.
Предсказание реакции улучшило результат и сократило переписку
Метод проверяли на решении задач из MATH, генерации кода из BigCodeBench и подготовке документов. Во всех опытах помощником служил Qwen3-8B, а пользователя с доступом к скрытым требованиям изображал Qwen3-32B-FP8. Результат оценивал отдельный для каждого типа задач проверяющий механизм.
По сравнению с лучшим вариантом из сопоставленных методов CToM повысил оценку на математике на 7,5%, на коде — на 4,4%, на письме — на 6,5%. Сравнение вариантов обучения показывает, что эффект дал не только штраф за длинный диалог: добавление обучения на предсказаниях улучшало итоговую задачу при одинаковой функции награды.
Пользователь также реже исправлял агента. Предсказание следующей реплики сократило число ответов пользователя на 8% в задачах с кодом и на 17% при подготовке документов. На математике варианты с обучением предсказанию и штрафом за усилия пользователя показали близкие затраты на диалог.
Поведенческие проверки связывают результат именно со скрытой редактурой. После обучения предсказанные реплики точнее совпадали с ответами симулятора, а черновики после внутреннего пересмотра получали более высокую оценку. Принудительное увеличение числа уточняющих вопросов, напротив, снижало результат во всех трёх областях: полезно не спрашивать чаще, а выбирать между вопросом и самостоятельным исправлением.
Метод меняет план обучения, но не выбор модели
CToM не предлагает новую базовую модель или готовую оболочку вокруг API. Он меняет этап дообучения: команде нужен симулятор пользователя, который знает скрытые требования, умеет отвечать на неотправленные черновики и поддерживает многоходовой диалог. Нужен и проверяющий механизм, который оценивает не отдельную реплику, а завершённую задачу вместе с затратами пользователя.
Такой подход ближе всего к агентам для повторяемых процессов: подготовке документов, работе с кодом и задачам, где требования раскрываются по ходу общения. В этих сценариях в план эксперимента стоит добавить две отдельные метрики: качество конечного результата и объём исправлений, который агент переложил на человека. Обычная точность одного ответа этого различия не показывает.
Архитектура агента тоже должна допускать закрытый цикл черновиков. Если продукт сейчас отправляет пользователю первый сгенерированный ответ, CToM даёт основание проверить промежуточную редактуру и сравнить выигрыш с дополнительными вычислениями. Работа измеряет видимые сообщения и усилия пользователя, поэтому сама по себе не отвечает, окупятся ли скрытые генерации при заданных требованиях к задержке.
Все эксперименты проходили с симулятором, которому заранее были доступны цели и ограничения задачи. Проверка с реальными людьми обозначена следующим этапом: именно она должна показать, может ли агент предсказывать менее последовательную обратную связь и сохранять выигрыш вне подготовленных наборов. Поэтому CToM пока меняет план исследований и внутренней оценки, но не даёт достаточных оснований перестраивать производственную систему вокруг этого метода.
Источники
Иллюстрация: рисунок из статьи «Collaborative Theory of Mind: Learning to Self-Revise by Anticipating User Responses», Fanzhi Zeng, Anubrata Das, Maytal Saar-Tsechansky и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


