
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модели, которые хорошо составляют запросы Cypher с готовой историей, заметно хуже справляются, когда сами ведут диалог, управляют контекстом и исправляют ошибки. Работа Peking University и Baidu показывает, что в автономном режиме меняется даже лидер рейтинга, хотя препринт не рецензировали, а числа получили сами авторы. Для выбора модели одиночного тестового запроса теперь недостаточно.
Готовый контекст скрывает каскад ошибок
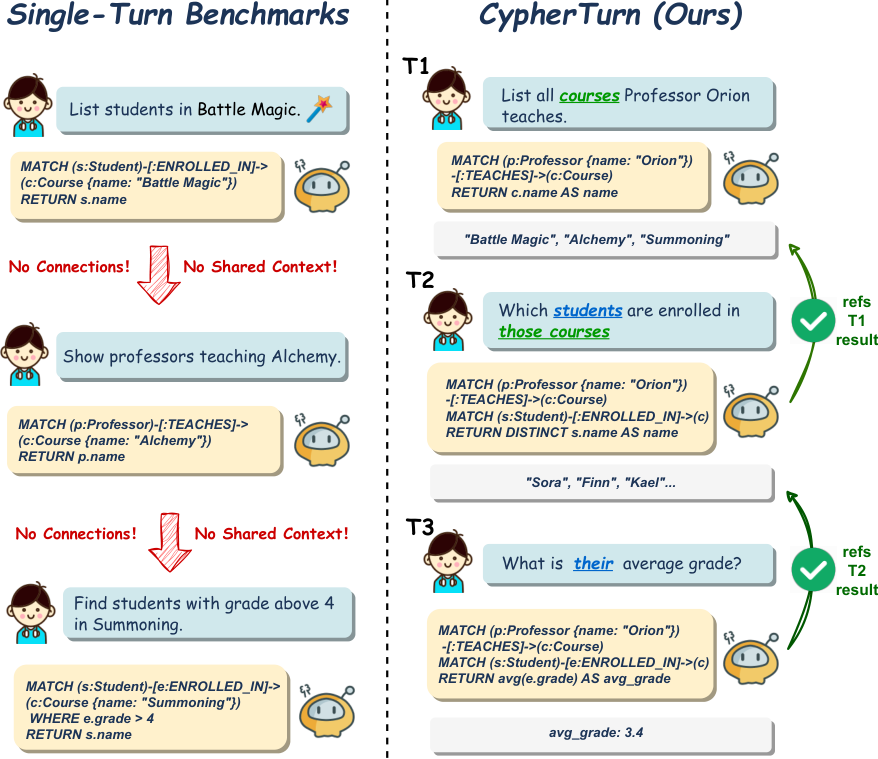
CypherTurn проверяет не отдельные вопросы, а связанные сессии. Пользователь может сначала запросить подразделения с наибольшим штатом, затем спросить об их проектах, а после — о клиентах этих проектов. Модель должна понять, к каким результатам относятся слова «их» и «этих», и перенести правильный набор сущностей в следующий запрос.
В тест вошла 721 сессия на семи синтетических графах. Авторы проверили 15 моделей, включая доступные через API системы, небольшие открытые модели и специализированные архитектуры.
Первый режим отделяет генерацию Cypher от управления диалогом. Модель получает схему графа, правильную историю предыдущих запросов и результаты их выполнения. Ошибка на прошлом ходе поэтому не портит следующий.
В автономном режиме модель сама запрашивает схему, ищет значения, выполняет Cypher, задаёт уточняющие вопросы и сохраняет собственную историю. Если она выбрала не те узлы, следующий вопрос уже опирается на неверный результат. Так локальная ошибка превращается в сбой всей цепочки.
Основная метрика требует, чтобы запрос вернул те же строки и названия столбцов, что эталон. Дополнительно авторы проверяют, прошла ли модель по правильной части графа, как часто ошибка повторяется на следующем ходе и завершилась ли без ошибок вся сессия.
Границы теста существенны: все графы синтетические, а диалоги идут на английском. Строгое сравнение результатов может отклонить семантически верный запрос из-за оформления столбцов. Поэтому CypherTurn измеряет работу с контролируемыми зависимостями, но не предсказывает точность на корпоративной базе с её именами полей, неполными данными и неоднозначными формулировками.
Автономный режим переставляет модели в рейтинге
С готовой историей лучший результат показал Claude Opus 4.7: он правильно выполнил 64,7% ходов. При этом полностью правильными оставались менее 5% сессий. Даже сильная генерация отдельных запросов редко выдерживает длинную последовательность без единого сбоя.
В автономном режиме первое место занял Gemini-3.1-Flash-Lite с точностью 43,2%. Claude Opus 4.7 получил 40,2%, хотя лидировал с готовым контекстом. Qwen3-235B опустился до 19,9%, то есть способность писать Cypher и способность управлять собственными ошибками оказались разными качествами.
Общий порядок моделей сохранялся лучше, чем верхушка рейтинга. Авторы изменяли доступность схемы, заранее сообщали длину сессии и переписывали подсказку так, чтобы поощрить использование доступных действий. Разрыв между готовым контекстом и автономной работой сохранялся, но конкретный лидер менялся. Поэтому первое место Gemini нельзя переносить в продукт без проверки собственного протокола агента.
Больше действий само по себе проблему не решило. Даже при бюджете, увеличенном до ×10, сильные модели обычно ограничивались примерно двумя действиями на ход. Они не тратили доступный ресурс на дополнительную проверку, поэтому увеличение лимита не заменяло стратегию восстановления после ошибки.
Командам нужен тест всей сессии, а не только модели
CypherTurn меняет план выбора модели для интерфейса к графовой базе. Сравнивать следует тот режим, который попадёт в продукт: с теми же инструментами, способом передачи схемы, историей результатов и правилами повторного запроса. Рейтинг по одиночным вопросам или по эталонному контексту подходит только для предварительного отбора.
Отдельно стоит измерять восстановление. Полезный испытательный набор должен содержать диалоги, где неверный запрос появляется в середине цепочки, а система получает возможность проверить схему, пересобрать контекст или вернуться к подтверждённому результату. Средняя точность по ходам не покажет, насколько часто одна ошибка уничтожает остаток сессии.
Работа также предостерегает от узкой настройки на одиночные пары «вопрос — Cypher». Такая настройка ухудшила следование многошаговым инструкциям: модель подставляла конкретные значения из предыдущих результатов и теряла направление связей. При этом специализация, согласованная с архитектурой модели, обошла несколько универсальных систем. Проблема не в специализации как таковой, а в том, соответствует ли обучение будущему режиму работы.
Практический вывод для архитектуры — не поручать модели одновременно генерировать запрос, хранить единственное состояние диалога и без внешней проверки решать, восстановилась ли она после сбоя. Подтверждённые результаты, схема и границы текущего набора сущностей должны оставаться доступными системе отдельно от свободного текста истории. Но и постоянная передача схемы не закрывает разрыв целиком: итог всё равно нужно проверять на собственных графах и реальных пользовательских цепочках.
Источники
Иллюстрация: рисунок из статьи «CypherTurn: A Multi-Turn Benchmark for Conversational Text-to-Cypher Evaluation and the Autonomy Divergence», Yuzhe Zhang, Weijie Zhu, Haolin Yang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


