
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
D3D научили готовить следующие блоки текста, пока основная модель проверяет текущий. В препринте, который не проходил рецензирование и все замеры для которого выполнили сами авторы, среднее ускорение достигло 5,71 раза относительно обычной генерации. Подход меняет план оптимизации вывода: задержку черновой модели теперь можно скрыть за проверкой, а не только сокращать.
Почему черновик больше не ждёт целевую модель
При обычной генерации LLM добавляет токены последовательно. Спекулятивное декодирование поручает небольшой черновой модели предложить сразу несколько токенов, а целевая модель проверяет их за один проход. Правило проверки сохраняет распределение ответов целевой модели, поэтому ускорение не требует менять результат ради скорости.
Параллельные черновые модели вроде DFlash предсказывают целый блок за один проход, но используют свежие внутренние состояния целевой модели — промежуточные представления текущего контекста. Следующий черновик нельзя начать, пока целевая модель не закончила проверку и не подготовила эти состояния. Генерация блока стала параллельной внутри себя, но раунды остались последовательными.
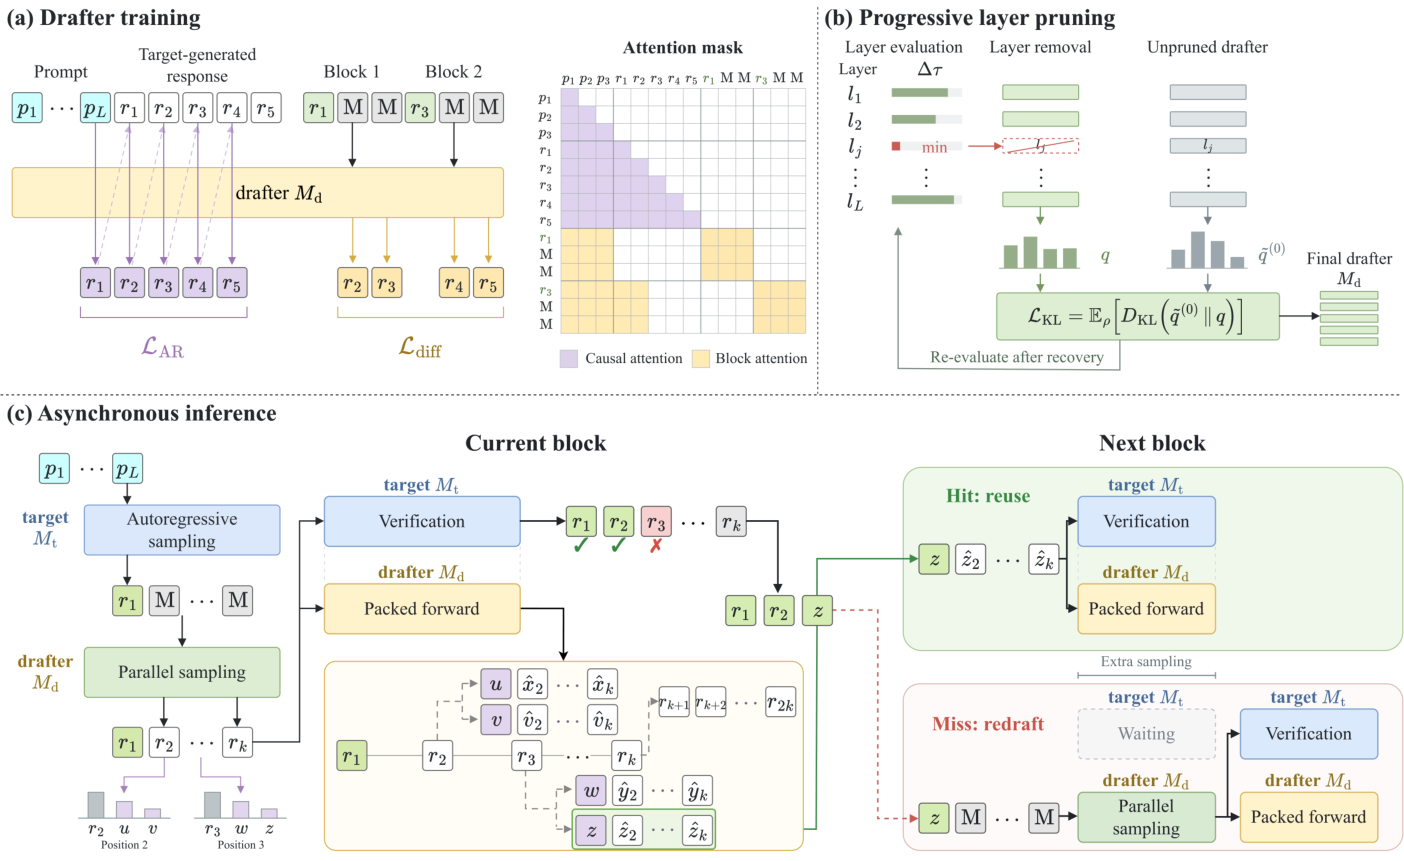
D3D убирает эту зависимость. Черновая модель сама кодирует уже подтверждённый префикс и не получает внутренних состояний Qwen. Пока Qwen проверяет текущий блок, D3D рассчитывает продолжения для нескольких возможных исходов: отказа на разных позициях и принятия блока целиком.
Все варианты объединяются в один пакет и проходят через черновую модель одновременно. После проверки система выбирает ветвь, чей префикс совпал с фактическим результатом, и использует уже готовое продолжение. Если совпадения нет, D3D строит новый блок синхронно, и целевая модель ждёт.
Как обучили самостоятельный черновик
Основой D3D служит предварительно обученная авторегрессионная модель. Для обучения целевая модель сначала генерирует ответы, затем в нескольких местах ответа будущие токены заменяют масками. D3D видит подтверждённый префикс и восстанавливает весь замаскированный блок за один проход.
Ошибки в начале блока обходятся дороже: проверка останавливается на первом отклонённом токене. Поэтому ранние позиции получают больший вес. К этому добавили обычную задачу предсказания следующего токена по незамаскированному префиксу, чтобы модель не потеряла способность самостоятельно представлять контекст.
После обучения авторы сокращают глубину D3D. Они поочерёдно убирают каждый оставшийся слой, измеряют, насколько сократилась принятая часть черновика, и окончательно удаляют наименее полезный. Затем модель дообучают по исходной полной версии и повторно оценивают слои, поскольку после восстановления их вклад меняется.
Удаление пяти слоёв из 36 сохранило более 99% средней длины принятого продолжения. Дальнейшее сокращение уже уменьшало и длину принятой части, и итоговое ускорение: более дешёвый черновик начинал слишком часто ошибаться.
Меняет ли D3D планы внедрения
На семи задачах по математике, программированию и открытому диалогу D3D ускорил декодирование в среднем в 5,00 раза с Qwen3-8B и в 5,71 раза с Qwen3-32B. У DFlash в тех же сравнениях получилось 4,03 и 3,67 раза соответственно. Разрыв вырос на более крупной целевой модели, проверка которой оставляет больше времени для скрытой подготовки черновика.
Работа предлагает командам новый порядок оптимизации. Раньше самостоятельный черновик обычно означал компромисс: он не ждёт целевую модель, но хуже угадывает её продолжение. D3D показывает, что обучение на ответах цели, отдельная авторегрессионная задача и отбор слоёв по длине принятого префикса могут сохранить достаточно точный черновик без доступа к её активациям.
Результат стоит проверять прежде всего в системах, где важна задержка одного запроса и для черновой модели можно выделить отдельную GPU. В экспериментах целевая и черновая модели работали на разных GPU, а реализация использовала Transformers. При росте числа одновременных запросов абсолютная пропускная способность увеличивалась, но относительное ускорение снижалось.
Для сервиса, который оптимизируют по токенам на GPU, работа пока не доказывает экономическую выгоду. D3D не сравнивали с использованием того же аппаратного бюджета для параллельного запуска самой целевой модели, а производственные планировщики SGLang и vLLM не входили в проверку. Поэтому D3D меняет направление прототипа, но не даёт готовой конфигурации для высоконагруженного вывода.
Источники
Иллюстрация: рисунок из статьи «D3D: Decoupled Diffusion Drafting for Asynchronous Speculative Decoding», Baoyou Chen, Ruiqiao Mei, Guancong Lin и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


