
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
У внутренних признаков языковой модели научились отдельно определять условия активации, влияние на ответ и связь между ними. Dewen Liu и коллеги представили DAFI: система обошла прежние методы по оценке входа на 13,1 процентного пункта, а по оценке выхода — на 38,9 пункта, хотя препринт не рецензирован и все числа получили сами авторы. Такой подход позволяет проверять не только ярлык признака, но и его фактическую роль во время генерации.
Три описания вместо одного ярлыка
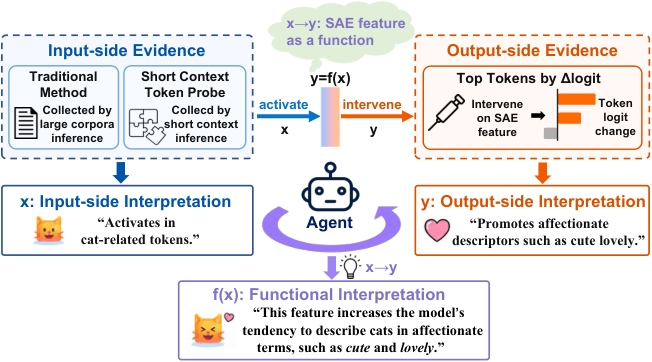
Разреженный автоэнкодер (SAE) раскладывает внутренние активации модели на множество признаков. Исследователь затем пытается описать каждый признак по примерам, на которых тот активируется, или по изменениям в ответе после искусственного усиления.
Эти стороны могут не совпадать. Признак активируется на словах о кошках, но при усилении повышает предпочтение слов вроде cute и lovely. Назвать его «признаком кошек» недостаточно: такое описание не показывает, что он связывает кошек с ласковыми характеристиками.
DAFI поэтому поддерживает три гипотезы. Входная описывает, какие смыслы активируют признак. Выходная фиксирует, какие токены модель начинает предпочитать или подавлять после вмешательства. Функциональная объясняет переход между ними: какую роль признак играет в контексте, где сработал.
Каждую часть проверяют отдельно. Для входа система создаёт положительные и близкие по смыслу отрицательные примеры, а оценка штрафует гипотезу, которая хорошо покрывает активации, но не проводит смысловую границу. Для выхода модель-оценщик сопоставляет описание с токенами, усиленными и подавленными вмешательством. Функциональная оценка проверяет, подтверждают ли наблюдения заявленную связь между входом и выходом.
После диагностики агент меняет только провалившуюся часть, выбирает новое наблюдение и повторяет проверку. Успешные исправления он сохраняет как приёмы: например, как подобрать контекст, позицию вмешательства или силу воздействия для похожего случая.
Короткие пробы находят расхождения между входом и выходом
Для исследования входа DAFI не обязательно заранее прогонять большой корпус. Агент подставляет токены словаря в короткие шаблоны, измеряет активацию и при необходимости меняет окружающий контекст. Такой режим подходит для точечного разбора выбранных признаков; при массовом анализе готовый корпусный прогон по-прежнему можно распределить между многими признаками.
Расхождение оказалось обычным случаем: у 70,7% признаков с надёжными описаниями обеих сторон входной и выходной смыслы не были эквивалентны. Работа делит связи на сохранение смысла, смысловой сдвиг и разрыв, при котором обе стороны описаны уверенно, но подтверждённой связи между ними нет.
Например, один признак реагировал на тему туризма, а вмешательство продвигало названия конкретных направлений — Malibu, Kauai и Puglia. Другой активировался на словах о прогрессе, но усиливал формы британского английского вроде whilst и enquiry. В первом случае функциональная гипотеза описывает переход от общей темы к направлениям, во втором должна прямо зафиксировать отсутствие установленной смысловой связи.
Повторное использование накопленных приёмов подняло долю ранее не показанных признаков, для которых одновременно прошли все три проверки, с 58% до 92%. На AxBench отбор признаков по двойной интерпретации также улучшил площадь под кривой качества и охвата на 30,5% относительно фильтра, который смотрит только на выходную оценку.
Основной эксперимент охватывал 250 признаков GemmaScope для Gemma-2-2B. С отдельными методами сравнивали соответствующие части DAFI: входную — с SAGE, выходную — с Token Change; перенос накопленных приёмов проверяли на Qwen-Scope для Qwen3-1.7B-Base. Выходные и функциональные оценки в основном выставляла DeepSeek-V4-Pro, после чего часть результатов повторно проверили через GPT-5.6-Sol и оценки двух исследователей.
Когда работу стоит учитывать в планах
Для команд, которые строят инструменты интерпретации SAE, работа меняет структуру результата. Вместо одного текстового ярлыка полезно хранить три проверяемых объекта: условия активации, последствия вмешательства и связь между ними. Иначе интерфейс может показывать понятное название признака, которое описывает только одну сторону его поведения.
DAFI особенно уместен при точечном анализе: поиске признаков для управления генерацией, разборе конкретного сбоя или исследовании выбранного слоя. Короткие пробы позволяют собирать свидетельства по запросу, а агентный цикл направляет вычисления на гипотезу, которая не прошла проверку, вместо полного повторения анализа.
Для массовой каталогизации всех признаков выбор менее однозначен. Корпусный прогон требует крупных начальных затрат, но его результаты переиспользуются, тогда как DAFI исследует каждый целевой признак в несколько шагов. Архитектуре такого сервиса нужен смешанный режим: готовые корпусные примеры для широкого покрытия и активные пробы для спорных либо важных признаков.
Работа пока не превращает интерпретацию во внешний аудит безопасности. Качество измеряют внутри предложенной схемы, а часть критериев проверяют другие языковые модели. Результат для AxBench показывает более удачный выбор признаков при фиксированной процедуре управления, но не доказывает, что та же схема улучшит произвольное редактирование модели или поведение продукта целиком.
Источники
Иллюстрация: рисунок из статьи «From Input to Output: A Flexible Agent for Dual-End Interpretation of Sparse Autoencoder Features», Dewen Liu, Zixuan Li, Jonathan Pan и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


