
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
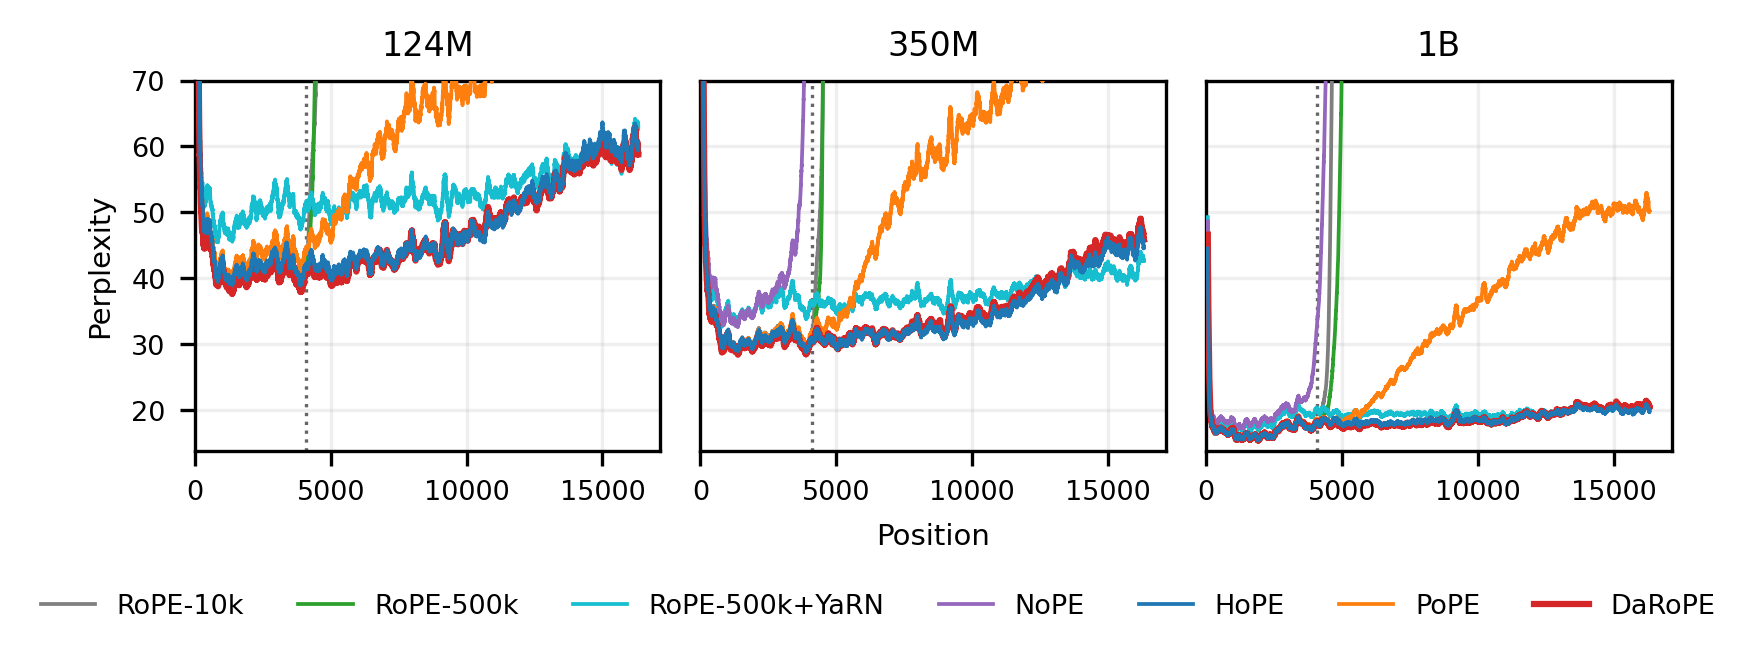
Трансформер научили связывать далёкие фрагменты по содержанию, не теряя порядок соседних токенов. Хотя работа Meta AI, Inria и Université Paris-Saclay не прошла рецензирование и все числа получили сами авторы, за пределами обучающего окна перплексия DaRoPE, где меньше — лучше, осталась около 19, а у RoPE-500k превысила 450. Для команд, которые обучают собственные модели с длинным контекстом, появился кандидат на замену стандартной позиционной схемы.
DaRoPE меняет только медленные частотные диапазоны
Трансформер сам по себе не знает, в каком порядке идут токены. Вращательное позиционное кодирование (Rotary Position Embedding), или RoPE, добавляет порядок через повороты векторов запросов и ключей на нескольких частотах.
Быстрые частотные диапазоны успевают пройти полный оборот внутри обучающего контекста и хорошо описывают локальный порядок. Медленные проходят только часть оборота. Когда последовательность становится длиннее обучающей, модель встречает углы, которых не видела при обучении, и начинает хуже использовать ранние фрагменты.
DaRoPE сохраняет обычный RoPE в быстрых диапазонах. В медленных абсолютную позицию заменяет ограниченная координата, которую каждая голова внимания вычисляет из контекстного представления токена. Поэтому два связанных фрагмента могут оказаться рядом в этой координате, даже если между ними находится большой объём текста.
Координата не отказывается от линейного порядка полностью: в неё входит обучаемая позиционная составляющая. Одна голова может сильнее опираться на место токена, другая — на его содержание. Ограниченный диапазон координат не даёт медленным частотам выйти в незнакомую область при увеличении длины контекста.
Изменение добавляет не более 0,3% параметров, сохраняет линейные по длине вычислительные затраты и совместимость с FlashAttention. В отличие от CoPE, DaRoPE не строит отдельную координату для каждой пары токенов и не требует хранить полную матрицу внимания только ради позиционного механизма.
Одинаковые условия отделили эффект кодирования от масштаба модели
Методы сравнивали при одинаковых архитектуре, данных, порядке примеров и бюджете обучения. Проверка охватила плотные языковые модели от 124 млн параметров до смеси экспертов на 50 млрд, а также синтетические задачи, символьную музыку, геномику и сигналы мозга. CoPE запускали только на малых синтетических задачах из-за квадратичных затрат памяти.
Внутри обучающего контекста DaRoPE и HoPE, который просто отключает медленные вращения, показали близкое качество. На LongBench преимущество DaRoPE составило 1,6 пункта и сосредоточилось в задачах, где ответ нужно собрать из нескольких удалённых частей документа. В коротких задачах и контролируемых проверках явного победителя между ними не было.
Та же картина появилась при дополнении кода на уровне репозитория: DaRoPE лучше использовал сведения из других файлов длинного контекста. Это не равномерное улучшение всех способностей модели, а более узкий эффект — модель увереннее объединяет разнесённые свидетельства.
На нетекстовых данных DaRoPE занял первое место на трёх из четырёх наборов и во всех случаях обошёл HoPE. Музыкальные фразы, геномные мотивы и ритмы сигналов повторяются на разном расстоянии, поэтому фиксированная близость токенов здесь особенно плохо отражает их связь. PoPE оказался лучшим на одном геномном наборе, но потребовал заметно больше времени на обучение.
Менять готовые модели рано, но новый проект стоит проверить с DaRoPE
Работа меняет выбор для команд, которые сами обучают базовую языковую модель или трансформер для музыки, геномики и временных рядов. DaRoPE стоит включить в раннее сравнение вместе с RoPE и HoPE, если продукту нужно извлекать связанные сведения из удалённых частей контекста или обрабатывать повторяющиеся мотивы с переменным интервалом.
Для продукта поверх закрытого API практического переключателя нет: позиционное кодирование задаёт поставщик модели. Авторы обучали модели с DaRoPE с начала процесса; работа не показывает способ заменить RoPE в уже готовых весах без дополнительного обучения.
DaRoPE также отличается от YaRN по моменту применения. YaRN растягивает частоты при запуске и должен знать целевую длину, тогда как DaRoPE учится вместе с моделью и затем не требует менять вычисления под новый размер контекста. Это упрощает эксплуатацию одной модели на запросах разной длины.
Для обычной текстовой модели, которая работает внутри обучающего окна, статья не даёт причины срочно менять архитектуру: там DaRoPE в основном сохраняет качество сильных альтернатив. Аргумент становится весомее, когда дальние связи влияют на результат, а переобучение модели уже входит в план проекта.
Источники
Иллюстрация: рисунок из статьи «RoPE is Dead, Long Live RoPE: Towards Scalable Data-aware Positional Encodings», Jarod L\'evy, Mathurin Videau, Jad Yehya и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


