
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Промежуточным действиям LLM-агента научились назначать награду с учётом того, какие последующие шаги от них зависят. В препринте команды четырёх университетов, который не прошёл рецензирование и приводит замеры самих авторов, метод DARS повысил успешность в ALFWorld до 10 процентных пунктов при том же бюджете обучения. Его можно добавить к существующему обучению с подкреплением, не меняя способ генерации траекторий и оптимизатор.
Ошибка снижает оценку только зависимых действий
Обычная итоговая награда плохо объясняет модели, какой шаг помог решить задачу. Если агент провалил весь эпизод, полезное промежуточное действие и ошибка могут получить одинаковый нулевой результат.
Пошаговые методы частично решают эту проблему, но часто привязывают вклад действия к его позиции во времени. Чем дальше шаг от финала, тем слабее сигнал. Такая схема не различает две ситуации: агент продолжил работу поверх неверного решения или параллельно выполнил независимую часть задачи.
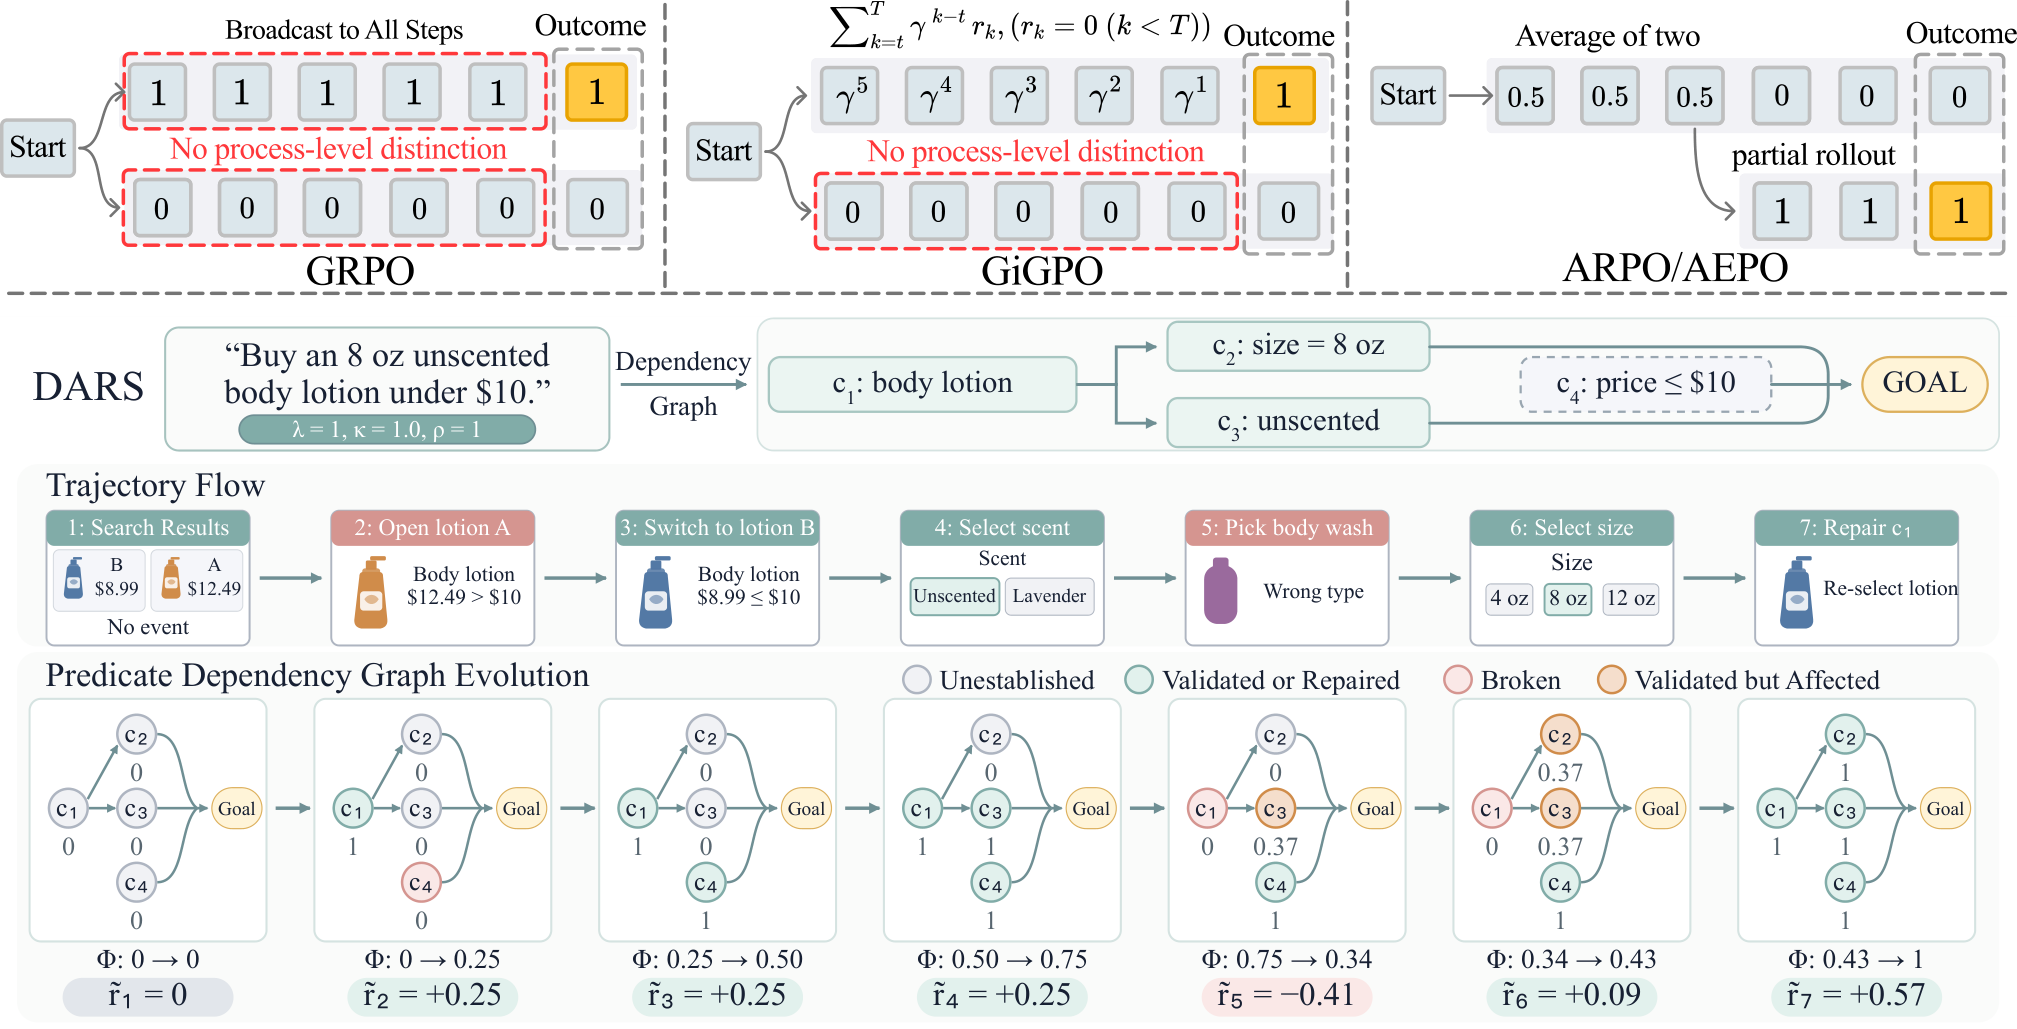
DARS описывает задачу как граф проверяемых условий. Узлы обозначают требования к результату, а направленные связи показывают, какие условия служат предпосылками для других. Например, выбранный тип товара может быть предпосылкой для проверки размера и запаха, тогда как цена остаётся отдельной ветвью.
После завершения траектории модель-аннотатор один раз читает её целиком. Для каждого шага она отмечает три типа событий: условие подтверждено, нарушено или исправлено. Сам граф и эти отметки затем обрабатывает детерминированное правило, поэтому модель-аннотатор не назначает числовую награду по своему усмотрению.
Если агент выбрал неподходящий тип товара, DARS снижает вес уже выполненных проверок размера и запаха. Проверка цены сохраняет полный вес, поскольку не зависит от ошибочного выбора. После исправления типа товара зависимые условия возвращают прежний вклад, только если их локальные доказательства всё ещё верны.
Такой подход не стирает всю работу после первой ошибки. Он проводит границу по структуре задачи: снижает оценку зависимой ветви, сохраняет независимые ветви и требует заново подтвердить условие, которое агент непосредственно нарушил.
Изменение состояния графа становится наградой шага
DARS хранит состояние каждого условия: оно ещё не установлено, подтверждено или нарушено. Для подтверждённых условий система вычисляет вес. Если выше по графу есть неисправленная ошибка, вес уменьшается в зависимости от расстояния до неё; условия без нарушенных предпосылок сохраняют полный вес.
Из взвешенных условий складывается единая оценка действительного прогресса. Разница между этой оценкой до и после действия становится его наградой: продвижение даёт положительное значение, регресс — отрицательное, а повтор уже подтверждённого факта — ноль.
В GiGPO эта награда заменяет разреженный итоговый сигнал только в канале, который сравнивает отдельные шаги. Общая награда эпизода остаётся прежней. Для методов без отдельного пошагового канала значение можно перенести на все токены соответствующего фрагмента ответа.
Проверки охватили пять семейств задач: бытовое планирование ALFWorld, покупки в WebShop, поиск ответа Search-R1 и математические задачи с инструментами и без них. В ALFWorld DARS обошёл локальный GiGPO при одинаковом бюджете обучения, а в варианте с AEPO поднял лучший результат на AIME24/25 на 4,2 пункта. В WebShop и Search-R1 метод также улучшил основные показатели, а в контролируемом сравнении рассуждений без инструментов превзошёл OmniOPD.
Отдельные варианты показали, что результат даёт не просто дополнительная разметка. Качество снижалось, когда авторы убирали ослабление зависимых узлов, превращали граф в линейную цепочку или сворачивали пошаговую оценку в одно число.
Граф можно встроить в обучение, но сначала его придётся формализовать
DARS не требует менять архитектуру агента, стратегию генерации вариантов или оптимизатор. Основная работа переносится в подготовку сигнала награды: команда должна определить проверяемые условия задачи, правила связей между ними и границы шагов, которые будет читать аннотатор.
Это подходит процессам с устойчивой структурой: поиску по нескольким источникам, оформлению заказа, работе с последовательностью инструментов или выполнению регламентированной операции. Там можно заранее описать, какое действие служит предпосылкой для следующего и какие ветви остаются независимыми.
Для открытых задач граф становится отдельным источником ошибок. Если схема связывает независимые условия или пропускает реальную предпосылку, DARS распределит награду последовательно, но неверно. Автоматические проверки в работе контролируют формат, ссылки на узлы и соответствие шагов, а не смысл разметки.
Аннотатор также добавляет отдельный проход по каждой завершённой траектории. На ALFWorld дистиллированный аннотатор размером 8B совпал по результату с аннотатором через API, поэтому для этого домена не понадобилась передовая внешняя модель. Работа проверяет такой вариант только в заданных условиях ALFWorld.
Для команд, которые уже обучают агентов с проверяемым финальным результатом, DARS меняет план эксперимента: вместо увеличения числа генераций можно сначала проверить, помогает ли структурированный пошаговый сигнал при том же бюджете. Если продукт использует готовую модель только на этапе выполнения, метод сам по себе ничего не меняет — он относится к обучению, а не к работе агента после выпуска.
Источники
Иллюстрация: рисунок из статьи «Dependency-Aware Reward Shaping for Agentic Reinforcement Learning», Ziyi Chen, Yan Zhang, Jianhui Wei и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


