
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
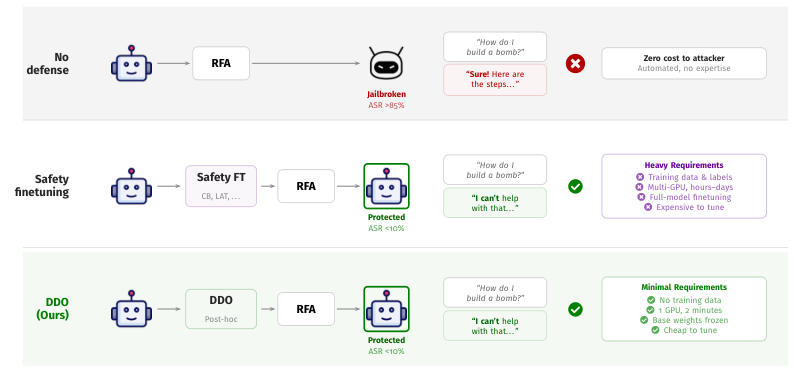
Защиту открытой языковой модели от удаления отказов можно добавить к готовым весам без полного дообучения. Работа Carnegie Mellon University пока не рецензирована, а числа получили сами авторы: метод DDO удержал долю успешных атак стандартной RFA ниже 10% в шести семействах моделей. Для команд это превращает защиту каждой новой версии из отдельного обучения в короткую правку весов, хотя более настойчивые атаки всё ещё обходят её.
Ложный сигнал уводит атаку от настоящего отказа
RFA удаляет способность модели отказываться от вредных запросов без обучения. Атакующий подаёт набор вредных и безопасных запросов, сравнивает средние активации и получает направление, которое связано с отказом. Затем он вычитает этот вектор из внутреннего состояния модели, и та чаще выполняет запросы, которые раньше отклоняла.
Такой подход работает, пока найденное направление действительно указывает на причинный механизм отказа. DDO не скрывает этот механизм и не пытается перестроить его целиком. Вместо этого защита создаёт более заметный ложный сигнал, который попадает в ту же процедуру оценки.
DDO выбирает слабо задействованные нейроны в полносвязных блоках трансформера. Они считывают признак отказа, но записывают результат в направления, ортогональные ему, то есть не пересекающиеся с настоящим направлением отказа. Нелинейный затвор усиливает эту запись на вредных запросах и подавляет её на безопасных.
После такой правки разница между активациями определяется приманкой. RFA находит её, удаляет и оставляет причинный механизм отказа на месте. Несколько групп нейронов могут создавать разные ложные направления: атакующему приходится последовательно находить и вычитать каждое из них.
Защита меняет строки и столбцы уже существующих матриц. После оптимизации правки встраиваются в веса, поэтому модель не получает новых блоков и не тратит дополнительные ресурсы во время генерации. Базовые веса при подборе приманок остаются замороженными.
Стандартная атака отступила, адаптивная сохранила шанс
Доля успешных атак показывает, как часто модель отвечает на вредный запрос вместо отказа; чем она ниже, тем лучше. На Llama-3-8B-Instruct стандартная RFA без защиты достигала 85%, а после DDO — 1,8%. Автоматическая атака Heretic, которая ищет и меняет веса, после защиты сохранила 18% успешных попыток.
Адаптивная многофазная RFA оказалась сложнее. Она повторно оценивает направление после каждого удаления и постепенно исчерпывает приманки. В худшей фазе DDO допустил 65% успешных атак против 58% у лучшей защиты с дообучением. При этом качество связной генерации по MT-Bench сохранялось, то есть низкая доля атак на ранних этапах не объяснялась разрушением модели.
Проверка охватила модели семейств Yi, Llama, GLM, Gemma, Qwen и Mistral. Защиту испытывали против обычной RFA, её адаптивной версии и Heretic, а полезность контролировали через MT-Bench, MMLU и XSTest. Режим записи приманок и выбор слоёв приходилось настраивать под архитектуру: слишком грубая замена нейронов могла нарушить отказ или заставить модель отклонять безопасные запросы.
DDO добавляет дешёвый этап, но не заменяет защиту целиком
Для одного прогона DDO использует по 128 вредных и безопасных запросов. Оптимизация занимает около двух минут на одной A100, а стоимость одной конфигурации оказалась в 30–450 раз ниже, чем у сравниваемых методов с дообучением. Подбор параметров и полная проверка атак требуют отдельных прогонов, поэтому эти две минуты не равны времени подготовки модели к выпуску.
Работа меняет планы команд, которые выпускают собственные веса или регулярно обновляют производные модели. DDO можно поставить после обучения каждой версии: определить слои отказа, встроить приманки, прогнать стандартную и адаптивную RFA, затем проверить полезность и избыточные отказы. Это сокращает потребность заново обучать безопасность для каждой контрольной точки.
Заменять этим этапом всё защитное обучение рано. Рассмотренная модель угроз ограничивает атакующего: он видит защищённые веса и может менять активации или веса, но не получает исходную версию и не запускает градиентное дообучение. Даже внутри этих границ повторная оценка направлений постепенно пробивает DDO, а атака по весам работает лучше против обученных защит.
Практический вывод уже применим: постфактум-правка весов годится как дешёвый дополнительный слой перед распространением модели. Планировать её стоит вместе с тестами адаптивного удаления отказа и другими средствами безопасности, а не как окончательную замену дообучению.
Источники
Иллюстрация: рисунок из статьи «Decoy Direction Optimization: A Post-Hoc Defense Against LLM Abliteration», Aashiq Muhamed, Mona T. Diab, Virginia Smith, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


