
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Глубокие генераторы синтетических таблиц почти нигде не дали измеримого преимущества перед простыми методами. В препринте VIT Bhopal University, который не прошёл рецензирование, а все числа получил сам автор, глубокие модели не обошли лучший простой метод в 23 из 24 сравнений. Команде с небольшим табличным набором нет смысла начинать с CTGAN, TVAE или TabDDPM, если SMOTE решает ту же задачу.
Автор сравнил CTGAN, TVAE и TabDDPM с независимым подбором значений по столбцам, гауссовой копулой и двумя вариантами SMOTE. Генераторы обучали на восьми открытых наборах размером от 200 до 20 000 строк. Качество измеряли по площади под ROC-кривой: классификатор учился на синтетических данных, а проверялся на настоящих.
Каждый метод получал одинаковый бюджет в 20 попыток настройки, после чего результат проверяли на пяти случайных инициализациях. Единственный случай, когда глубокая модель вышла вперёд сильнее разброса между запусками, не повторился на следующих размерах того же набора. При этом один запуск TabDDPM занимал в среднем 104,3 секунды против 0,1 секунды у SMOTE на использованном процессоре.
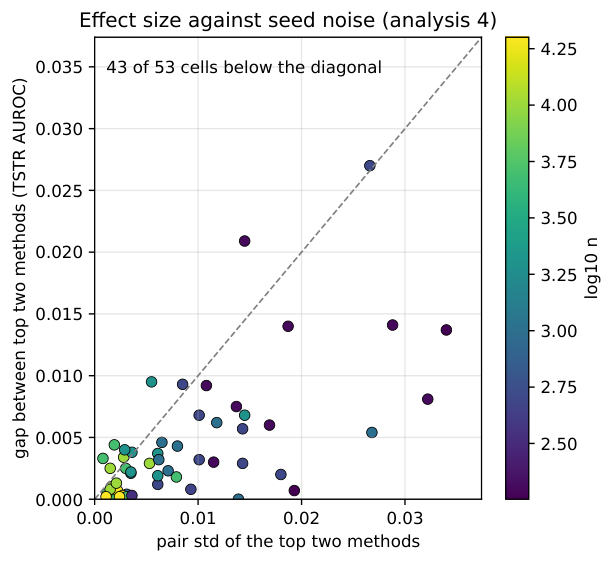
Различия между лидерами часто слишком малы для уверенного выбора: в 81% сочетаний набора и размера разрыв между двумя лучшими методами оказался меньше разброса между случайными запусками. Поэтому работа не доказывает, что простые генераторы всегда лучше, но показывает, что глубокая модель не оправдывает дополнительные вычисления только своим местом в таблице бенчмарка.
Проверка охватывает только двоичную классификацию, фиксированный набор классификаторов и обучение на одном процессоре. Отдельный прогон на изначально небольших клинических наборах дал иной порядок методов, чем искусственно уменьшенные крупные таблицы. Порог нельзя считать универсальным: в изученном диапазоне глубокие генераторы не нашли устойчивого преимущества, а уменьшенная большая таблица не всегда заменяет реальные малые данные.
Источники
Иллюстрация: рисунок из статьи «Below what training size do deep tabular generators stop beating trivial baselines? A preregistered benchmark on a size ladder of clinical and standard datasets», Shivam Shrivastava, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


