
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
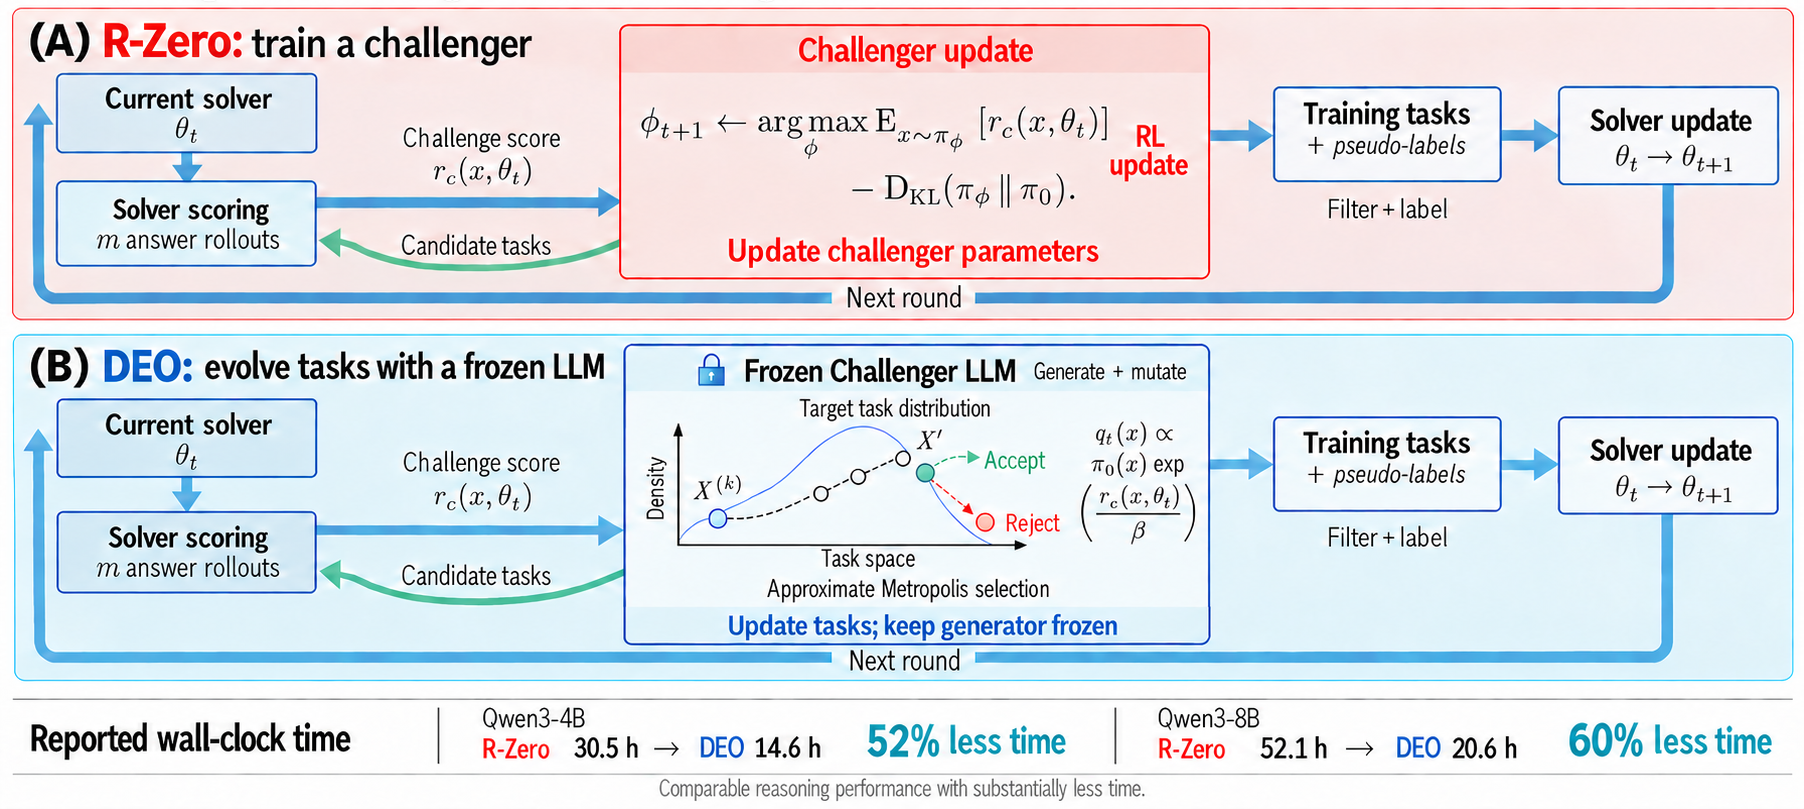
Генератор задач для самообучения LLM можно оставить замороженным: сложность учебного набора будет подстраивать сама обучаемая модель. В препринте Accenture, Center for Advanced AI и Georgia Institute of Technology, который не проходил рецензирование, все числа получили сами авторы. На математических задачах метод DEO показал результат на уровне R-Zero, но потребовал примерно вдвое меньше времени.
Сложность задач регулирует модель, которая их решает
В обычном саморазвивающемся обучении работают две модели. Модель-соперник предлагает задачи на границе возможностей, а модель-решатель учится отвечать на них. После каждого раунда приходится обновлять обе модели, хранить два набора параметров и поддерживать два цикла обучения.
DEO убирает первый цикл. Замороженная LLM создаёт начальный набор задач и предлагает их структурные изменения. Решатель несколько раз отвечает на каждую новую версию, после чего система оценивает, насколько согласованы ответы и не повторяется ли одна и та же формулировка.
Если изменённая задача оказалась сложнее для текущего решателя, система чаще оставляет её в наборе. Более простые варианты тоже могут пройти отбор, поэтому учебный набор не сводится к нескольким самым трудным примерам. Степень отклонения от исходного распределения задач ограничивает штраф: чем сильнее новый набор от него отличается, тем менее выгодным становится такое изменение.
Затем решатель создаёт для отобранных задач несколько ответов. Их агрегированный вариант становится псевдоразметкой, по которой обновляют только решатель. Генератор не предоставляет правильные ответы и не получает доступ к градиентам или параметрам обучаемой модели.
Практический алгоритм лишь приближает целевое распределение. Он использует шумные оценки по конечному числу ответов и упрощённый вероятностный отбор, в котором пропущена трудно вычислимая поправка на вероятность прямого и обратного изменения задачи. Теоретическая гарантия относится к идеальному варианту, который умеет точно выбирать задачи из нужного распределения.
Половина времени без потери средней точности
DEO проверили на Qwen3 и OctoThinker: трёх базовых моделях размером от 3 до 8 млрд параметров. Обучение шло три раунда, а итоговую точность усредняли по семи математическим наборам, включая MATH-500, GSM8K и AIME.
По сравнению с R-Zero метод сократил полное время обучения на 52–61%. Средняя точность после последнего раунда оказалась выше на 0,72–2,36 процентного пункта в зависимости от модели. При этом преимущество не сохранялось на каждом отдельном раунде и каждом тесте.
Сравнение с вариантом без направленного изменения задач показывает, откуда взялся результат. DEO чаще помещал в учебный набор примеры средней сложности: решатель уже мог найти для них согласованный ответ, но ещё не отвечал уверенно. После фильтрации таких задач также оставалось больше.
Условия сравнения не полностью симметричны: DEO и упрощённый вариант начинали с одинаковых пулов кандидатов, тогда как запуски R-Zero для Qwen использовали более крупные исходные наборы. Эксперимент охватывает математические рассуждения; перенос на общие тесты зависел от модели и конкретного набора.
Что меняется в плане обучающей системы
Команде, которая строит адаптивную генерацию данных, больше не обязательно разворачивать второй обучающий контур. Достаточно разделить систему на замороженный генератор, оценку сложности текущим решателем и обновление самого решателя. Это упрощает хранение состояния и сокращает число компонентов, которым нужен доступ к параметрам.
Генератор можно вынести во внешний API. В отдельном опыте Claude Haiku 4.5 создавал и изменял задачи для локального Qwen3, а псевдоразметку по-прежнему формировал сам Qwen3. Такой вариант улучшил обе сводные оценки относительно локального генератора, хотя выигрыш распределился по тестам неравномерно.
Это меняет выбор между локальной и закрытой моделью: качество генератора задач можно повышать без переноса внутренних данных обучения в его параметры и без тонкой настройки внешней LLM. В API уходят формулировки задач, но не роль учителя — ответы внешней модели не становятся целевыми.
Экономия времени не гарантирует меньшую денежную стоимость. В работе не сопоставлены расходы на внешний API и локальные вычисления, поэтому их придётся считать для конкретного объёма мутаций и ответов решателя.
DEO подходит как замена обучаемому сопернику, когда задачи можно автоматически изменять, а сложность — оценивать по поведению решателя. Теория обещает устойчивое снижение неопределённости рядом с исходным распределением, но не обучение принципиально новым ответам: метод прежде всего закрепляет то, что начальная модель уже способна получить большинством попыток.
Источники
Иллюстрация: рисунок из статьи «Direct Self-Evolving Optimization: Evolving LLMs without Challenger Training», Yuyang Deng, Yu Wang, Jiayun Wang, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


